FPGA 原型验证专题 32:DDR/存储接入原型——真实 DRAM、降速模型、替换存储与容量墙的三种样式
更新时间:2026-09-13。本文是原型外围姊妹系列第七篇、模块 C 第二篇。02 多 FPGA 原型系统 ASIC 分区/TDM第八章讲过存储映射的概念,30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算把 DDR 初始化列为 FSBL 最常见卡点,31 速率适配器 Speed Adapter 弹性FIFO/两种范式给了速率适配的通用原理。本篇把"存储怎么接进原型"展开为三种可落地样式与取舍。
这一篇在体系里的位置
没有可用的主存,CPU 连大点的裸机程序都跑不动,更别说 Linux。存储接入在原型上的特殊性来自三个互相牵制的约束:
- 真实 DDR 是高速、物理时间敏感的接口(31 速率适配器 Speed Adapter 弹性FIFO/两种范式的速率锁死问题在 DDR 上最典型:刷新是绝对物理时间,训练要对准亚纳秒窗口);
- FPGA 内部存储宝贵且容量小(BRAM/URAM 总量相对 GB 级 SoC 内存可忽略);
- 多 FPGA 分割后,DUT 侧访存可能跨片、被 TDM 拉长,而真实 DRAM 的延迟模型完全不同。
于是工程上不是"一种正确接法",而是按阶段和负载在三种样式间选择/组合。
本文要回答的问题
- 三种存储接入样式各自结构、容量、保真度、成本、适用阶段?
- 真实 DDR 在慢原型上为什么训练和刷新必须特殊处理?常见 bypass/重定时手段是什么?
- 用 FPGA 片上存储建模时,哪些内存行为被改变(容量、延迟、刷新、bank 冲突、随机性)?会误导什么结论?
- 容量装不下完整 SoC 内存映射时怎么分层/裁剪/别名?
- OS 启动、驱动验证、架构性能、长稳 soak 分别该选哪一样式?
- 怎么把"存储模型引入的延迟/带宽变化"和 DUT 自身性能问题区分开?
一、三种样式总览
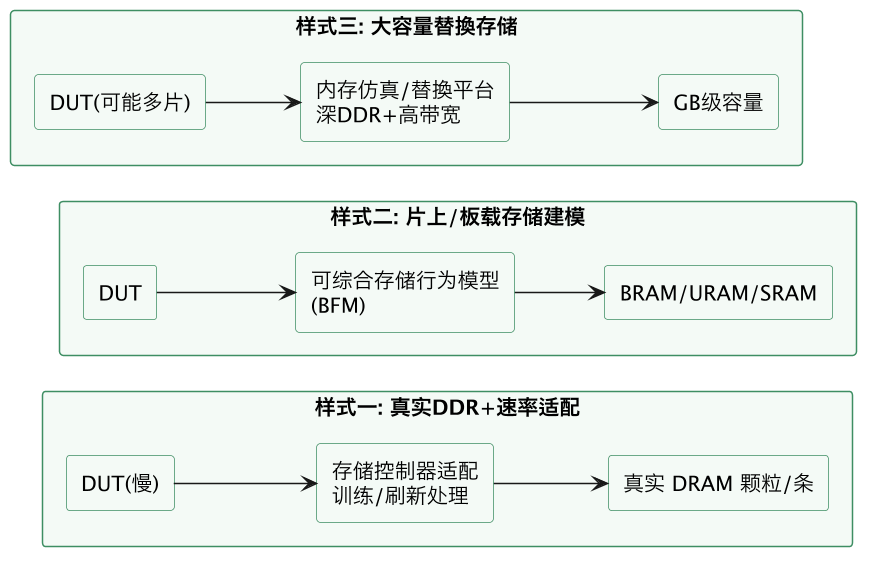
| 维度 | 样式一:真实 DDR+适配 | 样式二:片上/板载存储建模 | 样式三:大容量替換存储 |
|---|---|---|---|
| 容量 | 真实容量(GB 级) | 小(MB 级,受 FPGA 资源限) | 大(数百 MB~GB+) |
| 数据保持/刷新 | 真实(绝对物理时间) | 建模为不掉电、无刷新 | 通常建模、无真刷新约束 |
| 时序保真 | 最高(真实 tCAS/tRCD/tRFC…) | 低:固定/简化延迟,无 bank 冲突细节 | 中:可配延迟模型,非真实颗粒 |
| 带宽 | 受慢侧与适配限制 | 高且确定(片上),但位宽/端口受限 | 高(专用高带宽平台) |
| 训练/PHY | 必须处理(bypass/重训练) | 无 PHY/训练 | 无真 PHY |
| 成本/复杂度 | 中高(子卡/PHY IP/时序工作) | 低(综合即可) | 高(专用设备/IP 授权) |
| 典型阶段 | 后期 ICE、软件/OS、互通 | 早期 bring-up、定向功能 | 大规模软件、完整内存映射 |
二、样式一:真实 DDR + 速率适配
让 DUT 的存储控制器(或其替换版)最终驱动真实 DRAM 颗粒/内存条,保真度最高,软件看到的容量、刷新、异常(ECC、位翻转)都是真的。它正是 31 速率适配器 Speed Adapter 弹性FIFO/两种范式(协议感知降速桥)在存储上的落地,难点集中在训练与定时:
**1) PHY 训练与读校准。**DDR PHY 上电要做写平整(write leveling)、读训练(read training/gate)、VREF/DQS 对齐,把选通窗口校到亚纳秒级。这些流程假设控制器和 DRAM 工作在标称频率比。DUT 降频后,要么:
- 训练 bypass/免训练配置:用商用原型存储 PHY/控制器替换 IP 自带的、在原型频率下经验证的初始化序列,跳过依赖目标频率比的精细训练(很多原型存储子卡直接提供"已知良好"配置);
- 在适配侧重定时:由速率适配桥用真实速率与 DRAM 完成训练,DUT 侧只发事务,物理定时完全由桥承担——这是更干净的分层,DUT 甚至不直接接触 PHY;
- 提高存储子系统时钟:把存储控制器/PHY 单独放在一个仍能跑到真实/接近真实速率的时钟域,与降频的 DUT 核之间用异步 FIFO 解耦(混合频率方案)。
**2) 刷新是绝对物理时间,不能整体降频。**DRAM 必须在 tREFI(如 7.8µs 量级的真实时间)内刷新所有行。如果控制器随 DUT 一起降频、却仍按"每 N 个控制器周期刷新一次"配置,N 个慢周期对应的真实时间会远超 tREFI→bit 丢失。处理:刷新定时器要么用真实速率时钟域(在适配/PHY 侧独立产生),要么按降频比例重算刷新周期计数,保证其对应的真实时间仍满足数据保持要求。这是 DDR 上原型最隐蔽也最致命的一类错(偶发、长跑才出现、像随机内存损坏)。
3) 保真度仍有边界。即便接了真实颗粒,原型测得的访存延迟/带宽也混合了跨片 TDM 和适配桥延迟,不等于芯片存储子系统性能;目标工艺 PHY 的信号完整性/眼图同样不能由原型平台的 PHY 代表。真实 DDR 样式的价值是功能、软件、容量、真实刷新/ECC 行为,不是性能签核。
适用:后期 ICE、OS/rootfs 需要大内存、要跑真实存储密集负载、要验证刷新/ECC/热管理相关软件逻辑。
三、样式二:FPGA 片上/板载存储行为建模
最早、最简单的样式:把 ASIC 的 SRAM/DRAM 用可综合存储模型替换,底层落到 FPGA BRAM/URAM 或板载 SRAM(11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY会把存储编译器宏单元替换成 FPGA RAM)。可以在模型前面加一个可综合的存储 BFM,模拟期望的延迟与握手。
优点:无 PHY、无训练、无刷新,上电即用、时序确定、跨片少(若放在访问它的逻辑同片),是 bring-up 第一阶段的默认选择(71 篇的早期主内存)。
但它改变了多项内存行为,必须在结论里标注:
- **容量小。**单片 FPGA 的 BRAM/URAM 通常只够几 MB~几十 MB 有效存储,装不下完整 SoC 内存映射(见第五节容量墙)。
- **延迟模型不真。**片上 RAM 延迟 1~数拍且固定,真实 DDR 有 tCAS/tRCD/tRP/tRFC、bank/row 冲突、刷新占用、读写翻转、总线周转。依赖访存延迟差异做的性能优化、时序微调在这一样式上全部失真。
- **带宽与端口结构不同。**BRAM 端口数、位宽、时钟与 DDR 控制器的突发/调度完全不同,测到的带宽偏高且平滑,会掩盖总线拥塞和 bank 并行度问题。
- **无刷新、无 DRAM 特有错误。**刷新导致的周期性延迟抖动、retention 错误、ECC 事件无法复现;反过来也不会因刷新配置错而丢数据(所以它能"掩盖"样式一里那类刷新 bug——刷新逻辑必须在样式一上验)。
- **随机性差异。**真实 DRAM 上电内容不确定,BRAM 可初始化为已知值,可能让"未初始化内存"类软件 bug 被掩盖(可刻意初始化为随机/毒值模式来暴露这类问题)。
适用:早期点亮、驱动状态机、OS 之前的裸机/RTOS、不依赖真实容量与时延的功能验证、需要严格确定性和快速复现的调试。
四、样式三:大容量替換存储 / 内存仿真平台
当软件需要接近真实的容量(完整 Linux + 大 workload,内存映射 GB 级),片上 BRAM 远远不够,又不便或不必在该阶段上真实 DDR 时,使用大容量替換存储:在 FPGA 板上集成深 DDR(板载大容量 DRAM 充当"仿真内存"),或用专用的内存仿真/协议加速设备,通过高带宽接口(多根宽总线、SerDes、光口)连到原型,对 DUT 呈现一个大容量、可配延迟的内存。
它是前两种样式的折中:
- 容量可达 GB 级,装得下完整内存映射和 rootfs/工作集;
- 没有真实 DDR PHY 的训练麻烦(替換平台自己管理它的 DRAM,对 DUT 暴露的是事务/简化协议);
- 延迟可通过可配的延迟模型逼近目标(插入可编程潜伏期、模拟 bank 冲突/刷新停顿),但仍是模型,不是目标颗粒;
- 带宽和往返延迟受替換平台接口限制,且若该存储被多片 FPGA 共享,跨片访问会叠加 TDM,成为系统瓶颈。
工程要点:地址映射与带宽预算。多个 DUT master(多核、DMA、加速器)汇聚到替換存储时,要明确地址分片、仲裁、带宽上限;若多片 FPGA 都要访问同一替換存储,互联(13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频)带宽往往先于容量成为天花板,需在分区时让访存最频繁的主设备尽量就近、或为存储做多口/多通道分布。
适用:中后期大规模软件与完整 OS、需要大内存但可接受建模延迟、多团队共享同一存储映像。
五、容量墙:装不下内存映射怎么办
SoC 地址空间常有 4GB+,但任何时刻软件真正用的物理页/工作集远小。当原型可用物理存储小于内存映射,常见组合手段:
- 分层存储(hierarchical / 二级存储):BRAM 作"高速一层"放启动/热数据,大容量替換存储/板载 DDR 作"二层",由可综合的地址译码+分页桥把访问路由到对应层,类似一个由硬件做的 TLB/分页。冷页落二层、热页提升到一层。
- 地址别名与窗口化(windowing):把大块外部存储通过一个小的物理窗口映射进 DUT 地址空间,软件/桥按窗口换页访问(经典 bank-switch 思路),用于 bring-up 阶段够用即可。
- 裁剪内存映射:原型专用 DTB/链接脚本只声明实际实现的内存区(71 篇
*-proto.dts),砍掉未用 bank、保留段;软件探测到的内存上限按原型给。这是最省事也最常用的办法。 - 稀疏实现:只实现软件实际触碰的地址区间,其余访问落到一个"默认从设备"(返回固定 pattern 或触发可观测错误),避免悬空总线访问死等。
- 多片分布:把内存按访问局部性分布到多片 FPGA 的板载存储,减少跨片访存(同时要更新地址译码与分区,12 多 FPGA 分区算法 割集/容量/图划分)。
务必让软件通过统一配置(DTB/内存表)看到的映射与硬件实际实现一致,否则会出现"链接到不存在的内存"这类极难排查的启动失败。
六、按负载选样式与性能归因
| 负载 | 推荐样式 | 理由 |
|---|---|---|
| 首次点亮、裸机/驱动状态机 | 二(片上建模) | 免训练、确定、最快可用 |
| RTOS/小内存 Linux、功能回归 | 二或三 | 视容量需求升级 |
| 完整 Linux + 大工作集/rootfs | 三或一 | 容量前提 |
| 刷新/ECC/真实存储异常软件 | 一(真实 DDR) | 只有真颗粒才有 |
| OS 启动时间/架构性能外推 | 三配延迟模型,或一并行记录 | 需可扣除存储模型延迟 |
| DDR PHY 电气/眼图/BER | 都不能回答 | 属 ASIC PHY 签核,原型不代表 |
性能归因纪律(呼应 72 篇保真度边界):访存慢时先分清三段——①DUT 内部/跨片 TDM;②适配/替換存储引入的延迟;③真实存储子系统行为。方法是在 DUT 内存接口处用周期计数器测"发出请求到接收数据的拍数",并分别在"片上 BRAM 后端"和"目标后端"各测一次:两者差值就是存储后端引入的开销,应在架构性能外推时扣除(详见后续 E3 篇)。不要把替換存储的高延迟写进芯片性能结论,也不要把片上 BRAM 的零刷新低延迟当成芯片会有的好结果。
七、接入检查清单
- 选定样式并在验证计划写明该样式的保真度边界;
- 真实 DDR:参考时钟/PHY/训练 bypass 或适配重定时就绪,刷新按真实时间核对,反复上下电训练稳定;
- 片上建模:初始化模式(是否毒值化)、容量上限、延迟模型与软件 DTB 一致;
- 替換存储:地址映射、带宽预算、多 master 仲裁、跨片分布评估;
- 容量墙:DTM/链接脚本/稀疏默认从设备/窗口或分页方案就位;
- 性能:在 DUT 内测点取周期数,标定并记录后端延迟供外推扣除;
- 存储版本、初始化映像、刷新/延迟参数随 build_id 锁定(20 比特流烧录与四方版本一致 manifest/门禁)。
七、内存容量墙:装不下镜像时的系统级对策
原型板载 DRAM 容量常常小于真实芯片配的容量(高端应用处理器配 8/16/32GB,原型板可能只有几 GB,且还要被多片 FPGA 分)。当软件镜像、文件系统、GPU/视频缓冲、测试数据加起来超过可用容量,单纯等软件团队"裁剪"往往不够,需要系统级对策。这也是 71 篇启动能走多远的硬边界。
**1) 先建一张"内存用途账"。**把物理内存按用途列出:固件/内核常驻、页缓存、各 IP 的 DMA 缓冲(视频/摄像头/显示的分辨率×帧率×缓冲个数往往是大头)、共享内存、测试/注入数据、rootfs(是载入内存还是挂载在外部存储)。很多"容量不足"其实是把默认 IP 缓冲按满规格(4K 三缓冲)分配,而验证目标只是 720p——降规格立刻释放一大块。
**2) 分级存储,把不常用数据移出原型内存。**rootfs 放 NFS/网络存储或真实 SD/NVMe(71、74 篇),只把必需运行的内容留在内存;测试激励/参考帧/大文件放主机,按需经事务处理器/以太网注入(21 激励注入与软硬协同 co-model/transactor、25 真实激励驱动 ASIC 签核 SAIF 反标/边界);视频类用分辨率/帧率/缓冲数联动裁剪(75 篇等时分析)。
**3) 用软件手段压缩占用。**内核裁剪(去掉不用的驱动/子系统、模块按需加载)、strip 符号到主机(目标上放 stripped 镜像,调试符号留 GDB 服务器侧)、缩小 initramfs、页面压缩、关闭不必要的预留区;调试期把日志/ramdump 区缩小或改放主机。
**4) 调整内存映射而不是硬塞。**必要时把某些地址段映射到"外部事务后端"而非真内存(样式二的延伸)——对软件表现为一块较慢的内存,只放可容忍慢速的数据;或者重新分区让需要大缓冲的 IP 落在挂了更大 DRAM 的那片 FPGA 旁(容量与分区联动,12 多 FPGA 分区算法 割集/容量/图划分)。
**5) 显式记录容量边界并设测试规模。**在平台状态页写明"本原型可承载的最大镜像/分辨率/并发会话",据此定义测试用例规模,避免软件团队按真机规模排测试、跑到半夜 OOM 才发现。容量边界是平台能力矩阵(70 篇)的一行,变更要随板卡/比特流版本更新。
**一个提醒:容量墙和带宽墙要分开算。**有时容量够但带宽不够(真 DRAM 降速,样式一),有时带宽够但容量不够(模型够快但地址空间小)。两者症状不同:带宽问题表现为整体慢/实时流 underrun,容量问题表现为加载失败/OOM/分配失败;对策也不同,别混为一谈。
与系列及现有篇目的链接
- 速率适配母版:31 速率适配器 Speed Adapter 弹性FIFO/两种范式
- OS 启动与 DDR 卡点:30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算
- 存储宏单元替换:11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY
- 分区/跨片访存:12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频
- 背景与性能/活动:02 多 FPGA 原型系统 ASIC 分区/TDM、24 活动覆盖率与性能调试闭环 热点/瓶颈/回放
总结
一句话总结:存储接入不是只有"接真 DDR"一条路,而是按阶段和负载在三种样式间选择——样式一用协议感知降速桥把慢 DUT 与满速真实 DRAM 解耦,容量、刷新、ECC、bank 行为最真,适合后期 ICE 和 OS,但必须解决 PHY 训练(用免训练配置/桥侧重定时/存储子系统独立高速时钟域),尤其要记住刷新 tREFI 是绝对物理时间、控制器随 DUT 降频后若仍按周期数刷新必然丢数据,刷新定时必须挂真实时间域或按降频比例重算,且即便接真颗粒,端到端延迟/带宽混了跨片与桥开销、PHY 电气也不代表目标工艺;样式二用 BRAM/URAM 加可综合存储 BFM 行为建模,免训练免刷新、确定快速,是早期点亮默认选择,但容量小、延迟固定偏乐观、无 bank 冲突与刷新抖动、还会用已知上电值掩盖未初始化内存 bug,所以不能用它回答任何性能或 DRAM 特有行为问题;样式三用板载深 DDR 或专用内存仿真平台作大容量替換存储,容量够装完整映射与工作集、延迟可建模、没有真 PHY 麻烦,但带宽与跨片互联常先于容量成为瓶颈,需按访存局部性做多口/多通道分布;当物理存储小于 SoC 内存映射时用分层二级存储、窗口换页、原型专用 DTB 裁剪映射、稀疏默认从设备、多片分布组合解决,并保证软件看到的映射与硬件实现严格一致;性能归因时在 DUT 内存接口用周期计数、通过切换片上后端与目标后端的差值标定存储后端引入的额外延迟并在外推时扣除,绝不能把替換存储的慢或 BRAM 的快写成芯片结论——刷新/ECC 只信真实 DDR,启动与功能从片上建模起步,大规模软件靠大容量替換,是一条几乎通用的节奏。