UVM compare 策略字段跳过:UVM_DEEP/SHALLOW/REFERENCE 与 NOPRINT/NOCOMPARE 标记
更新时间:2026-09-29。
uvm_object::compare()是 scoreboard 比对期望与实际事务的主力武器,UVM compare 与 do_compare:自定义比较钩子 讲了比较钩子怎么写;这一篇只盯一个更基础的问题:哪些字段参与比较、按什么深度比较、哪些字段干脆跳过。答案就藏在uvm_field_*宏的第三个参数——策略与标记里。字段复制语义的对照阅读见 SV 对象拷贝:深拷贝与浅拷贝,两者用同一套 DEEP/SHALLOW 词汇,初学者很容易混。
本文要回答的问题
compare()默认比什么?为什么说「全字段深比」往往不是你要的?UVM_DEEP、UVM_SHALLOW、UVM_REFERENCE三种策略到底差在哪?UVM_NOCOMPARE、UVM_NOPRINT这些标记怎么让字段退出比较或打印?- 一个事务类里哪些字段该跳过比较,哪些字段跳过就是事故?
一、compare 的默认行为与「字段注册表」
uvm_object::compare(rhs) 本身不做任何逐字段比较,它读的是你在 uvm_field_* 宏里登记的字段注册表。每写一个宏,就向表里塞一行:字段名、字段句柄、策略与标记。
class axi_txn extends uvm_sequence_item;
  rand bit [31:0] addr;
  rand bit [31:0] data;
  rand bit [3:0]  len;
  bit [63:0]      timestamp;   // 采样时刻,两次观测必然不同
  uvm_event       done_ev;     // 句柄型字段,无数据意义

  `uvm_object_utils_begin(axi_txn)
    `uvm_field_int(addr,      UVM_DEFAULT)            // 参与比较
    `uvm_field_int(data,      UVM_DEFAULT)
    `uvm_field_int(len,       UVM_DEFAULT)
    `uvm_field_int(timestamp, UVM_NOPRINT | UVM_NOCOMPARE)  // 跳过
    `uvm_field_event(done_ev, UVM_NOPRINT | UVM_NOCOMPARE)  // 跳过
  `uvm_object_utils_end
endclass
UVM_DEFAULT 展开后等于 UVM_ALL_ON——打印、复制、比较、打包全参与。所以「默认」其实是「全开」。新手最常见的失误就是给 timestamp 这类环境注入字段也留了默认:期望事务由 predictor 生成、实际事务由 monitor 采样,两边时间戳永远差一截,scoreboard 每拍都报 miscompare,满屏红色把真问题淹没。第一次配错几乎人人都经历过。
下面这张图把 compare 的判定流程画出来:比较器拿到对象后先查字段注册表,带 NOCOMPARE 标记的字段直接绕行,剩下的按各自策略递归比较。
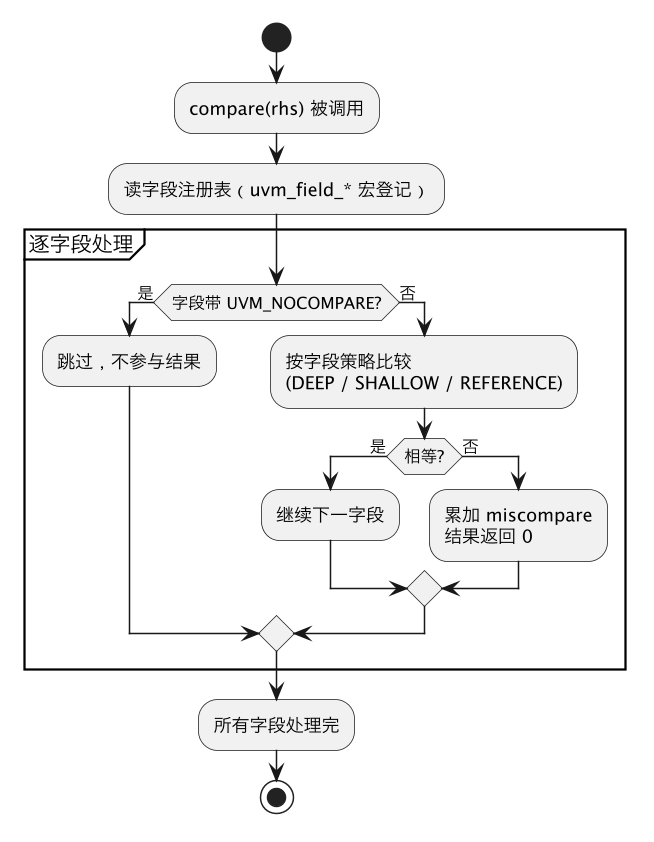
这张图的关键信息是:跳过发生在比较之前,而不是比较失败之后被原谅。NOCOMPARE 字段连求值都不做,因此它不影响结果、不进日志(配合 NOPRINT 也不进打印)。这决定了它的定位——是「声明这个字段没有可比性」,而不是「先比比看,不一样就算了」。
二、三种比较策略:DEEP、SHALLOW、REFERENCE
策略位决定的是句柄型字段(对象、数组里的对象元素)怎么比。标量字段(int、bit、enum)三种策略行为一致,直接按值比。差异全在对象上:
| 策略 | 句柄字段的比较方式 | 适用场景 |
|---|---|---|
UVM_DEEP | 递归调用子对象的 compare(),比到叶子 | 对象图整体语义相等才算相等,scoreboard 主流选择 |
UVM_SHALLOW | 只比句柄指向对象的「第一层」成员,子句柄按句柄值比 | 子对象是共享配置/池化对象,只需确认身份一致 |
UVM_REFERENCE | 只比句柄值本身(两个引用是否指同一个对象) | 「是同一个实例」才有意义的字段,如反向指针、父句柄 |
一句话记忆:DEEP 比内容,REFERENCE 比身份,SHALLOW 折中。下面用对象图把三种策略的作用深度画在一起。
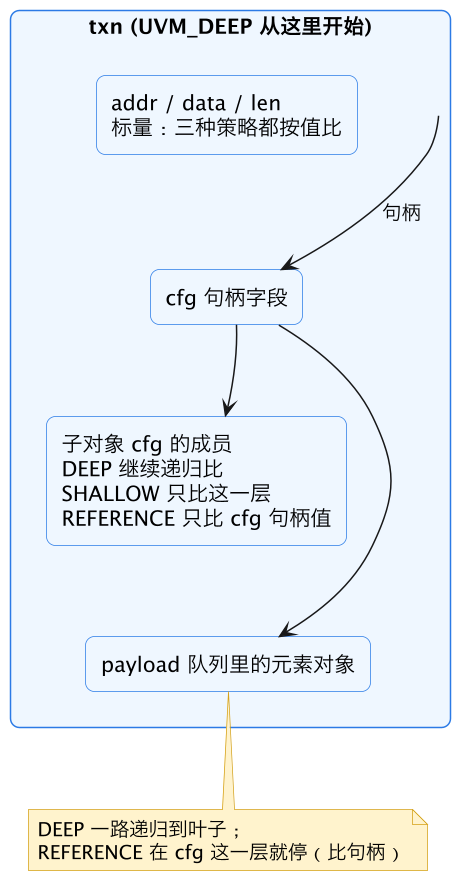
读图要点:标量成员无论策略如何都按值比,差异从第一个句柄字段开始分叉。REFERENCE 在 cfg 处只做一次句柄等值判断——两份事务引用的是同一个配置对象才算相等;DEEP 则顺着箭头递归下去,直到对象图的叶子。
一个真实的踩坑场景:事务里嵌了一个 payload[$] 动态数组存子事务,注册时写成 UVM_REFERENCE,结果两份事务的子对象明明内容一样,却因为不是同一批实例而报 miscompare。改成 UVM_DEEP 立即消音。反过来,若子对象是全局唯一的配置单例,用 DEEP 每次递归比较几十个成员纯属浪费仿真时间,REFERENCE 一个句柄等值就解决。策略选型的依据是字段的语义角色,不是图省事。
三、标记位:NOCOMPARE 与 NOPRINT 的正确用法
策略管「怎么比」,标记管「参不参与」。常用的几个:
| 标记 | 效果 | 典型对象 |
|---|---|---|
UVM_NOCOMPARE | 字段退出 compare() | 时间戳、采样周期、调试计数等环境注入字段 |
UVM_NOPRINT | 字段退出 print()/sprint() | 大数组、句柄字段、打印无意义的事件 |
UVM_NOCOPY | 字段退出 copy()/clone() | 缓存句柄、运行时重建的临时状态 |
UVM_REFERENCE | 句柄按引用比(常与其他标记叠加) | 父指针、共享配置 |
NOCOMPARE 与 NOPRINT 经常成对出现,但语义独立:时间戳不比对,可你调试时可能还想看到它——那就只加 NOCOMPARE,打印保留。反过来,一个 4KB 的 byte payload[] 要比内容(NOCOMPARE 绝不能加),但全量打印会刷屏,只加 NOPRINT。两个标记各管一摊,按需组合。
绝不能跳过比较的字段只有一类判据:由 DUT 行为决定、且验证目标要检查它。地址、数据、控制位、响应码——这些是 scoreboard 存在的意义。曾见过一个环境为了「先让比对跑通」,把 resp 字段也标了 NOCOMPARE,结果回归全绿了两周,没人发现 DUT 一直返回错误响应码。教训:每加一个 NOCOMPARE,都要能一句话说清「这个字段为什么不可比」,说不出来就是偷懒。
再补一个细节:UVM_DEFAULT 里其实还隐含了策略——对标量字段它等价于 DEEP,而标量三种策略行为一致,所以平时感知不到;一旦换成 uvm_field_object / uvm_field_queue_object,策略位的选择立刻变得关键。注册宏写错字段类型(比如对象是句柄却用了 uvm_field_int)属于编译期就能发现的问题,反而是策略选错最隐蔽:仿真能跑、日志正常,只是比对结果不可信。
还有一个容易漏的点:uvm_field_object 注册的子对象字段若想被 DEEP 递归比较,子对象类自己也得正确注册字段或实现 do_compare()——钩子层面的细节就是 UVM compare 与 do_compare:自定义比较钩子 那篇的内容了,比如浮点容差、无序数组匹配,都不是策略位能表达的。
四、落地清单
给事务类定策略时按四步走:第一,列出全部字段,标注来源——DUT 输出、激励生成、还是环境注入;第二,DUT 输出与激励字段默认 UVM_DEFAULT,这是比较的主体;第三,环境注入字段(时间戳、迭代号、调试句柄)一律 UVM_NOCOMPARE,打印按调试需要决定是否保留;第四,句柄字段按语义角色选 DEEP 或 REFERENCE,拿不准就先 DEEP——误报比漏报好处理。最后跑一轮「故意注错」测试:改 DUT 一个输出位,确认 scoreboard 会红。比对逻辑本身也需要被验证,这是最容易被忽略的一步。把这套清单固化进团队的事务类模板里,新人照抄即可得到合理的默认配置,不必每个人重新踩一遍坑。
这一篇在知识体系里的位置
- 上游语法:UVM compare 与 do_compare:自定义比较钩子 讲比较钩子的实现,本篇的策略与标记是调用钩子之前的声明层配置。
- 拷贝语义对照:SV 对象拷贝:深拷贝与浅拷贝 用同一套 DEEP/SHALLOW 词汇讲
copy(),与本篇的compare()语义互为镜像。
总结
UVM compare 策略字段跳过的核心是两组配置:策略位(UVM_DEEP 比内容、UVM_SHALLOW 折中、UVM_REFERENCE 比身份)决定句柄字段按什么深度比,标记位(UVM_NOCOMPARE 退出比较、UVM_NOPRINT 退出打印)决定字段参不参与;DUT 行为决定的字段绝不能跳过,环境注入字段必须跳过,拿不准就先 DEEP 再观察,并且每加一个 NOCOMPARE 都要说得出理由——配置对了,scoreboard 的红色才是真的红色。