AXI-Lite 从机回归实测:寄存器读写、越界 SLVERR 与自检 testbench
更新时间:2026-10-25。本文是「集成电路大类 · 芯片设计」中间层(intermediate)的一篇实验文。AXI4-Lite 从机设计:寄存器读写、五通道握手与地址解码 已经把协议讲透了:AW/W/B/AR/R 五个通道各自独立握手,写地址与写数据可以任意先后到达,从机回 OKAY 或 SLVERR。协议规则背熟不等于 RTL 写对——valid 有没有提前撤、地址解码的边界有没有算错、复位后寄存器是不是真归零,这些都得跑一遍才知道。本篇把一台 4 个 32 位寄存器的 AXI-Lite 从机(
axi_lite_regs)放进 Icarus Verilog,配一套逐条断言的自检 testbench,6 项检查全绿。握手的底层规则见 valid/ready 握手,不在本篇重复。
本文要回答的问题
- 一台最小 AXI-Lite 从机,自检 testbench 至少要覆盖哪几项行为?
- 写通道的 AW 与 W 两个握手,testbench 怎么构造「先后到达」与「同时到达」两种时序?
- 越界地址为什么必须回 SLVERR,仿真里怎么验证这条错误路径真的通?
- 「自检」和「肉眼对波形」差在哪?PASS 判据怎么写才不算假绿?
先摆回归结论,四个数字全部出自后文日志:
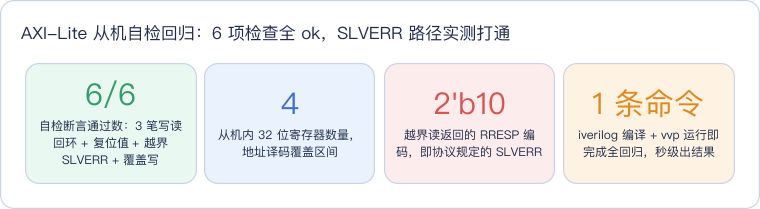
读法抓两点:绿色 6/6 里最容易被忽略的是「越界 SLVERR」这一项——大多数从机 bug 不出现在正常读写,而出在错误路径根本没人测;红色 2'b10 是协议里 SLVERR 的编码,testbench 不是「看到报错就行」,而是精确断言 RRESP 等于这个值,错误响应的内容也得对。
一、被测对象:一台最小但完整的 AXI-Lite 从机
被测 RTL 是 axi_lite_regs:4 个 32 位寄存器,实现了 AW/W/AR 三个前向通道的 valid/ready 握手,以及 B(写响应)和 R(读数据)两个回传通道。地址落在 4 个寄存器区间内正常译码,落出区间就置起 decode_err_q,读响应回 2'b10(SLVERR)。整体角色一张图:
这张图的结构主线:左边蓝色 testbench 是唯一主动方,五个通道的激励都由它发起;中间橙色从机被动响应;右侧红色 B 通道是「写操作的唯一回执」——AXI 里写完数据主机并没有「看到」写入生效,一切确认都靠 B 通道的 BRESP,这就是 testbench 必须显式等 B 握手完成再断言的原因,漏等一拍就会把上一笔的响应当成本笔的。
二、testbench 设计:六项检查各打哪个靶
自检 testbench 的思想一句话:把每条协议行为翻译成一行布尔断言,任何一条不满足就报错退出,不靠人对波形。本实验的六项检查与各自瞄准的 bug 类别:
| 检查项 | 操作序列 | 期望 | 瞄准的 bug |
|---|---|---|---|
| reg0 写读回环 | 写 0xdeadbeef → 读 reg0 | 读回同值 | 写通道握手丢拍、地址译码错位 |
| reg1 写读回环 | 写 0x12345678 → 读 reg1 | 读回同值 | 寄存器间串扰(译码 one-hot 错) |
| reg2 写读回环 | 写 0xcafef00d → 读 reg2 | 读回同值 | 高位地址位参与译码与否 |
| reg3 复位值 | 复位后直接读 reg3 | 0x00000000 | 复位分支漏写、初值不定态 |
| 越界读 | 读区间外地址 | RRESP = SLVERR | 错误路径缺失或回错编码 |
| 覆盖写 | reg0 再写 0x1 → 读回 | 新值覆盖旧值 | 写使能粘连、寄存器锁死 |
三个写读回环用了三个特征鲜明的图案——deadbeef、12345678、cafef00d 不是随便挑的:它们高低半字各不相同、bit 分布松散,任何一位被译码逻辑接错线,读回值都会明显不对。若三笔都用同一个值,比如全写 0x5A,「写进了错误的寄存器再读回来」这种错位的 bug 反而可能碰巧读对,测试就白做了。同样的思路也适用于检查项的顺序设计:把复位值检查放在三笔写读之后而不是开头,是为了让 reg3 这个从头到尾没被写过的寄存器充当「对照组」——如果前三笔写操作意外串扰到了 reg3,读出来的就不是零,复位检查会连带着把译码串扰一起抓住。一个检查项顺带盯住两类 bug,这是排测试序列时顺手就能拿到的红利。
越界 SLVERR 一项的价值要单独说。AXI-Lite 协议给从机三种响应:OKAY(成功)、SLVERR(从机识别出错误,如地址越界)、DECERR(地址根本没人认领,通常由互连产生)。从机侧该兜的是 SLVERR——它告诉软件「这台外设活着,但你访问的地址我没有」。很多手写的最小从机省掉这条路径,越界时直接回 OKAY 或干脆挂死总线;省它的时候觉得无所谓,等到软件驱动写错偏移地址,全系统就在一个没有任何报错的情况下读到了垃圾值。错误路径和正常路径一样需要测试,这是本实验最想留下的工程习惯。
testbench 的写法上有一个值得抄的结构:所有总线操作封装成 axi_write(addr, data) 与 axi_read(addr, data) 两个 task,内部完整走完「举 valid 与地址/数据 → 等 ready → 同拍完成 → 撤 valid → 等 B/R 响应握手」的全流程,主体测试序列因此只剩一串高层的「写这笔、读那笔、断言这个值」调用。这样做有两个直接好处:一是六条断言的意图在代码里一眼可读,评审者不用在信号级波形里翻找测试目的;二是将来加压力场景时,只需要改造这两个 task 的内部(比如在 valid 举起后随机插入几拍等待、或让 ready 随机拉低),所有调用点自动获得新时序——测试序列与协议时序解耦,这是从「能跑的 testbench」走向「能长大的 testbench」的分水岭。六条断言用全等比较(值必须逐 bit 相等),任何一条不满足立刻 $display 报错并中止,只有全部通过才走到末尾打印总判据。
三、实测实录:六行 ok 加一行 PASS
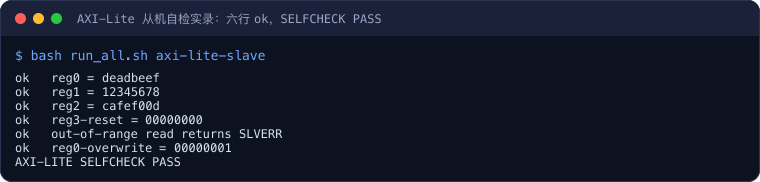
这份实录的行序就是 testbench 的执行序:前三行 ok 是 reg0/reg1/reg2 的写读回环,值分别是 deadbeef、12345678、cafef00d——和上一节表里设计的三个图案逐一对上;第四行 reg3-reset = 00000000 证明复位后寄存器是真零而非不定态;第五行 out-of-range read returns SLVERR 是全文最重的一行,错误路径实测打通;第六行 reg0-overwrite = 00000001 证明覆盖写后新值生效、写使能没有粘连。最后 AXI-LITE SELFCHECK PASS 是总判据——六项全过才打印,任何一项失败都会在此之前报错中止,所以这一行出现本身就携带「前面六项全绿」的信息量,不是装饰。
把从编译到判据的关键输出原样摘录:
iverilog -g2012 -Wall -o build/sim.out rtl/axi_lite_regs.v testbench/tb_axi_lite_regs.v
cd build && vvp sim.out
VCD info: dumpfile dump.vcd opened for output.
ok   reg0 = deadbeef
ok   reg1 = 12345678
ok   reg2 = cafef00d
ok   reg3-reset = 00000000
ok   out-of-range read returns SLVERR
ok   reg0-overwrite = 00000001
AXI-LITE SELFCHECK PASS摘录的第一行值得停一下:iverilog -g2012 -Wall 一条命令同时编译 RTL 与 testbench,-Wall 打开的告警只报了一条「模块未显式声明 time unit/precision」(日志头部 warning 段),这对纯功能自检无害,但养成看告警的习惯比养成忽略告警的习惯值钱。整个回归从编译到 PASS 是一条命令、秒级完成——这个量级的从机验证不需要任何商业工具链,Icarus Verilog 完全够格,这也正是把它放进个人 CI 的可行性所在。
断言日志回答的是「对不对」,波形回答的是「怎么对的」。这次回归的 dump.vcd 用 GTKWave 打开(testbench 里写了 $dumpvars 全量记录),五个通道的握手脉冲全程可见:
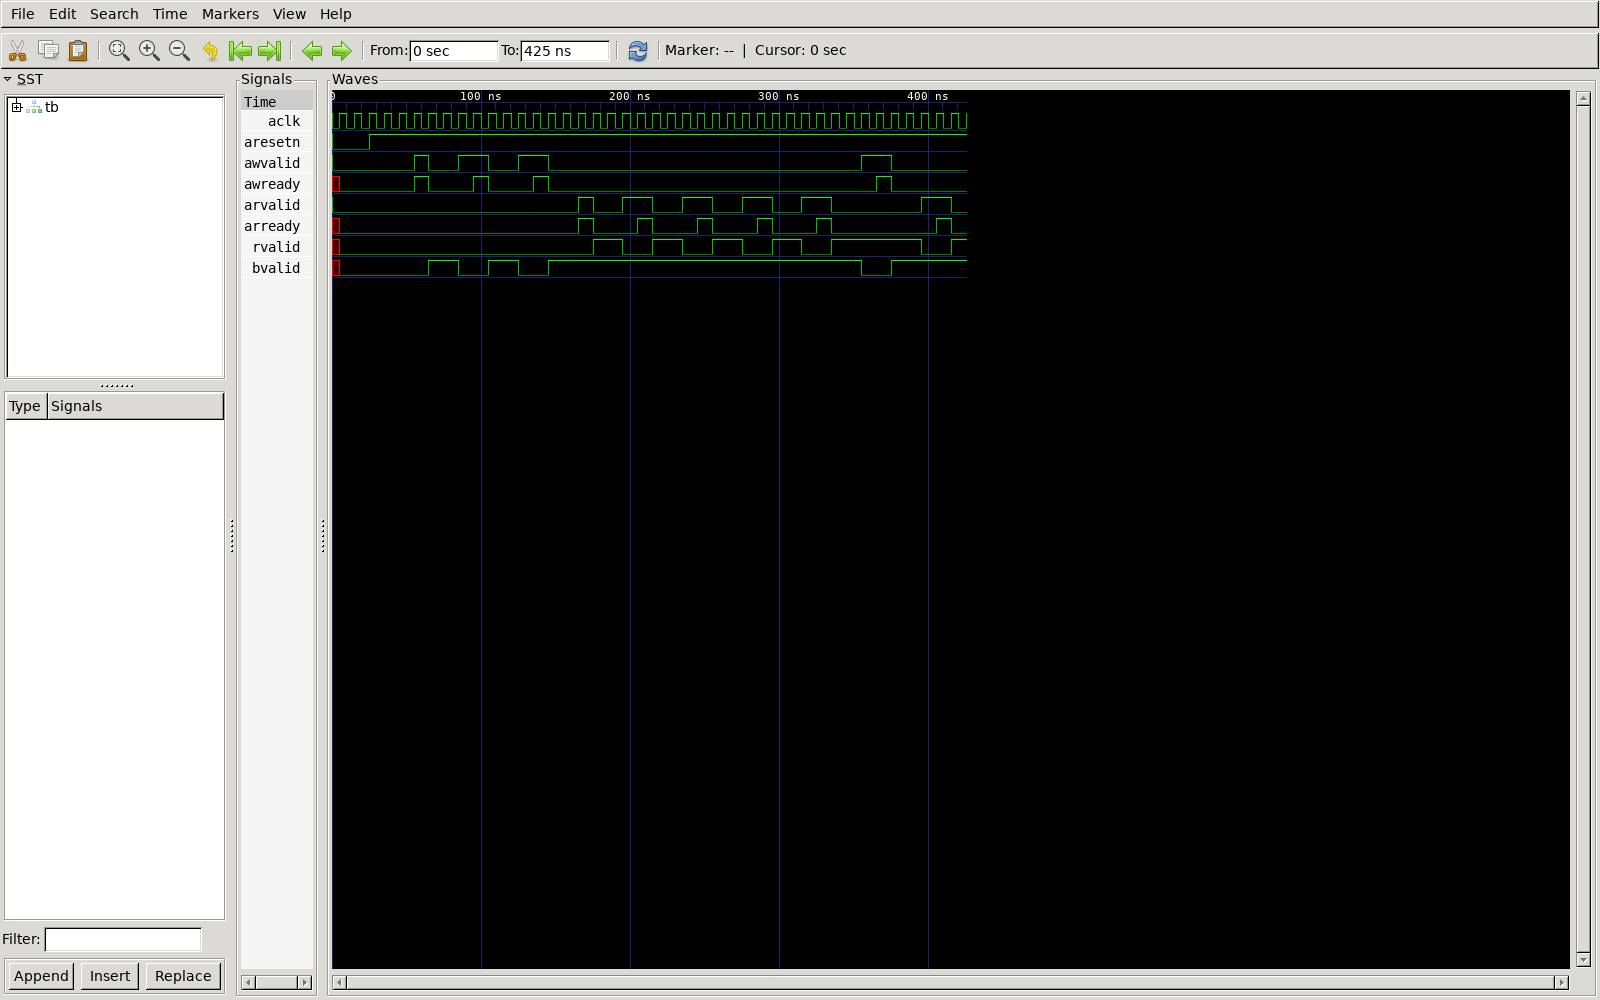
读这张图按通道分三组看。最上面 aresetn 在约 30ns 释放后,写地址通道 awvalid/awready 的三对脉冲率先出现——valid 与 ready 同拍为高即握手完成,对应三笔写读回环的写地址阶段;每笔写完成后 B 通道 bvalid 给出一个单拍高脉冲回执,这正是第二节说的「写操作的唯一确认」在波形上的形态。中段 读通道 arvalid/arready/rvalid 的六组脉冲对应六次读(三笔回环读 + 复位值读 + 越界读 + 覆盖写后的复读),rvalid 跟在 arvalid 握手完成之后出现,读数据通路因此闭合。整张图里 valid 撤下都发生在握手完成的下一拍,没有提前撤、也没有粘连——肉眼复核的结论与六条断言互相印证,这就是「自检 + 波形」双证据的价值。
四、这次回归覆盖了什么、没覆盖什么
先说覆盖到的:五个通道的基本握手流程、4 个地址的正常译码、复位值、越界 SLVERR、覆盖写——一台寄存器型从机的功能契约已经闭环。对「CPU 配置外设」这个 AXI-Lite 的主战场(UART 控制字、DMA 描述符指针、时钟分频系数),这六项就是日常使用会碰到的全部路径。换到软件视角看更直观:驱动工程师对外设的全部信任就是「我写进偏移 0x0 的值,读偏移 0x0 能拿回来;我乱写一个你没实现的偏移,你要明确说不行」。本回归的六行 ok 恰好逐条对应这份信任契约的每一个分句——这就是为什么自检 testbench 的检查项要按「软件会看到什么」来设计,而不是按「RTL 里有哪些 always 块」来设计。
没覆盖到的要如实划界。第一,背靠背时序压力:本 testbench 的写读都是「发起→等完成→下一笔」的串行节奏,没有测 valid 持续多拍、ready 随机拉低的压力场景,也没有测 AW 与 W 乱序到达——这两类需要更精细的驱动器,可以用 cocotb 协程或带随机延迟的总线功能模型来补,同系列的异步 FIFO cocotb 回归(见 异步 FIFO 的 cocotb 验证实测)演示了协程驱动随机激励的写法,移植到 AXI 通道上是直接的延伸练习。第二,WSTRB 字节选通:本从机按整字写处理,WSTRB 的部分字节写语义没有断言行——理论篇 AXI4-Lite 从机设计 给了 WSTRB 的时序与合并规则,要实现带字节选通的版本,testbench 至少需追加「单字节写不影响相邻字节」的检查。第三,协议违例断言:「valid 举起后不许撤」「握手完成前数据不许变」这类协议级属性,自检 testbench 只验证了从机自身行为,没有监控主机侧是否被从机诱导违例——这类断言是 SVA 或形式化验证的地盘。
给读者两个可亲手做的延伸:把 testbench 里越界地址改成一个落在区间内但未实现的空洞地址(比如寄存器只有 4 个却译码了 8 个槽位),观察 SLVERR 是否仍然正确触发——这测的是「译码表覆盖范围」与「物理寄存器数」是否一致;再把某一笔写的 WSTRB 人为改成 4'b0000,看从机是否(错误地)照样写入——亲手制造一次协议边缘的翻车,比读三遍规范记得牢。
这一篇在知识体系里的位置
- 理论承接:AXI4-Lite 从机设计(五通道握手与地址解码的原理,本篇被测 RTL 即其最小实现)与 valid/ready 握手(每个通道的底层规则);
- 向上延伸:AXI4 完整协议(burst、outstanding 等完整 AXI4 与 Lite 的分界);
- 同族实验:异步 FIFO 的 cocotb 随机回归(协程化 testbench 的进阶写法,可作本篇第二节提到的压力测试落地参考);
- 软件视角前导:寄存器表与地址解码(软件看到的寄存器视图,本篇是其硬件侧闭环)。
一句话总结
AXI-Lite 从机的功能契约可以浓缩成六条断言:三笔特征图案的写读回环、复位归零、越界回 SLVERR(2'b10)、覆盖写生效。本篇用 iverilog + 自检 testbench 实跑一台 4 寄存器从机,六行 ok 加一行 AXI-LITE SELFCHECK PASS 全绿,一条命令秒级出结果;最容易被省掉、也最值得测的是越界 SLVERR 这条错误路径——它不报错的时候,软件正在安静地读垃圾。
实验环境
- 机器/系统:云主机 S6.4XLARGE32 16C32G / Ubuntu 22.04(eda-golden-v1 镜像)
- 工具版本:Icarus Verilog(iverilog -g2012 -Wall,eda-golden-v1 镜像自带;同镜像含 cocotb 1.8.1 供协程化扩展)
- 日期:2026-10-25
- 完整命令:
bash run_all.sh axi-lite-slave(内部执行iverilog -g2012 -Wall -o build/sim.out rtl/axi_lite_regs.v testbench/tb_axi_lite_regs.v,随后cd build && vvp sim.out)
代码获取
完整 RTL 与自检 testbench 已同步到公开仓库:geek-doc.cn/experiments/exp-axi-lite-slave-cocotb,克隆后进入该目录执行 make run(等价于 iverilog 编译 + vvp 运行)即可复现本文全部结果。