spare cell 库存审计:tapeout 前怎么盘点备用单元够不够用
备用单元摆放策略讲的是 place 阶段怎么撒 spare cell——配比、密度、位置。但撒完不等于够用:经过 CTS、绕线优化、多轮 setup/hold 修复之后,当初撒下的 spare cell 有的被逻辑优化顺手吃掉,有的被局部密度超限挤走,有的落在后来长出来的硬核旁边失去了可达性。spare cell 库存审计就是 tapeout 前对这笔「ECO 保险」做的年终盘点:按类型清点还剩多少、按区域看分布有没有空洞、按 metal-only 规则折算真正用得上的量。它是 tapeout 最终检查清单里容易被略过、却直接决定后期 metal-only ECO 流程 生死的一项。
本文要回答的问题
- 库存审计具体盘点哪些维度,清单长什么样?
- 「名义库存」和「metal-only 可用库存」差在哪,怎么折算?
- 哪类 ECO 改动消耗哪类 spare cell,怎么对着改动类型查库存?
- 审计发现不足时,不同阶段还有什么补救手段?
一、审计清单:四个维度逐项过
spare cell 库存审计不是数一个总数就完事,要按四个维度拆开看:
| 维度 | 审计内容 | 合格判据(经验值) |
|---|---|---|
| 数量 | 全 die spare cell 总件数、占功能门比例 | 每千门 10-30 个,或面积占比 2%-5% |
| 类型齐套 | INV/NAND/NOR/MUX/DFF 各类件数与驱动档位 | 每类都有,DFF 不少于总量 10%,每类至少 X1/X2 两档 |
| 分布 | 网格化统计可达半径内件数,找空洞 | 任一网格外扩 50 微米内有一套齐套 spare |
| 可用性 | 未被冻结、未被 tie 网络锁死、周边绕线资源够 | 折算后可用量不低于名义量 60% |
数量维度的数据源是 DEF/网表统计脚本,按 cell master 名前缀(SPARE_*)过滤即可。类型齐套要对照 备用单元摆放策略里定的配比表逐项核对——最常见的不合格是「DFF 被吃了」:时序优化阶段工具会把闲置 spare DFF 当可删除对象清掉,导致库存里组合门一堆、寄存器一个没有,而寄存器恰恰是最不可缺的类型。
二、名义库存与可用库存:三道折算
报上来的总数是名义库存,真正 metal-only ECO 能用上的要打三次折:
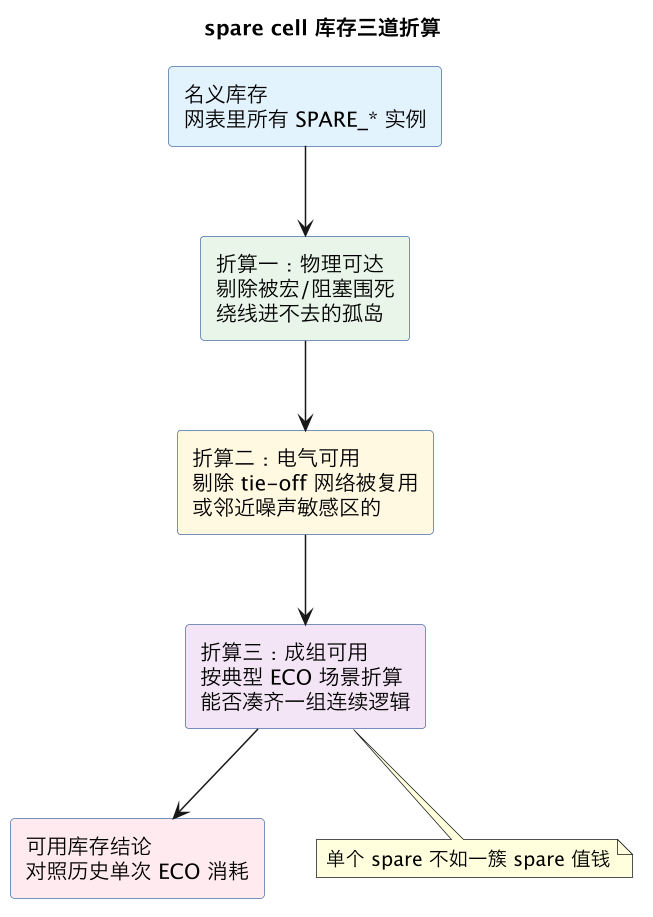
第一道折算是物理可达:spare cell 被夹在 macro 和 halo 之间、或被高密度绕线区围死的,新逻辑连不进去,等于没有。第二道是电气可用:有的 spare 输入 tie-off 用了共享的 tie cell 网络,改动时会牵连周边单元;有的紧邻时钟树或模拟敏感区,改接会引入串扰风险(分析方法见 时序窗口与 SI 噪声)。第三道最关键——成组可用:一次功能 ECO 拼的是一串逻辑,需要在可达半径内凑齐「几个组合门加一两个 DFF」的一簇;散落全 die 的单件帮不上忙。审计时要用典型 ECO 场景(比如「加一个三输入条件判断进控制 FSM」)做试拼装,而不是只数件数。
三、对着改动类型查库存
不同 ECO 改动对库存的消耗模式完全不同,审计表要按改动类型分列:
| ECO 改动类型 | 主要消耗 | 单次典型消耗量 |
|---|---|---|
| 控制逻辑修补(FSM 加状态、条件改判) | NAND/NOR/INV + 1-2 个 DFF | 10-40 件 |
| 数据通路小改(位宽截断、MUX 换源) | MUX、复合门 | 5-20 件 |
| 寄存器补打拍(时序修复性改 RTL) | DFF(带扫描、带 set/reset) | 1-8 个 DFF |
| 极性/使能翻转 | INV、XOR | 2-6 件 |
| 接口协议补丁 | 组合门 + DFF + MUX 混合 | 20-100 件 |
拿这张表对照库存:如果历史项目显示本项目类型「接口协议补丁」高发(比如带可配置寄存器块的 SoC),而库存里 DFF 和 MUX 只剩个位数成组可用,审计结论就是不合格。改动的传播路径判断方法见 X3 ECO 变更传播,功能补丁侧的网表操作见 功能 ECO 网表修补。
四、审计不过怎么办:按阶段补救
发现库存不足时的补救成本,取决于离 tapeout 还有多远。pre-route 阶段最从容:直接在空洞区域补撒 spare cell 并重新合法化(见 布局合法化),注意和 filler 与密度规则协调密度上限。post-route 阶段只能做增量插入:找利用率低的行段塞进 spare,重跑局部 DRC 与 SPEF 提取确认时序无回归。已经在 freeze 状态时,最后的手段是降级 ECO 预案——明确记录「哪些模块的 ECO 只能做局部重流片」,把风险写进交接文档而不是假装保险还在。
审计结果应该量化上板:每个网格的齐套件数、成组可用簇数、对照历史消耗的覆盖倍数,一并挂到 X5 QoR 看板,让每次迭代后库存水位可见。
五、审计自动化与常见误判
库存审计靠手工数一次就过时一次,正确姿势是脚本化后挂在回归里。脚本三段式:先用网表/DEF 解析按 master 名过滤出全部 spare 实例并输出类型-档位矩阵;再调 P&R 工具的查询接口算每个实例到最近 macro/blockage 边界的距离和周边轨道占用率,做可达性打分;最后按预设网格粒度(常见 50×50 微米)聚合出齐套度热力图。整套脚本在每次大迭代后跑一遍,耗时不应超过一杯咖啡。
三类常见误判要防。第一,把 freeze 的 spare 当可用:早期被 dont-touch 锁住的 spare cell(见 dont-use 与 dont-touch 流程)有些已被工具挪作时序修复的候选,属性要先解冻确认。第二,按 die 平均密度下结论:全 die 总量达标不代表局部够用,审计的最小单位永远是网格而非整片。第三,忽略库档位漂移:综合换库版本后,原配比表里的某些 drive strength 档可能在新库里被裁掉,库存还在但档位没了——每次换库要重跑类型-档位矩阵对比。这三类问题都写成 lint 规则放进审计脚本,比人肉复盘可靠。
最后补一条组织层面的经验:库存审计结论要有明确的责任人签收。审计报告不能只是「生成了就归档」,要和模块 owner 逐项确认——空洞网格归谁补、DFF 缺口归谁加、降级预案归谁写。ECO 真正发生时不会有时间翻旧账,tapeout 前把「谁家的保险够不够」当面确认过,后期的扯皮就少一半。把审计做成本能反应的项目,第一次功能 ECO 来临时就能体会到差别:别人还在翻版图找可用 spare,你的报告里连成组可用簇的坐标清单都是现成的——ECO 工程师拿到这种清单,第一版补丁通常当天就能进验证。
这一篇在知识体系里的位置
- 上游策略:库存从哪来见 备用单元摆放策略,布局阶段三件套另两件是 filler 与密度规则和 welltap/endcap 摆放。
- 下游消费:审计合格的库存由 metal-only ECO 流程消费,网表侧衔接 功能 ECO 网表修补与 网表交接与 ECO。
- 签核横切:本清单并入 tapeout 最终检查清单,水位指标纳入 X5 QoR 看板。
总结
spare cell 库存审计是 tapeout 前按「数量、类型齐套、分布、可用性」四个维度盘点备用单元:名义库存要过物理可达、电气可用、成组可用三道折算,再对照改动类型的消耗表判定够不够;不够就趁 pre-route 补撒、post-route 增量插入,实在来不及就把 ECO 预案降级写进交接——别让几十万死硅给你一个虚假的安全感。