lib db 编译:从 .lib 语法检查到 .db 一致性校验的排错流程
更新时间:2026-10-04。lib db 编译指的是把文本格式的 Liberty 库(.lib)用 Library Compiler(或各签核工具自带的库读取器)编译成二进制 .db 格式的过程——Liberty 特征化流程 产出的是 .lib,而 PrimeTime、Design Compiler 真正吃的是 .db。中间这道编译看着只是格式转换,实际上是库文件质量的第一道正式闸门:语法、模板引用、时序弧完整性、功耗/噪声视图配套关系,全在这一步被翻出来。本篇讲这道闸门怎么过、报错了怎么按类别定位。库内容的物理含义不在本篇展开,请配合 Liberty NLDM/CCS 时序模型 与 Liberty 视图格式 阅读。
本文要回答的问题
- lib db 编译从读文件到写出 .db,中间过了哪几道检查,各查什么?
- 语法类报错(parse error)为什么十有八九不是报错行本身的问题?
- missing timing arc 怎么判断是特征化漏跑还是库结构本来就如此?
- .lib 编译通过但签核工具加载 .db 后行为异常,一致性怎么对拍?
- 多 corner 库批量编译时,怎么组织流程让错误尽早暴露?
一、编译流程总览:三道闸门
lib db 编译的一条命令背后是三段式处理:先词法语法解析(parse),再语义与引用检查(elaborate/check),最后序列化成 .db 并做回读自检。三段任一不过都出不了库文件,但报错性质完全不同。
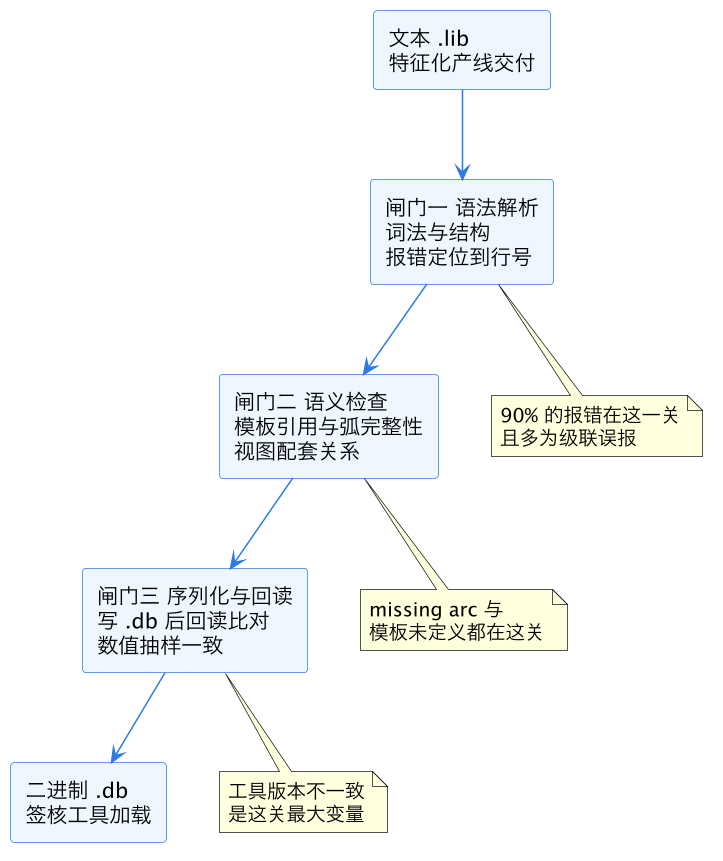
读这张图的重点是排查成本递增:闸门一的错改一行就完事,闸门二的错往往要回特征化流程补数据,闸门三的错常常牵扯工具版本与流程环境,排查一圈下来以天计。所以实战原则是「能在 .lib 文本侧查清的,绝不留到 .db 侧发现」——read_lib 之后务必跟一条 write_lib 或 check 报告,把工具内部的库视图导出成文本再肉眼核一遍。
二、语法类报错:报错行往往不是凶手
语法解析失败是最高频的报错,特征是工具直接给出文件名和行号后中止。新手照行号冲过去看,常常发现那行毫无问题——因为 Liberty 是嵌套结构,一个没闭合的大括号会让解析器在几十行之后才发现「结构对不上」,报错行只是「发现问题的地方」,不是「犯错的地方」。
三个实战经验。第一,从报错行向上找最近的 group 语句(cell、pin、timing、power_lut_template 这类),检查它的开闭括号配对;一个单元里少一个 },解析器会把这个单元的剩余内容当成库级属性,然后在遇到下一个合法库级 token 时报错。第二,警惕不可见字符:Windows 编辑器带进来的 CRLF、全角空格、制表符混用,部分版本的 Library Compiler 会给出莫名其妙的 token error,用 file 和 grep -P '[^\x00-\x7F]' 先扫一遍比瞪眼快。第三,数值格式坑:科学计数法写法、负的 delay 值、查表索引超出模板定义范围,有的解析器按语法错误报、有的按语义错误报,报错信息对不上文档时先怀疑这一类。
三、语义检查:missing arc 与模板引用
过了语法关,编译器开始检查库的内部自洽性。这一阶段的三类报错值得单独说。
missing timing arc(时序弧缺失) 是最让人心里没底的一类。编译器期望一个组合逻辑单元的每个输入 pin 到每个输出 pin 都有 timing 组,时序单元(触发器)有完整的 setup/hold、CK-to-Q、recovery/removal 弧(后者含义见 recovery/removal 检查)。缺失时分两种情况:一种是真缺——特征化时某条 arc 的仿真失败被跳过、或 dont_use 单元被人工裁过弧,这种必须回 特征化流程 补跑;另一种是「结构性无弧」——三态门的 OE 到输出在某些建模口径下只标 three_state_disable 不给 delay 弧,属正常。判据很简单:同一家工艺库的其他 corner 版本里这条弧在不在?在,就是本 corner 特征化漏了;都不在,去查 vendor 的库手册确认建模口径。最危险的处理方式是给编译器加 waiver 强行放过——签核时这条弧对应的路径会被静默断掉,setup/hold 全绿但芯片不工作。
模板引用错误排第二。NLDM 查表必须引用库头定义的 lu_table_template,下标个数、变量类型(input_transition_time / total_output_net_capacitance)要和模板 variable_1/2 对齐;CCS 库里的 receiver/driver model 引用同理。常见错因是拼接库文件时(比如把 macro 的 .lib merge 进 stdcell 库)两边模板同名不同义,merge 脚本只留了一份,另一半单元的查表全错位——这种错编译器有时只给 warning,但签核延迟全错,必须当 error 处理。
视图配套检查排第三:开了 CCS timing 就该有配套的 CCS noise(CCS 噪声模型),功耗侧的 leakage_power、dynamic power 组与信号 pin 的对应关系要完整。缺配套视图不一定报错,但决定了签核工具能用什么分析档——noise 视图缺失时 SI 分析直接降级。
| 报错类别 | 典型报错信息关键词 | 真实根因分布 | 正确处理 |
|---|---|---|---|
| 语法解析 | syntax error / unexpected token | 括号不配对约六成,非法字符与数值格式约四成 | 向上找 group 配对,先扫非 ASCII |
| missing arc | missing timing arc / no delay arc | 特征化漏跑为主,结构性无弧为少数 | 跨 corner 对照,漏跑就补特征化 |
| 模板引用 | undefined template / index mismatch | 库 merge 时模板被覆盖 | 检查 merge 脚本,模板先统一再拼接 |
| 视图配套 | warning: no noise/power data | 特征化配置项漏开 | 补视图或确认降级可接受 |
四、一致性校验:.lib 与 .db 对拍
编译全绿不等于完事。最后一道是自举校验:用一个干净的签核工具会话 read_db 加载产物,再抽样回读核对。抽什么?每个 corner 抽 5-10 个代表性单元(覆盖反相器、NAND、触发器、大驱动 buffer、memory macro——macro 的弧结构见 memory macro 时序弧),用 report_lib 或等价命令导出 delay 表,和 .lib 文本里的 cell_rise/cell_fall 查表值逐格比对,索引点也要对。经验上允许浮点舍入级别的差异(相对误差 1e-6 量级),出现百分之一以上的偏差,基本就是工具版本不一致:编译用 Library Compiler 的版本比签核 PrimeTime 新(或反过来),序列化格式有差异——这类问题在 Signoff STA 与 PrimeTime 的库加载一节有对应的环境对齐要求,库编译侧的对策就是锁定工具版本组合并写进 PDK 版本基线。
还有一个轻量但省时间的做法:把抽样比对写成脚本固化下来,输入单元列表和两个库句柄,输出逐格差值表。每次换 PDK 小版本或升级编译器补丁,先跑这个脚本再进回归,几十秒就能拦截「格式兼容但数值飘了」这一类最阴的问题。
多 corner 场景下还要一条横向校验:同一单元在不同 corner 的 .db 里,delay 查表的索引点(slew/load 网格)应当一致,只有数值不同。索引网格都变了,说明各 corner 特征化时的网格配置没锁死,插值行为在 corner 之间不可比——这种不一致编译期完全不报,却是 MMMC 多角分析(corners 与 MMMC)结果飘移的隐蔽来源。
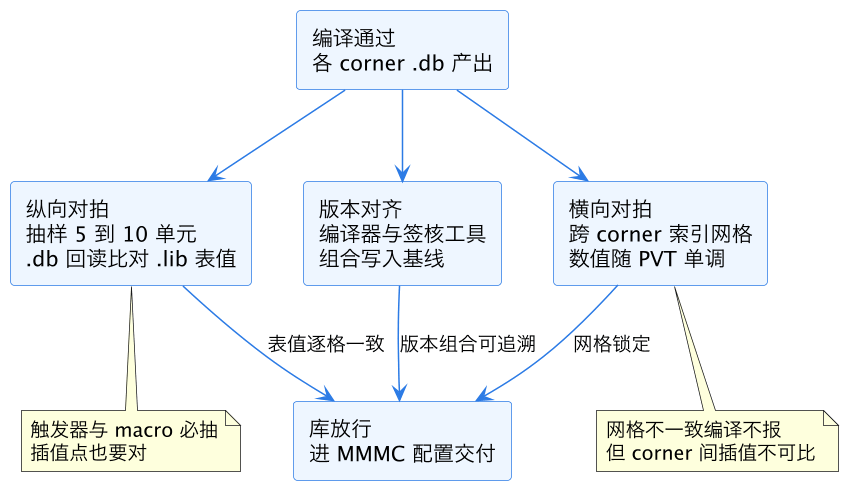
这张图是一致性校验的三条线:纵向管「编译对不对」,横向管「corner 之间比不比得了」,版本线管「下次还能不能复现」。三条全绿,库才有资格进签核交付清单;任何一条红了,回上一节对应类别定位,不要带着疑问进时序分析——库里错一格表,几千条路径的 slack 一起错,排查代价比在库侧拦截高两个数量级。
这一篇在知识体系里的位置
本篇是 eda/ 目录库数据线上「交付闸门」一环:上游是 Liberty 特征化流程(.lib 的生产侧)与 标准单元 PDK 库视图(库里各视图的配套关系),同层是 Liberty NLDM/CCS 时序模型 和 Liberty 视图格式(被编译内容的语义),下游接 Signoff STA 与 PrimeTime 的库加载与 MMMC 多角配置。库过了 lib db 编译这道闸门,后面所有时序数字才有可信度可言。
总结
lib db 编译是 .lib 进签核前的三道闸门——语法解析(报错行常非真凶,向上查括号配对与非法字符)、语义检查(missing arc 先跨 corner 对照判断是漏跑还是结构性无弧,模板引用错多源于库 merge 时模板被覆盖)、序列化回读(抽样单元逐格比对 .db 与 .lib 表值,跨 corner 锁定索引网格,编译器与签核工具版本组合写入基线);宁可把问题拦在库侧,也绝不给编译器加 waiver 带病进签核。