层次化引脚分配:block 级引脚位置、金属层与缓冲的分配策略,feedthrough 协同与 budget 时序的联动
更新时间:2026-10-05。层次化引脚分配(hierarchical pin assignment)是把顶层设计里的 block 抽象成黑盒之后,第一件真正决定物理质量的事:block 边界上几百到几千个接口引脚,每个摆在边的哪一段、落在哪一层金属、要不要在边界内测打一级缓冲——这三个决定一旦定稿,block 内部的布局规划和 top 层的通道布线就都围着它转。这一篇把分配策略讲透:引脚位置怎么贴着数据流摆、金属层怎么按走线方向选、feedthrough(穿越复用)怎么和 pin guide 协同省布线资源,以及最容易被低估的一条——引脚方案和时序 budget(时序预算)是同一枚硬币的两面,必须同轮迭代。读之前建议先有 层次化 STA 与块接口 和 channel 与 abutted 层次化布图 的基础,时序切分侧见 自顶向下 block 时序预算。
本文要回答的问题
- block 引脚的「位置、层、缓冲」三件套各自影响什么,谁先谁后?
- feedthrough 复用和 pin guide 引导怎么协同,能省多少布线资源?
- 引脚分配与时序 budget 为什么必须同轮迭代,分开做会发生什么?
- 引脚方案在流程什么阶段冻结,晚改一轮的返工成本曲线长什么样?
- 评审一份引脚分配结果,按什么清单逐项过?
一、引脚三件套:位置、层、缓冲各管什么
把一个 block 当成黑盒看,它的每个接口引脚有三个物理属性要定,而且这三个属性的决策顺序有讲究。
第一是位置:引脚落在 block 四条边中的哪一条、边上的哪一段。位置的判据只有一个——让信号从 top 层来源到这个引脚的走线最短、最不绕。一组和北侧 block 对话的总线,引脚就该集中在北边缘且按对端的引脚顺序排好(排反了就是一组交叉飞线,通道里白白吃掉十几条走线轨道);通往 block 内部模块 C 的引脚,位置还要考虑 C 在 block 内部的大致方位——引脚放在南边缘而 C 贴北边,信号进 block 先纵穿整个 block 再开始干活,block 内部时序还没开始就背了一段冤枉延迟。位置决策因此是「双向看」的:向外看 top 数据流方向,向内看 block 内部宏单元摆放草案。这就是为什么引脚分配必须在 block 内部布图有初稿之后、定稿之前做——见 布图与宏单元摆放。
第二是金属层:引脚落在哪层金属上。先进工艺下金属层分方向——M2/M4/M6 走水平、M3/M5/M7 走垂直(具体层对随工艺而变),引脚的层直接决定它「出门」时朝哪个方向走线最顺。北边缘的引脚信号往北走(垂直方向),落在奇数垂直层可以零过孔直出;落在水平层就要先打孔换层再拐弯,多两个过孔、多一段拥挤区的局部绕线。高层金属(M7/M8 以上)电阻低、轨道宽,适合走时钟、复位、长距离总线这类对延迟和压降敏感的引脚;低层留给短距离、数量大的普通信号。层分配还有一根硬约束:block 引脚层不能和 top 层该区域的 power strap(电源条带)打架,引脚落在被电源条带整片覆盖的层上,等于这个引脚实际不可达。
第三是缓冲:要不要在 block 边界内侧给这个引脚打一级 buffer(缓冲器)或 inverter 对。边界缓冲的价值是双面的——对内,它给 block 内部逻辑一个确定负载,内部时序不被 top 走线长度牵着走;对外,它增强驱动能力,长通道走线不至于把边沿拖垮。代价也直白:多一级缓冲就是多 30~80ps 的固定延迟(视驱动强度和工艺角而定),预算紧张的接口(比如高频时钟域间的同步接口)加不起。工程上的默认口径是:数据总线、控制信号默认打缓冲;时钟引脚不打普通缓冲,交给时钟树规划;双向三态引脚的缓冲结构单独评审。
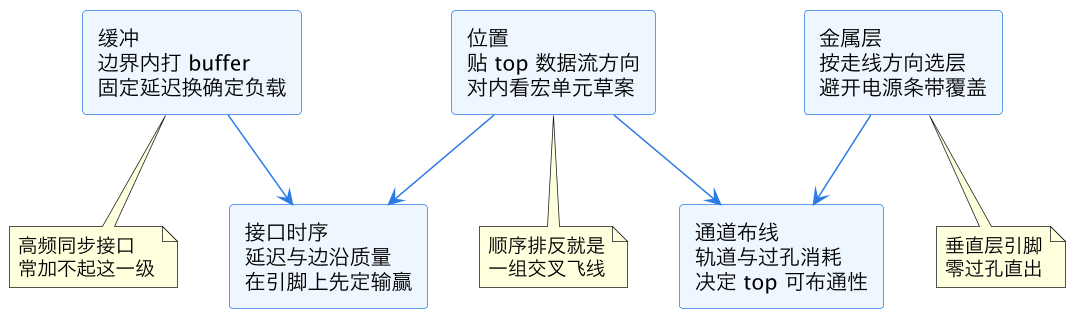
这张图把三件套和它们的作用面分开画:位置和缓冲主要砸在接口时序上,位置和层主要砸在通道布线上。注意位置出现在两条链路上——它是三件套里唯一同时影响时序和布线的属性,所以位置决策最先做、也最难回改。
二、feedthrough 与 pin guide:让穿越信号少打一半孔
block 多了以后,top 层会出现一类尴尬信号:起点在 block A、终点在 block C,但两点之间的直线被 block B 挡着。绕路(从 B 旁边的通道兜过去)是一种解法,但通道宽度是稀缺资源,绕路信号多了通道就要加宽,芯片面积跟着涨。feedthrough 是另一种解法:让信号直接穿过 block B——在 B 的两侧边缘各放一个引脚,内部一段走线加两级缓冲把信号接力过去。B 自己不用这个信号,纯粹当一回「桥梁」。
feedthrough 不是免费的。它消耗 B 的引脚预算(B 的边缘段落是有限的)、占用 B 内部的走线轨道和少量面积,还要在 B 的时序模型里如实建模这段穿越延迟——接口逻辑模型 ILM 与 ETM 里 feedthrough 路径的延迟标注不准,top 级时序分析就会算错。所以 feedthrough 的决策原则是:只给「绕路成本明显高于穿越成本」的信号用——跨 die 长连线、宽总线、通道已经饱和的方向;短距离、通道宽松的信号老老实实走通道。
pin guide(引脚引导)是配合 feedthrough 和常规分配的手工干预机制:工程师在 top 布图阶段给某些信号组画出「期望路径走廊」,分配引擎据此把引脚成组地约束在指定边段和层上,而不是全靠引擎自动摆放。自动引擎的弱点在全局观——它逐条优化单个引脚的局部代价,容易把一组本应齐头并进的 64 位总线拆到两个不相邻的边段上,top 层再把它们并到一起时就要拧麻花。pin guide 把「这一组信号必须成组、按位序排列、走这条走廊」的意图显式喂给引擎,结果立刻规整。经验数字:宽总线和 feedthrough 信号用 pin guide 显式约束后,通道里的过孔数和绕线长度通常能砍掉三成到一半,而付出的代价只是规划阶段多花一两天画引导。
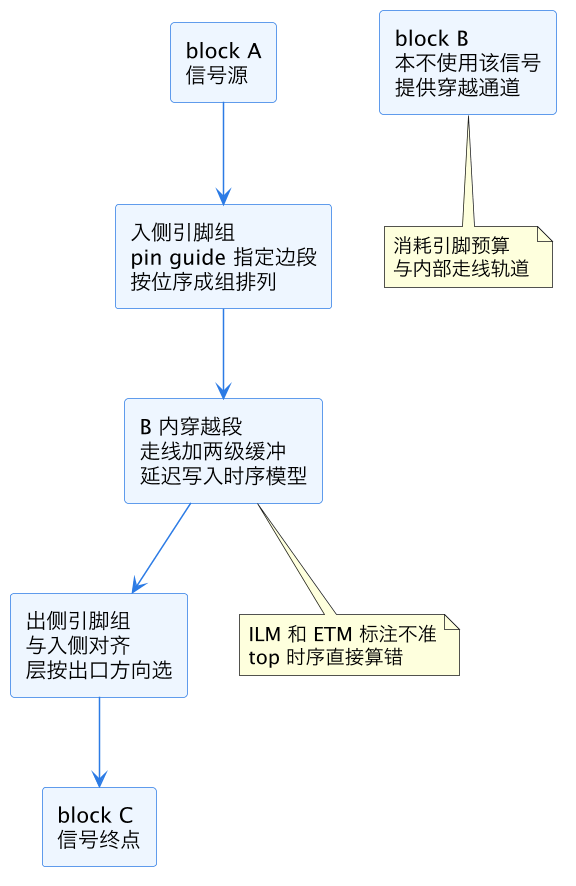
这张图是 feedthrough 穿越一个 block 的完整链路。盯住两个引脚组:入侧和出侧必须在位置上对齐、在层上按各自出口方向选——对齐靠 pin guide 的成组约束,层选择回到第一节的三件套判据。feedthrough 方案一多,block B 的引脚预算就会被「别人家的信号」吃掉一大块,这类预算要在 block 任务书阶段就写明白,不能等 B 的负责人自己发现边缘被占满了再扯皮。
三、引脚分配与时序 budget:同一枚硬币的两面
层次化设计的时序收敛靠 budget 切分:top 把每条穿越 block 边界的时序路径的总预算(比如 800ps)切成三段——源 block 内部一段、top 通道走线一段、目的 block 内部一段,各段分别下发成 set_input_delay / set_output_delay 形式的接口约束。这套机制的细节见 自顶向下 block 时序预算 和 IO 时序 budget 约束。问题在于:通道走线那一段的延迟不是凭空估的,它直接由引脚位置决定——引脚摆在离对端 3mm 的边段和 8mm 的边段,通道延迟能差出 200ps 以上。于是产生了一个鸡生蛋结构:budget 切分需要引脚位置才能估准通道段延迟,而引脚位置要贴着时序关键路径摆才能少走弯路——两件事互相依赖,分开做必然来回返工。
正确的做法是同轮迭代。第一轮:用零级草案引脚(引擎按连通性自动摆放)加统计线长模型切一版粗 budget,关键诉求是把「哪条路径紧、紧多少」先暴露出来。第二轮:带着时序关键度重新分配引脚——最紧的路径,引脚优先摆到离对端最近的边段、落低阻高层金属、酌情免缓冲;宽松的路径往后排,吃剩下的边缘资源。用新引脚位置重算通道延迟,回切第二轮 budget。通常两到三轮之后引脚方案和 budget 就互相咬合了:每条关键路径的通道延迟和它的预算段基本匹配,没有「路径预算富余 300ps 但引脚被摆在最远端」这类错配。
分开做的典型事故是这样:budget 团队按均匀线长假设切好接口约束下发,各 block 拿着约束埋头收敛;两周后引脚分配定稿,一批引脚因为边缘资源竞争被摆到了远端,通道延迟比 budget 假设多出 250ps——而这些路径的 block 内部段已经按紧约束优化完,没有余量可挤。结局只有两个:要么 block 返工重收敛(时序已经见底,只能插缓冲重做布局),要么 top 承认失败加宽时序例外。两个结局都比同轮迭代多花一个数量级的人力。
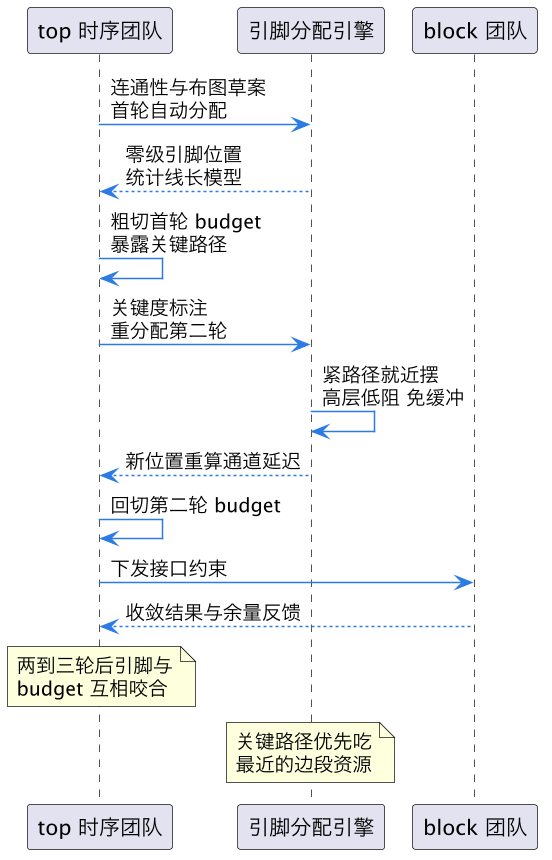
这张时序图是引脚与 budget 同轮迭代的协作链。注意回路的方向:每一轮都是「引脚位置 → 通道延迟 → budget 重切 → 关键度反馈 → 引脚重摆」,单向走一遍就下发是事故的前置条件。block 团队拿到的是迭代收敛后的接口约束,而不是第一拍的草案。
四、返工成本曲线:引脚方案什么时候冻结
引脚方案的修改成本随流程阶段指数上涨,这条曲线值得背下来。布图规划阶段改一个引脚位置,成本是分钟级——引擎重跑一遍,连带影响的只有 top 通道草案。block 布局布线启动后改引脚,成本涨到人天级:block 内部接口段的缓冲、第一层走线、有时连同附近的单元摆放都要跟着动。block 时序签核完成后再改,成本是人周级——接口时序模型(ILM/ETM)要重生成、block 内部时序要重收敛、top 级 STA 要重跑,若此时 top 通道也已布线,还要叠加 top 侧的重布线。而到了 ECO 后期或已流片阶段,引脚位置的改动基本不可行,只能用时序例外或性能降级消化。
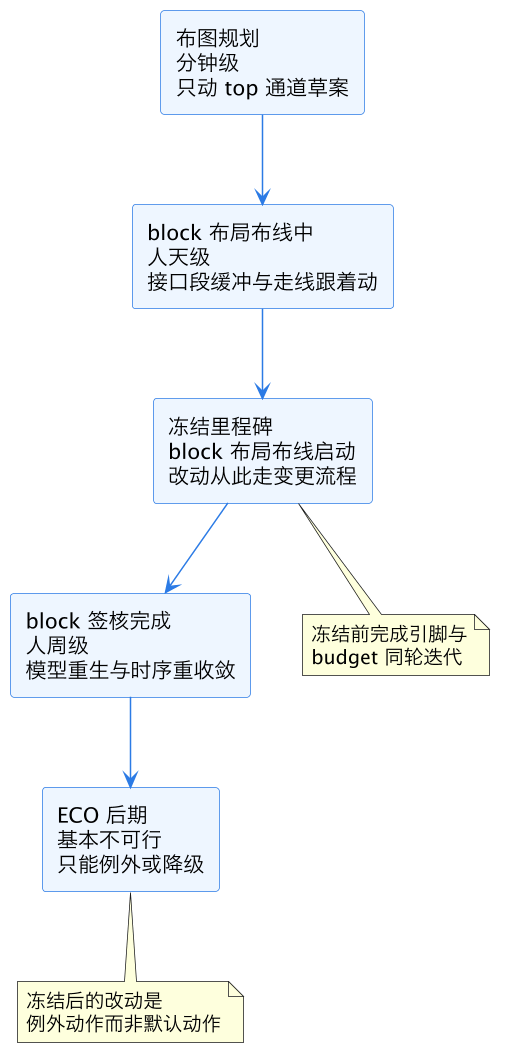
这张图把返工成本曲线画成一条单行道:冻结里程碑是分水岭,左侧改动便宜、右侧每一级都带上更多的连带面。流程设计的目标很朴素——让所有引脚决策都发生在分水岭左侧。
这条曲线决定了流程纪律:引脚分配必须在「block 布局布线启动」这个里程碑之前冻结,冻结前完成引脚与 budget 的同轮迭代;冻结之后再改引脚要走正式变更流程,评估受影响的 block 和 top 两侧的范围。冻结不是「永不许改」——层次化 ECO 的 block 与 top 同步 讲的就是冻结后怎么有控制地改——而是「改动从默认动作变成例外动作」。
| 流程阶段 | 改一个引脚的成本量级 | 连带影响面 |
|---|---|---|
| 布图规划 | 分钟级 | top 通道草案 |
| block 布局布线中 | 人天级 | block 接口段缓冲与走线 |
| block 签核完成后 | 人周级 | ILM/ETM 重生成、时序重收敛、top STA 重跑 |
| ECO 后期 | 基本不可行 | 只能时序例外或性能降级 |
五、评审清单:一份引脚分配怎么过评审
引脚分配定稿前的评审按五组问题逐项过。第一组是位置:每组宽总线的引脚是否成组、按位序、和对端顺序一致;时序关键路径的引脚是否拿到了离对端最近的边段。第二组是层:每个引脚的层是否顺它的出口走线方向;有没有引脚落在电源条带整片覆盖的层上;时钟和高频信号是否分到了低阻高层。第三组是缓冲:数据和时钟的缓冲策略是否分明;双向引脚的结构是否单独审过;feedthrough 路径的缓冲级数是否与 delay 预算匹配。第四组是 feedthrough:每个穿越是否都有「绕路成本更高」的明确理由;被穿越 block 的引脚预算是否超支;穿越延迟是否进了时序模型。第五组是 budget 咬合:抽样最紧的二十条接口路径,通道延迟估计与 budget 切分段是否一一对应,有没有「预算松但位置差」的倒挂。
五组都过,引脚方案才允许冻结进入下一阶段。评审的结论和抽样数据留档——后面任何一次引脚变更,都拿这份基线做影响面对照。
这一篇在知识体系里的位置
本篇是 eda/ 目录层次化设计线里专讲 block 接口物理规划的一篇,处于布图规划与时序 budget 的交汇点:上游接 channel 与 abutted 层次化布图 的 block 摆放结果和 布图与宏单元摆放 的内部草案,同层与 自顶向下 block 时序预算(时序侧的同一枚硬币)、引脚可达性与可布线设计(block 内部视角的引脚话题)、feedthrough 缓冲插入(穿越段的缓冲细化)并列,下游落地到 层次化 STA 与块接口 的接口时序验证、层次化 ILM 与 ETM 的模型生成,以及变更侧的 层次化 ECO 的 block 与 top 同步。握住引脚三件套和同轮迭代纪律,block 接口就从「签核前夜的惊喜来源」变成「最早冻结、最不用回头」的那部分设计。
总结
层次化引脚分配的核心是把 block 每个接口引脚的位置、金属层、缓冲三件套一次定对:位置双向看(外贴 top 数据流、内贴宏单元草案),层按出口走线方向选并避开电源条带,数据默认打边界缓冲、时钟高频免打;feedthrough 只给绕路成本更高的信号用、靠 pin guide 成组对齐省下过孔与绕线,穿越延迟必须如实写进时序模型。引脚方案与时序 budget 是同一枚硬币的两面——通道延迟由引脚位置决定、budget 切分又反过来指导引脚重摆,必须两到三轮同轮迭代到互相咬合再下发;返工成本从布图阶段的分钟级涨到签核后的人周级,所以引脚在 block 布局布线启动前冻结,冻结后改动走正式变更流程,评审按位置、层、缓冲、feedthrough、budget 咬合五组清单逐项过才放行。