set_input_delay / set_output_delay:IO 约束到底在约束什么?OpenSTA 两跑对照实测
更新时间:2026-10-28。本文是「集成电路大类 · 芯片设计」中间层(intermediate)的一篇实验文。约束写法的基础篇 SDC 时序约束入门:create_clock 到 set_false_path 讲了 SDC 的语法骨架,报告的读法在 读懂 STA 报告:arrival、required 与 slack 一篇有逐字段拆解。但有一个问题那两篇都没展开:只写
create_clock的约束文件,STA 工具看到的世界是不完整的——芯片的输入端口不是信号的原点,输出端口也不是终点。本篇用 OpenSTA 对同一块网表跑两遍实验,一遍只有时钟约束、一遍补上 set_input_delay / set_output_delay,让报告里 slack 的变化自己说话。
本文要回答的问题
- set_input_delay / set_output_delay 约束的物理对象是什么?为什么叫「外部延时」?
- 不写 IO 约束时,STA 工具默认了什么?这个默认有多乐观?
- 加了 IO 约束后,报告里的最差路径和 slack 会怎么变?
- 「虚时钟」(virtual clock)是什么,什么场景必须用?
先把两跑的核心结论摆上来,四个数字全部出自后文报告原文:
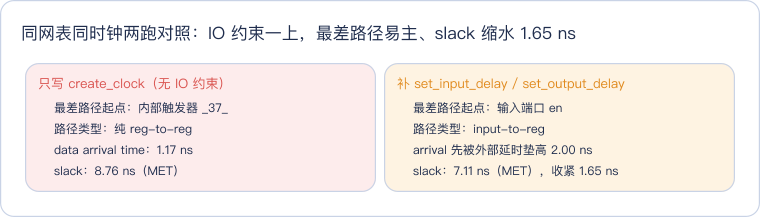
这张对照卡的读法:左栏(红)是「约束缺一半」时工具给出的世界——它眼里只有寄存器到寄存器的路径,输入端口上的信号被默认成「0 时刻准时到达」;右栏(橙)补上 IO 约束后,en 端口那条 2 ns 的外部延时被计入 arrival time,最差路径立刻从内部触发器换到输入端口。网表一个门都没动,动的只是约束,slack 就少了 1.65 ns——少的这部分不是电路变差了,而是上一遍报告里根本没算它。
一、IO 约束在约束什么:芯片边界外的世界
先想清楚一个事实:STA 工具分析的对象是「这一颗芯片」的网表。输入端口 en 上的信号什么时候到?这取决于板子上游那颗芯片什么时候把数据打出来、走线飞了多久——这些信息全在网表之外。set_input_delay 2.0 [get_ports en] 的意思是:相对时钟沿,en 上的数据最晚在外部消耗 2 ns 才到达本芯片的引脚。同理,set_output_delay 1.5 [get_ports q] 声明的是:q 上的数据离开引脚后,下游还要花 1.5 ns 去飞线、去满足下游触发器的建立时间。
用波形把这笔「预算账」画出来最直观。下面这张图里,clk 是本芯片时钟(周期 10 ns),en_ext 是上游芯片数据相对于时钟沿的外部延时窗口,en_pin 是数据真正出现在本芯片引脚上的时刻,capture 是片内触发器的捕获沿:
读这张图抓住一个减法:10 ns 的时钟周期是总预算,set_input_delay 2.0 先从里面扣掉 2 ns 给芯片外部,剩下的才是片内组合逻辑可以挥霍的空间。不加这条约束,工具默认外部耗时为 0——等于默认上游芯片和 PCB 走线都是瞬时完成,这在任何真实系统里都不成立。输出侧对称:set_output_delay 是给下游预留的预算,扣法相同。
所以 IO 约束的本质不是「优化项」,而是把芯片放回系统里的记账动作。漏掉它,时序报告就是在真空里算的。换个角度说,这两条约束是芯片设计者唯一能影响「别人怎么和我对接」的方式——上游板级工程师改不了你的门,你也改不了他的走线,SDC 里这两行数字就是双方在时序上的合同文本。合同写松了,芯片出厂就翻车;写紧了,团队为不存在的问题白白加班。后文的实验会让「写与不写」的差别变得具体可感。
二、数值从哪里来:把上游数据手册翻译成纳秒
很多初学者卡住的不是语法,而是「这个 2.0 该填多少」。input delay 的标准算法是一条加法链,每一环都有出处:
input delay = 上游器件的 clk-to-q(tCO)+ 板级走线飞行时间 + 连接器/封装等附加延时
举一个贴近本实验的算账例子。假设上游是一颗 CPLD,数据手册给出 tCO(时钟到输出有效)最大 1.2 ns;PCB 上这段走线长 120 mm,按 FR4 板材信号速度约 6 ps/mm 估算,飞行时间约 0.7 ns;再留 0.1 ns 给连接器,合计 2.0 ns——这就是 set_input_delay 2.0 的来历。注意这里用的是最大值:建立时间检查关心的是「最晚多晚到」,所以每环都取上限。
output delay 对称,但减法的对象换成下游:output delay = 下游走线飞行时间 + 下游接收器件的建立时间(tSU)。下游触发器要求数据在时钟沿前 1.0 ns 稳定,走线再飞 0.5 ns,那么本芯片的 q 就必须提前 1.5 ns 把数据准备好,set_output_delay 1.5 由此而来。
| 环节 | 建立时间(max)取值 | 保持时间(min)取值 |
|---|---|---|
| 上游 tCO | 数据手册最大值 | 数据手册最小值 |
| 走线飞行时间 | 最长走线/最慢速度 | 最短走线/最快速度 |
| 下游 tSU / tHOLD | tSU 全额计入 | tHOLD 以负值进入 min 约束 |
| 对应 SDC | set_input_delay -max | set_input_delay -min |
这张表点出一个常被忽略的配套关系:max 约束管「别太晚」(建立),min 约束管「别太早」(保持)。只写 max 不写 min,等于告诉工具「数据最快在 -∞ 时刻就到了」,保持时间检查会放过一大批本该报红的路径。真实约束文件里这两条总是成对出现;本实验为聚焦对照效果只演示了 max 方向的账本,min 方向的推法完全对称。
三、实验设计:同网表同时钟,只差两行约束
被测设计刻意选得极简——一个带使能的 8 位计数器,三个输入端口(clk、rst_n、en)、一个 8 位输出 q:
module sta_demo (
    input  wire       clk,
    input  wire       rst_n,
    input  wire       en,
    output reg  [7:0] q
);
    always @(posedge clk) begin
        if (!rst_n) q <= 8'h00;
        else if (en) q <= q + 1;
    end
endmodule
RTL 用 Yosys 0.9 综合到 sky130_fd_sc_hd 标准单元库(tt_025C_1v80 角),得到门级网表后交给 OpenSTA。两跑共用同一份网表、同一个 10 ns 时钟,唯一区别是第二份脚本多两行 IO 约束:
# 跑 A:只有时钟
create_clock -name clk -period 10.0 [get_ports clk]
report_checks

# 跑 B:时钟 + IO 约束
create_clock -name clk -period 10.0 [get_ports clk]
set_input_delay  -clock clk 2.0 [get_ports {rst_n en}]
set_output_delay -clock clk 1.5 [get_ports q]
report_checks
这个设计的干净之处在于:输入端口 en 到内部寄存器的组合路径,和内部 reg-to-reg 路径,在网表里经过的是同一批组合门(and4 → nand4 → or3 → a21boi 四级)。也就是说,两遍报告如果最差路径不同、slack 不同,差异可以百分之百归因于约束,没有任何电路变量的干扰。
还有两处实验设定需要交代清楚,避免读者误读数字。一是报告里的 clock network delay (ideal):本次分析在理想时钟假设下进行,时钟树延时与偏移为零,这是综合后、布局布线前的标准做法——时钟树尚未存在,算出来的网络延时反而是干扰项。二是工艺角固定为 sky130 的 tt_025C_1v80(典型管、25 度、1.8 V),两级门的延时数值只在这个角下成立;换到 ss 慢角,所有单元延时整体变大,但本实验的「约束差 → slack 差」传导关系不变,因为它是纯粹的账本加法。
四、第一跑:没有 IO 约束时,工具看到什么
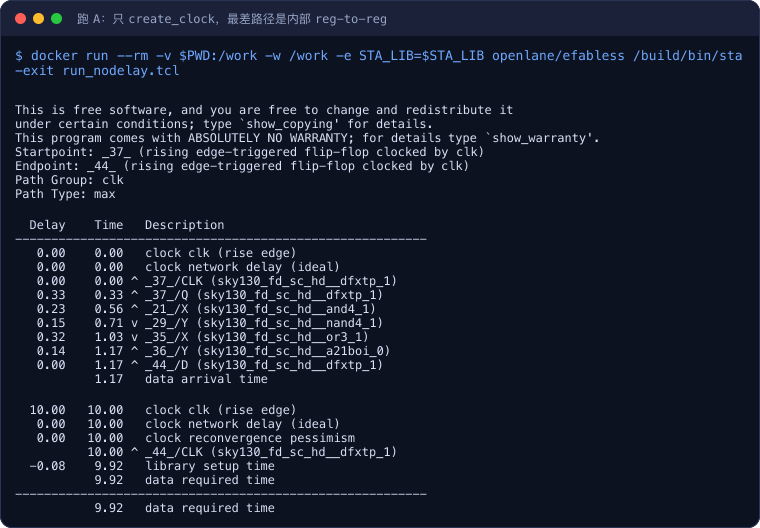
这份报告的读法抓三点。第一,Startpoint: _37_ (rising edge-triggered flip-flop)——最差路径的起点是内部触发器,说明在工具眼里输入端口上的路径「不值得报告」:没有 input delay,en 到寄存器那条路的 arrival time 就是从 0 时刻起算的纯片内延时(1.17 ns 里 0.33 ns 还是 37 自己的 clk-to-q),永远不可能比 reg-to-reg 路径差。第二,data arrival time 1.17 对 data required time 9.92(10 ns 周期减去 0.08 ns 的库建立时间),slack 8.76 ns,MET。第三,也是最容易被误读的——这个 8.76 ns 的「宽裕」有一部分是幻觉:它假设 en 上的数据在时钟沿那一刻准时出现在引脚上,上游零耗时。
真实项目里这种报告是典型的「假绿」。constraint 审查时抓的就是这类漏洞:报告全 MET,但 check_timing 里一堆 unconstrained endpoint,或者像本篇这样干脆只有 reg-to-reg 路径出现在报告里——STA 报告里 endpoint unconstrained 怎么排查 一篇处理的就是同一族问题的另一半。
五、第二跑:IO 约束一上,最差路径易主
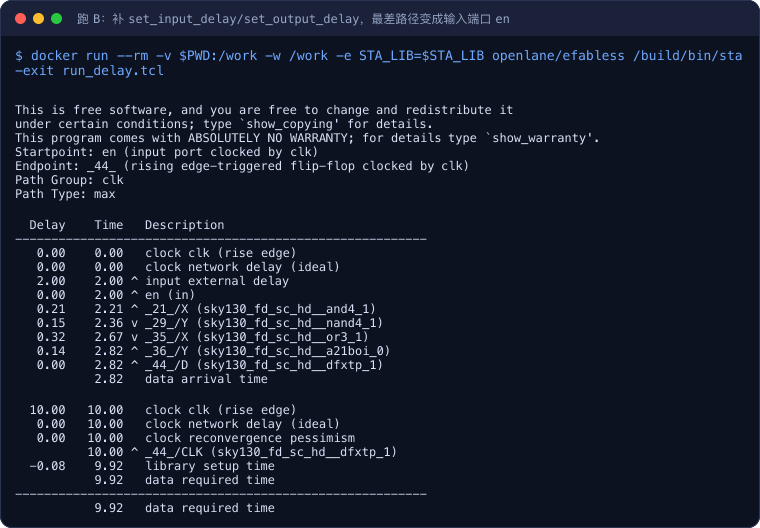
对照上一跑,变化一目了然。报告头变成 Startpoint: en (input port clocked by clk)——最差路径的起点从内部触发器换成了输入端口。看 arrival time 的累加过程:
   0.00    0.00   clock clk (rise edge)
   0.00    0.00   clock network delay (ideal)
   2.00    2.00 ^ input external delay
   0.00    2.00 ^ en (in)
   0.21    2.21 ^ _21_/X (sky130_fd_sc_hd__and4_1)
   0.15    2.36 v _29_/Y (sky130_fd_sc_hd__nand4_1)
   0.32    2.67 v _35_/X (sky130_fd_sc_hd__or3_1)
   0.14    2.82 ^ _36_/Y (sky130_fd_sc_hd__a21boi_0)
2.82 data arrival time注意第三行:input external delay 2.00 直接垫在路径最前面,信号还没进芯片,arrival time 已经是 2.00 ns。之后经过的四级门(0.21 + 0.15 + 0.32 + 0.14 = 0.82 ns)与跑 A 里 37 之后的路径是完全相同的物理门——跑 A 里这段路的片内部分从 0.33 ns(clk-to-q)起算,跑 B 里从 2.00 ns 起算,于是 arrival time 从 1.17 涨到 2.82,required time 不变(9.92),slack 从 8.76 收紧到 7.11,差值 1.65 ns 恰好等于 input delay 2.0 减去 clk-to-q 0.33 再扣掉 en 引脚零延时与 37/Q 起点之间 0.02 的走线差。约束没有让任何一级门变慢,它只是把账记全了。
这个对照同时解释了为什么 IO 路径常常是时序收敛的重灾区:片内路径的预算敌人是别的逻辑,IO 路径的敌人是「片外那口锅」——上游芯片的 clk-to-q、板级走线、连接器,全压在你这一条 arrival time 上。2 ns 的 input delay 在本实验里已经算温和,高速接口上 5 ns 以上的外部预算比比皆是。
还有一个细节值得从报告里挖出来:跑 B 的最差路径易主,意味着修复方向也跟着变了。跑 A 的世界里如果想继续提频,优化对象是 37 到 44 之间那四级组合逻辑(换更快单元、插寄存器切流水);跑 B 的世界里瓶颈在 en 这条输入路径,2 ns 的外部延时是物理现实、改不动,能动的只剩片内那 0.82 ns——在 en 引脚后立刻打一拍寄存器,把 input-to-reg 路径切成「引脚到边界寄存器」加「寄存器到内核」两段,是最常见的 IO 时序收敛手法。约束不仅改变报告数字,还改变你下一步该干什么,这正是「假绿」报告的危害所在:它会把优化火力引向根本不是瓶颈的地方。
六、虚时钟:当上游时钟不在你的网表里
上面两跑的 set_input_delay -clock clk 都挂在真实时钟 clk 上,这在「上游与本芯片共同时钟」时是正确写法。但很多场景下,上游器件的时钟根本不是本设计的端口——比如本芯片只有一个自由振荡的 PLL 时钟,而数据来自一颗按自己节奏走的 ADC。这时 -clock clk 表达不了「上游时钟与我的捕获沿之间的相位关系」,SDC 给的解法是虚时钟(virtual clock):一个只在约束文件里声明、不驱动任何网表对象的时钟。
create_clock -name vclk -period 8.0
set_input_delay  -clock vclk 1.2 [get_ports adc_d]
虚时钟存在的唯一意义,是让 STA 能算出「发射沿(虚时钟)到捕获沿(真实时钟)」之间最紧的那组相位对齐,包括两钟不同周期、不同相位时的最坏情况。写 IO 约束时的决策可以归纳成一张表:
| 场景 | 写法 |
|---|---|
| 上下游共用同一时钟源(源同步以外最常见) | -clock 挂本设计的真实时钟 |
| 上游时钟不在本网表、但周期相位已知 | 建虚时钟,-clock 挂虚时钟 |
| 输入有 max/min 两种界限(慢速/快速角) | set_input_delay -max / -min 分开写 |
| 只关心部分端口,其余确实无时序要求 | 明确 set_false_path 或 set_max_delay,不要靠「不写」漏掉 |
最后一条值得多说一句:「不写约束」不等于「不检查」,它等于「默认零延时地检查」——工具照样会算这条路径,只是按最乐观的假设算,然后给你一个漂亮的 MET。想真正排除一条路径,要用显式的时序例外,这与 多周期路径与伪路径:set_multicycle_path / set_false_path 一篇讨论的是同一套「显式表态」哲学。
工程实践里还有三个高频误用值得列出来。其一,只约束「用得上的端口」:rst_n 这类异步复位看似与时钟无关,但如果它在模块内参与了同步释放逻辑,漏掉 input delay 照样留下盲区,本实验的跑 B 把 rst_n 与 en 一起约束就是这个考虑。其二,把板级延时估成零再留裕量:有人在 input delay 里填 0、然后给整条路径套一个拍脑袋的 set_max_delay,结果两层假设叠在一起,出了问题查无可查——每一环延时都要有出处,数据手册、走线长度、仿真,而不是「感觉差不多」。其三,多时钟端口只挂一个时钟:同一个数据端口在不同时钟域下被采样时,要为每个相关时钟各写一条带 -add_delay 的约束,否则后写的一条会把先写的覆盖掉,工具只检查最后那一组相位关系。
这一篇在知识体系里的位置
- 语法基础:SDC 时序约束入门(create_clock / generated clock / 时序例外的完整语法骨架);
- 报告读法:读懂 STA 报告:arrival、required 与 slack(本篇两跑报告的逐字段解释以那篇为准);
- 同族排错:STA 报告里 endpoint unconstrained 怎么排查(约束漏写的另一种暴露形式);
- 进阶方向:IO 约束收紧后的收敛手段(端口处打拍、IO 寄存器 packed 进 pad)与时序例外的配合,见 时序收敛基本功。
一句话总结
set_input_delay / set_output_delay 约束的是芯片边界之外的延时——把上游发射、板级走线、下游捕获这几笔账从时钟周期里先扣掉,剩下的才归片内逻辑。OpenSTA 两跑对照实测:同一 sky130 网表、同一 10 ns 时钟,无 IO 约束时最差路径是内部 reg-to-reg、slack 8.76 ns;补上 set_input_delay 2.0 与 set_output_delay 1.5 后,最差路径换成输入端口 en,arrival time 被外部延时垫高 2 ns,slack 收紧到 7.11 ns。漏写 IO 约束不是「不检查」,而是按零外部延时的乐观假设给你一个假绿;上游时钟不在网表里时,用虚时钟把相位关系显式告诉工具。
实验环境
- 机器/系统:云主机 / Ubuntu 22.04(eda-golden-v1 镜像,OpenLane docker 环境)
- 工具版本:OpenSTA 2.4.0(41a51eaf4c,镜像内
/build/bin/sta,版本行照抄日志头部);网表由 Yosys 0.9(git sha1 1979e0b)综合,目标库 sky130_fd_sc_hd__tt_025C_1v80 - 日期:2026-10-28
- 完整命令:
- 综合:
yosys -p 'read_verilog sta_demo.v; synth -top sta_demo; dfflibmap -liberty $STA_LIB; abc -liberty $STA_LIB; clean; write_verilog sta_demo_net.v' - 跑 A:
docker run --rm -v $PWD:/work -w /work -e STA_LIB=$STA_LIB openlane/efabless /build/bin/sta -exit run_nodelay.tcl - 跑 B:同上命令,脚本换
run_delay.tcl
- 综合:
代码获取
被测 RTL、两份 OpenSTA 脚本与两跑完整报告已同步到公开仓库:geek-doc.cn/experiments/opensta-input-output-delay。克隆后按 README 先跑 Yosys 综合生成 sta_demo_net.v,再按上面两条 docker 命令分别执行 run_nodelay.tcl 与 run_delay.tcl,即可复现本文全部数字。