EDA 作业调度与 LSF:算力和许可证才是 nightly 回归的真正上限(G3)
本篇讲工具背后的计算基础设施:一次综合/P&R/签核为什么动辄几十核跑几小时,团队怎么用 IBM Spectrum LSF(Platform LSF)/SLURM/SGE 把有限服务器与商业 license 调度开。作业产物如何组织、结果如何回收见 X4 数据管理、X5 看板,CI/CD 化见 G5。
一、为什么 EDA 作业又重又长
| 任务 | 计算特征 |
|---|---|
| 仿真回归(A1) | 海量独立用例,每个可并行,单核为主、吃内存/IO |
| 逻辑综合(C1) | 多线程 + 大内存,百万门要数十 GB |
| P&R(D1) | 多线程 + 大内存,布线/优化可分布式,单 run 数小时 |
| STA 签核(E1) | 多 scenario 可分布式到多机(分布式多角分析),单机多核 |
| 物理验证(E3) | 数据可按窗口切分,高度多机并行(distributed processing) |
| SPICE(F1) | 矩阵求解,多核/多机,极吃内存 |
规律:单工具内多线程(shared memory,受限于内存带宽与并行收益)+ 跨场景/切窗的多机分布式(distributed / farm)。一个先进 SoC 的 nightly 可能要几千个核时,个人工作站根本撑不住,必须靠计算集群。
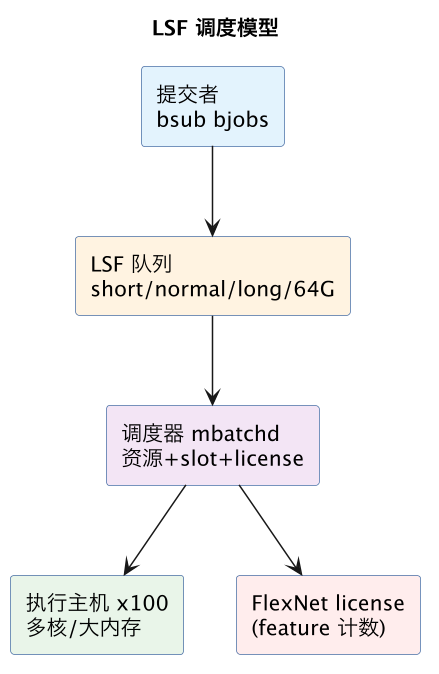
二、LSF 的基本心智模型
LSF 把作业(job)投递到队列(queue),调度器按资源请求把作业分到合适的执行主机:
# 典型投递:要 16 核、64G 内存、用 dc_shell 跑综合
bsub -q normal -n 16 -R "rusage[mem=4000]" \
     -R "select(cs && cm)" \
     -L "/bin/bash" ./run_synth.sh
# 常用:bjobs 看状态、bkill 杀、bqueues 看队列、lshosts/lsload 看负载
关键概念:
- slot:一台主机能同时跑多少任务的配额(常≈核数,可按内存细分);
- 资源(-R):显式声明要多少内存、什么机型、是否同机
span[hosts=1],避免作业挤爆内存被 OOM; - 队列分层:short(交互/快速,抢占优先)、normal、long(过夜大 run)、大内存/特殊机队;
- 依赖/阵列:作业间依赖(
-w 'done(prev)')、阵列作业(-J "sim[1-500]")一次投几百个回归用例; - 抢占式(preemption):高优交互任务可抢占低优批量任务,保证工程师白天调试。
SLURM(sbatch/squeue)、SGE(qsub)模型类似,命令不同;很多团队在其上再包一层自研流程脚本。
三、许可证(license)是另一道硬配额
商业 EDA 工具按 feature(特性) 在 FlexNet(FlexLM)服务器上计数:买了 4 个 dc_shell 令牌,全公司最多 4 个并发综合。LSF 可把 license 当作可调度资源(ELIM/lsb.resources):
- 作业声明
rusage[dc_shell=1],调度器同时确认「有空闲 slot + 有空闲 license」才启动,避免机器等到了却卡在等 license、或反过来; - 排队失败常见两类:PEND 在等资源(
bjobs -l看原因:slot/mem/license 不足)vs 起来后报 license 超时(LM_LICENSE_FILE/端口、ssh 环境没继承、feature 名写错、license 守护进程挂); - 子 feature 陷阱:基础编译器和高级选项(如某 signoff 模式、某 advanced 引擎)是不同令牌,主 feature 有空不等于高级特性有空;
- 教训:脚本里作业结束要确保工具退出释放令牌,异常挂死的进程会长期占着 license(要人工
lmstat定位、清僵死)。
四、多线程 vs 多机:别让 -n 骗了自己
- 设了
-n 16不代表工具真用 16 核——还要工具侧开关(如set_host_options -max_cores、P&R 的-multi_cpu、仿真的-j/多进程)。两边都配对才有并行; - 线程扩展并非线性:内存带宽、共享数据结构使 16→32 核可能只快 20%,占了 slot 却浪费;要按工具的扩展性曲线选核数;
- 多机分布式(Calibre 的
runsets -drc -turbo、PT 的 distributed multi-scenario)需要共享文件系统/高速网络与数据切分开销,任务太短反而不划算; - 内存是比核数更常见的杀手:综合/布线峰值内存若超过
rusage[mem]或主机物理内存 → 被杀(OOM)或疯狂 swap,表现为「莫名其妙变慢/挂死」。
五、与流程/回归的衔接(G5 自动化的地基)
调度系统是 自动化 G5 的执行后端:
- 夜间定时或代码合入触发,投递阵列作业(几百用例、十几个签核 scenario);
- 每个作业产出落到以 run id/版本组织的目录(X4),日志/报告回收;
- 聚合器收集 PASS/FAIL、QoR 指标(X5、X1 门禁),失败自动重投(机时型 flaky:主机坏/许可证抖动);
- 资源利用率、排队时长本身要监控——吞吐瓶颈常在集群/license 而非工具,加人不如加令牌、调队列。
六、常见坑速查
| 现象 | 多半是 |
|---|---|
| 作业一直 PEND | 无空闲 slot/内存,或 license 资源被占满(bjobs -l) |
| 起来后 license 报错 | 环境变量没传到非交互 shell、feature 名/端口错、守护进程挂 |
| 核给了没加速 | 忘了开工具侧多线程开关;或扩展性已饱和 |
| 跑到半夜被杀 | 内存超 rusage/物理内存被 OOM;检查峰值 mem |
| license 被长期占满 | 僵死工具进程没退出,lmstat 找出来清掉 |
| 分布式比单机还慢 | 任务太短、网络/共享盘慢、切分开销大于收益 |
相关与延伸
- 自动化与回归:G5 ASIC CI/CD。
- 产物与指标:X4 数据管理、X5 QoR 看板、X1 交接门禁。
- 重负载任务本体:C1 综合、D1 P&R、E1 STA、E3 Calibre、F1 SPICE。
总结
EDA 算力模型是「工具内多线程 + 跨场景/切窗的多机分布式」两层叠加:仿真回归天然是几百个可并行的独立用例,P&R/综合/SPICE 吃多核和数十 GB 内存,而多角 STA 和 Calibre 物理验证最适合把 scenario 或版图窗口撒到集群上,于是团队用 LSF/SLURM 把作业经队列按 slot、内存、机型请求分派到执行主机;真正决定 nightly 吞吐的是两道配额——机器资源和 FlexNet 按 feature 计数的商业 license,成熟流程把 license 也登记成可调度资源并确保异常退出时释放令牌;排障要分清 PEND 在排队还是起来后 license 报错,并牢记 bsub -n 必须和工具侧多核开关配对、核数扩展非线性、内存超限 OOM 才是半夜挂死的头号原因,最后让调度系统成为 CI/CD 的执行后端,把阵列作业、按版本落盘的产物与 QoR 聚合连成闭环——很多时候瓶颈在集群和许可证,不在 EDA 工具本身。