SV solve before soft:约束求解顺序与 soft 默认值冲突解决全解
更新时间:2026-09-28。在 约束随机验证 里,randomize() 被当成黑盒:写一堆 constraint,求解器吐一个合法解。但黑盒有两条暗线决定解长什么样——变量之间的求解顺序,以及默认约束的优先级。这一篇拆开 SV solve before soft 这两个机制:
solve ... before ...控制谁先取值,soft让默认值在冲突时自动退让。它们是 constraint 与 inside/dist 基础 之上最常用的两个调优开关。
本文要回答的问题
- 没有 solve before 时,求解器按什么顺序给变量取值,为什么这会影响分布?
- solve before 到底改变了什么——是可行性,还是仅仅概率分布?
- soft 约束和普通约束冲突时会发生什么,为什么 soft 不会导致 randomize 失败?
- 用 soft 写默认值、用内联约束临时覆盖,这种写法和 constraint mode 开关相比好在哪?
- solve before 和 soft 组合使用时有哪些典型场景和坑?
一、为什么需要关心求解顺序
理想情况下约束求解是「声明式」的:你描述合法解的集合,求解器从里面挑一个。但 SystemVerilog 标准并没有承诺均匀采样整个解空间,LRM 只保证解满足所有约束。实际求解器为了效率,往往按某种内部顺序逐个变量定值:先给 A 随机一个合法值,再在这个前提下给 B 挑值。顺序不同,联合分布就不同。
最经典的例子是这一对变量:
class pkt;
  rand bit [7:0] addr;
  rand bit [7:0] len;
  constraint c_range { addr + len <= 8'hFF; }
endclass
两个约束联立,解空间是一个三角形区域。如果求解器先取 addr(在 0~255 均匀),addr 取到 250 时 len 只剩 0~5 可选;先取 len 则反过来。两种顺序下 (addr, len) 的联合分布完全不同,而你写的约束里没有任何一句说明你想要哪一种。不指定顺序时,不同仿真器、甚至同一仿真器的不同版本可能给出不同分布——这正是 随机稳定性与种子管理 讨论的可复现性问题的一个来源。
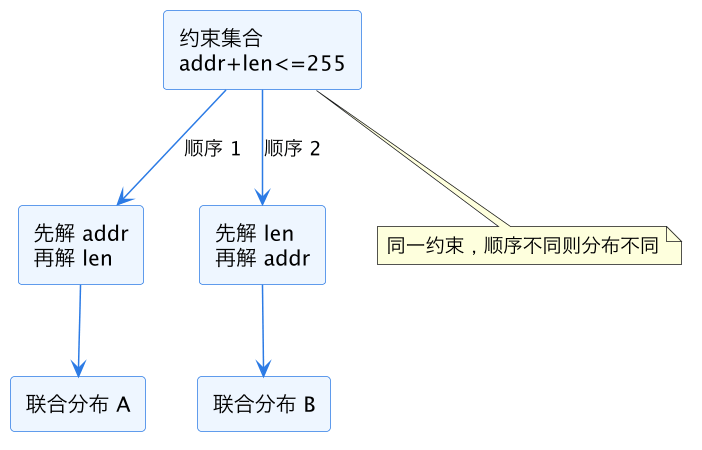
上图的关键是:解空间本身没变(两个分布的合法解集合完全相同),变的是采样概率。所以「没写 solve before 但功能都对」并不代表没问题——功能覆盖率可能在悄悄偏向某个角落,corner case 迟迟打不到。
二、solve before:显式钉住求解顺序
solve x before y 告诉求解器:先确定 x 的值,再在 x 已定的前提下确定 y。语法直接写在 constraint 块里:
class burst_txn;
  rand bit [3:0] burst_len;
  rand bit [7:0] size_bytes;
  constraint c_order  { solve burst_len before size_bytes; }
  constraint c_limit  { size_bytes <= (burst_len + 1) * 4; }
endclass
solve before 的语义有两个层面,必须分开理解。
第一,它不改变解空间。任何满足全部约束的组合仍然是合法解,加了顺序约束不会把某个原本合法的组合排除掉。这一点常被误解成「solve before 是更强的约束」——不是,它只是采样策略。
第二,它改变边缘分布。被 solve 到前面的变量,先按它自己的约束(不含后解变量参与的联立约束)均匀采样;后解的变量只能在前者划出的剩余空间里挑。上例中 burst_len 在 0~15 均匀分布,然后 size_bytes 在 [0, (burst_len+1)*4] 内取。如果没有 solve before,求解器内部实现可能让 size_bytes 的边缘分布更接近均匀,代价是大 burst 配大 size 的组合被稀释。
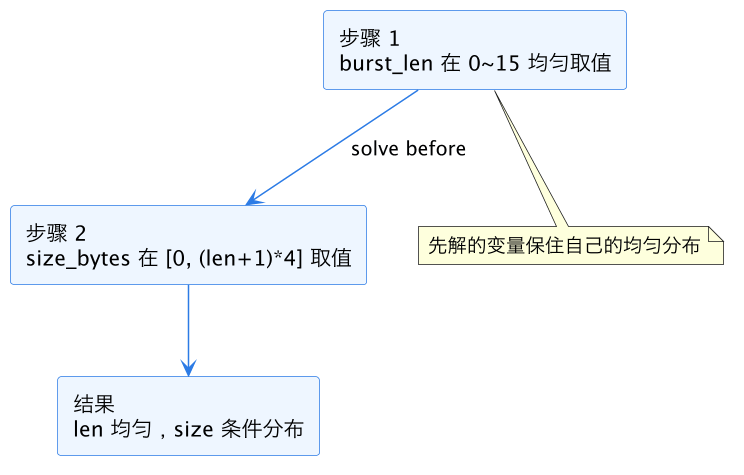
工程上最常用 solve before 的场景是「控制字段先行」:先定传输类型、再定地址范围,先定包数、再定每包长度。凡是「B 的合法区间依赖 A」的链式关系,把 A solve 到前面,A 的分布才不受 B 拖累。链可以写长:solve op before addr before len; 等价于两条顺序约束的合取。
还有一个性能层面的收益:顺序明确的约束,求解器搜索空间被分层剪枝,复杂约束下 randomize 耗时会下降。反过来,如果 solve before 把几乎所有变量串成一条长链,等于把联合求解退化成了顺序采样,极端情况下会失去联立约束的「全局视角」——比如「所有字段异或等于某值」这种真正需要联立求解的约束,中间任何一环被先钉死都可能让最后一环无解,即便全局看解是存在的。顺序约束只加在确实需要控制分布的地方,别当成性能万能药。
三、soft:会退让的默认约束
普通约束是硬性的:任何一条不满足,randomize 直接返回 0。soft 关键字给约束降了优先级——它表达「默认希望这样,但与别的约束冲突时可以让步」:
class apb_txn;
  rand bit [31:0] addr;
  rand int          wait_cycles;
  constraint c_default_wait { soft wait_cycles == 0; }
  constraint c_addr_align   { addr[1:0] == 2'b00; }
endclass
wait_cycles 默认取 0(零等待,最快路径),但任何人都可以在 randomize 时用内联约束覆盖它:
// 定向场景:这个用例要测等待态
assert(t.randomize() with { wait_cycles inside {[3:7]}; });
内联约束 wait_cycles inside {[3:7]} 与 soft 的 == 0 冲突,求解器静默丢弃 soft 约束,randomize 成功。如果 == 0 不是 soft,这次 randomize 会失败返回 0,测试在断言处挂掉。这就是 soft 存在的意义:把「默认值」和「硬性规则」在类型上区分开,覆盖默认值不需要改类、不需要 constraint_mode 开关。
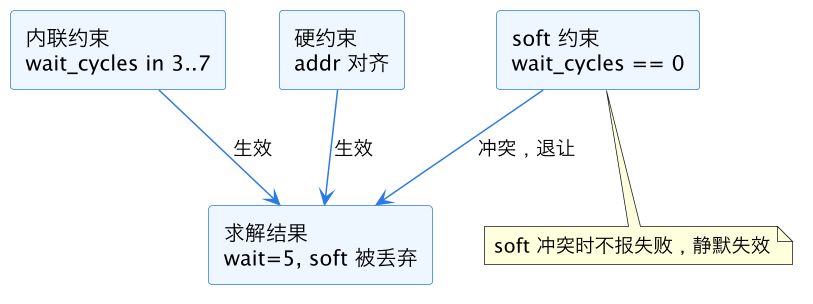
冲突解决按「优先级分层」进行:硬约束必须全部满足;soft 约束之间如果互相冲突,求解器按 LRM 规定的顺序(大致是先出现的优先)丢弃后面的,直到剩余 soft 集合自洽。两条 soft 互相矛盾时哪条活下来,依赖声明顺序——这是隐蔽的坑,见第六节。
四、soft 的典型用法:默认值、可覆盖的基线
soft 最自然的落地模式是「基类给默认值,派生类或用例按需推翻」:
class axi_txn;
  rand bit [2:0]  size;
  rand bit [7:0]  len;
  rand bit [1:0]  burst;
  // 基线:单拍、4 字节、INCR——最常见的普通传输
  constraint c_base {
    soft size  == 3'h2;      // 4 bytes
    soft len   == 8'h0;      // single beat
    soft burst == 2'b01;     // INCR
  }
endclass

// 长 burst 用例:只覆盖 len,size 和 burst 的默认值仍然生效
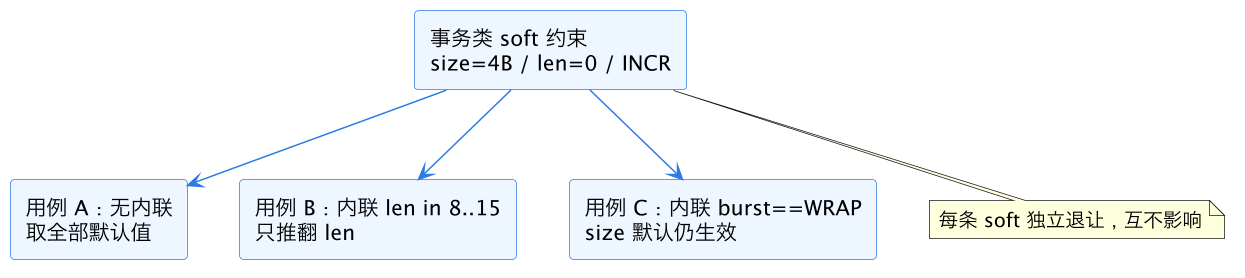
assert(t.randomize() with { len inside {[8:15]}; });
注意这个写法的收益:三条 soft 互相独立,内联约束只推翻了 len 那一条,size/burst 的默认值不受影响。如果用 constraint_mode(0) 关掉整个基线约束块,三条会一起消失,还得手工补回另外两条。soft 把覆盖粒度从「约束块」细化到「单条约束」。
另一个高频场景是 sequence 里的公共基线。一个 sequence 库提供 base sequence,里面 randomize() with 了一堆 soft 风格意图——但内联 with 里没有 soft 关键字,内联约束永远是硬的。正确做法是把基线写回事务类的 soft 约束里,或者由 base sequence 只设字段提示、派生 sequence 再 randomize。让 soft 待在类里,是它发挥作用的唯一位置。
五、solve before 与 soft 的组合
两个机制经常出现在同一个类里,分工是:solve before 管分布形态,soft 管默认值与可覆盖性。一个寄存器写事务的例子:
class reg_write;
  rand bit [15:0] reg_addr;
  rand bit [31:0] wdata;
  rand int        pre_delay;

  // 顺序:先定地址,再定数据(data 的合法掩码依赖 addr 选中的寄存器)
  constraint c_order { solve reg_addr before wdata; }
  // 基线:写前不等待;特殊寄存器按掩码约束数据
  constraint c_soft  { soft pre_delay == 0; }
  constraint c_mask  {
    reg_addr == 16'h0010 -> wdata[31:16] == 0;  // 该寄存器高 16 位保留
  }
endclass
组合时有一个语义要点:soft 被丢弃只发生在「与同优先级或更高优先级约束冲突」时;solve before 是求解顺序指令,不与任何约束比优先级,两者互不干扰。真正要留意的交互是顺序对 soft 生效概率的影响——如果 wdata 被 solve 到前面先取了一个随机值,后面 c_mask 这种蕴含约束可能反过来限制 reg_addr 的可选集,默认值类 soft 的命中率就跟着变了。分布相关的验证计划(比如「默认路径占 70%」)写完约束后应跑一小段采样统计实际占比,别凭约束文本心算。
| 机制 | 改变什么 | 不改变什么 | 失败行为 |
|---|---|---|---|
| solve before | 变量取值顺序、联合/边缘分布、求解性能 | 合法解空间 | 无失败概念,纯指令 |
| soft | 约束优先级,提供可覆盖默认值 | 不满足时的语法形态 | 冲突时静默丢弃,不报 0 |
| 普通硬约束 | 合法解空间本身 | 分布(交给求解器) | 任一不满足则 randomize 返回 0 |
| constraint_mode(0) | 整块约束的开关(粗粒度) | 约束文本 | 关掉的约束不参与求解 |
这张表是选型依据:要默认值用 soft,要分布形状用 solve before,要整个场景切换用 constraint_mode 或 factory 覆盖(见 UVM factory 与环境派生),各管各的层。
六、常见坑
- 以为 solve before 会缩小解空间:不会。怀疑「加了顺序约束丢解」时,把 solve before 注释掉重跑,合法解集合一模一样,变的只是采样频率。
- 两条 soft 互相矛盾,靠声明顺序定生死:
soft a == 1;与soft a == 2;共存时后者被丢弃。重构约束块、调整顺序后会静默翻转默认行为,review 时把 soft 约束集中放置并注明意图。 - 在内联 with 里找 soft:内联约束不支持 soft 关键字,永远是硬的。想要可覆盖的默认值,只能写进类定义。
- soft 与 implication 混用时的意外:
soft (mode == A -> len == 4)整条是 soft,mode 取 A 时若 len 被内联钉成 8,整条蕴含被丢弃,而不是「len==4 部分退让」。蕴含写进 soft 前想清楚退让粒度。 - solve before 成环:
solve a before b; solve b before a;是编译/elaboration 错误,好在这类错会在早期暴露,不会带病运行。 - 把 solve before 当随机稳定性手段:顺序约束固定的是分布意图,不保证跨仿真器一致;跨工具可复现仍要靠种子与版本管理。
- 过度分层拖垮联立约束:CRC、校验和这类「所有字段共同决定一个字段」的约束,被 solve before 拆散后最后一环极易无解或严重偏斜,校验类字段应让它最后自然解出,不要提前钉住输入字段的全部自由度。
这一篇在知识体系里的位置
- 向上承接:约束随机验证 给出 randomize 的整体框架,本篇解释求解器内部的顺序与优先级。
- 横向相关:constraint 与 inside/dist 基础 讲约束怎么写,本篇讲写完之后求解器怎么执行。
- 深入方向:随机稳定性与高级约束技巧 讨论种子、randcase 与更复杂的约束组织。
- 落地延伸:sequence 与 driver/scoreboard 协作 展示这些约束在 sequence 激励中的实际调用形态。
总结
SV solve before soft 是约束求解的两个正交开关:solve before 钉住变量取值顺序、只改分布不改解空间,soft 把默认值降成可退让的低优先级约束、冲突时静默失效而不导致 randomize 失败——前者管「解长什么样」,后者管「默认值能不能被覆盖」,两者配合让基类基线、用例覆盖、分布控制各归其位。