MTP 多 token 预测:DeepSeek 式训练-推理解耦与接受率账本
更新时间:2026-10-04。前面 投机解码接受率与接受长度 讲过投机解码(speculative decoding)的基本盘:小模型先猜、大模型并行验、按接受率赚加速比;EAGLE 与 Medusa 投机头 讲过两种「给大模型长草稿头」的训练方案。这两篇的草稿能力都是推理时后装上去的。DeepSeek-V3 带火的 MTP(multi-token prediction,多 token 预测)走了另一条路:训练阶段就让模型学会一次往后预测多个位置,推理时把多余的预测头拆下来当草稿用。同一个模块,训练时是正则器,推理时是加速器——这就是「训练-推理解耦」的核心卖点。本篇把 MTP 的训练目标、解耦逻辑、接受率账本和与 EAGLE/Medusa 的定位差异讲透。
本文要回答的问题
- MTP 多 token 预测的训练目标到底是什么,它和传统 next-token 目标差在哪?
- 为什么说 MTP 实现了训练-推理解耦,同一个模块在两个阶段各扮演什么角色?
- 推理时把 MTP 头当草稿头用,接受率怎么估,加速比账本怎么算?
- MTP 与 EAGLE、Medusa 三条路线在成本、接受率、侵入性上各站什么位置?
- 工程上部署 MTP 推理要踩哪些坑,值得为它改训练流水线吗?
一、从 next-token 到 MTP:训练目标改了什么
传统语言模型的训练目标一句话就能说完:给定前 t 个 token,预测第 t+1 个。每个位置只对一个未来 token 负责,loss 对所有位置求平均。这个目标简单、稳定、scale 性好,但有个被诟病多年的毛病:模型只被奖励「猜下一个词」,从未被显式要求「规划更远的结构」。写出一段有全局连贯性的代码或证明,靠的是从海量数据里隐式学出长远依赖,而不是目标函数直接教的。
MTP 的思路是把监督信号往未来多推几步。设模型有 D 个 MTP 模块(DeepSeek-V3 用 D=1,即多预测一个位置;早期实验到 D=3),第 d 个模块的任务是:在第 t 个位置的表示基础上,预测第 t+d+1 个 token。总 loss 变成主目标加 D 个辅助目标的加权和:
L = L_main + λ × Σ_d L_mtp_d
关键在实现方式。朴素的「多挂几个输出头」会让每个头直接从同一层隐状态往外读,头与头之间没有因果链——第 2 个头预测 t+2 时并不知道模型自己打算在 t+1 输出什么。DeepSeek-V3 的 MTP 模块做得更讲究:第 d 个模块接收上一个模块的隐状态和第 t+d 个 token 的真实 embedding,过一个小的 Transformer 块再输出。这样在训练时,第 2 个模块是「看着真实第 t+1 个 token」来预测第 t+2 的,保持了因果链的完整,这条链式结构推理时还能反过来当自回归草稿用。

上图里有两个值得盯住的细节。其一,主干权重是共享的,MTP 模块只是在主干出口后挂的小块(参数量通常不到主干的 2%),训练成本增加有限。其二,teacher forcing(教师强制,训练时给模型喂真实答案而非自己的预测)让每个模块的监督信号干净稳定,不存在「错误级联」问题——模块 1 预测错了不影响模块 2 拿到的输入。
MTP 作为训练目标本身的收益,DeepSeek-V3 技术报告给的口径是:下游任务(尤其代码、数学这类需要规划的任务)有可见提升,且 MTP 模块的引入几乎不拖慢训练。Gloeckle 等人 2024 年的 Meta 论文在代码模型上报告过更强的信号:4-token 预测目标让 HumanEval 类基准的 pass@1 提升数个百分点,且模型越大收益越明显——13B 以上才开始稳定赚到。这解释了为什么 MTP 在超大模型时代才火起来:它是个规模友好的正则器,小模型上收益盖不住成本。
二、训练-推理解耦:一个模块,两种人生
MTP 最漂亮的设计不在训练而在「解耦」:训练时它是辅助目标,推理时它是免费的草稿模型,两个阶段对同一个模块的要求完全不同,而 MTP 恰好两边都能伺候。
训练阶段,MTP 模块的角色是「监督信号放大器」。它强迫主干在位置 t 的隐状态里不仅要编码「下一个词是什么」,还要编码「再下一个、再再下一个可能是什么」——这等于给主干的表示能力加了带宽。DeepSeek 的消融实验确认:去掉 MTP 目标,下游分数掉;保留 MTP 但推理时不用它的头,训练收益还在。也就是说,哪怕你永远不做投机解码,MTP 训练也是值的。
推理阶段,角色完全翻转。decode 的瓶颈是逐 token 串行:每产一个 token 都要把几百亿参数的主干完整跑一遍,访存 bound 让 GPU 算力大量闲置(背景见 KV cache 推理显存 里对 decode 访存特性的分析)。投机解码的解法是用便宜的草稿模型一次猜 k 个,主干一次并行验证 k 个,接受几个就赚几个。而传统方案的痛点是草稿模型要单独训练、单独部署、单独占显存,词表对齐、分布对齐都是坑。MTP 模块天然就是草稿:它和主干共享 embedding、共享词表、在同样的数据分布上训练过,「分布对齐」这个投机解码最大的隐性成本直接消失。

这张图概括了 MTP 的账本结构:一份训练投入,两处收益。对比之下,EAGLE 需要先训完主干再回头训草稿头(两阶段),Medusa 要冻结主干后微调(也是两阶段),外部小模型方案更是要维护两个模型的对齐。MTP 把这些后处理成本压到零——前提是你愿意在训练之初就把 MTP 写进目标函数。这也是「解耦」一词的另一层含义:决策时间点解耦了,训练团队不需要知道推理团队要不要投机解码,反正模块训出来白送。
三、推理时怎么用:链式草稿与接受率账本
把 MTP 模块当草稿头用,推理流程长这样:主干正常 decode 一步得到 token t+1 后,MTP 模块 1 吃主干隐状态和 t+1 的 embedding,自回归地猜出 t+2;有第二个模块就接着猜 t+3。猜完 k 个候选后,把这 k 个 token 拼进序列,主干一次前向并行验证——验证时每个位置的输出和草稿比对,从头开始连续命中几个就接受几个,第一个失配位置由主干的正确输出补上,其余丢弃。下一轮换新的起点继续。
这里的关键指标是接受率(acceptance rate)和它的派生量期望接受长度——投机解码接受率与接受长度 对这套账本有完整推导,这里只给结论:加速比 ≈ 期望接受 token 数 ÷(草稿成本 + 一次主干验证成本)。草稿成本小(MTP 模块只有一两个小 Transformer 块)、验证成本约等于一步正常 decode,所以加速比基本由期望接受长度决定:每轮平均接受 1.8 个 token,吞吐就接近 1.8 倍。
DeepSeek-V3 报告的数字是:单个 MTP 模块(猜 1 个额外 token)在自测集上的接受率约 85%~90%。这是个相当高的数——外部草稿模型通常只有 60%~75%,原因正是分布对齐:MTP 模块和主干是「同一个大脑的两个深度」,猜的自然更准。但注意链式外推的衰减:模块 1 猜对 t+2 后,模块 2 是在「假设 t+2 猜对」的前提下去猜 t+3 的,而推理时喂给它的是模型自己预测的 token 而非真实 token,误差会级联。第二个 token 的条件接受率通常掉到 70% 上下,第三个更低。期望接受长度 = 1 + p1 + p1×p2 + ...,p1=0.87、p2=0.7 时约 2.5 个 token,实际端到端吞吐提升在 1.7~1.9 倍区间(要扣除验证失配浪费的算力)。
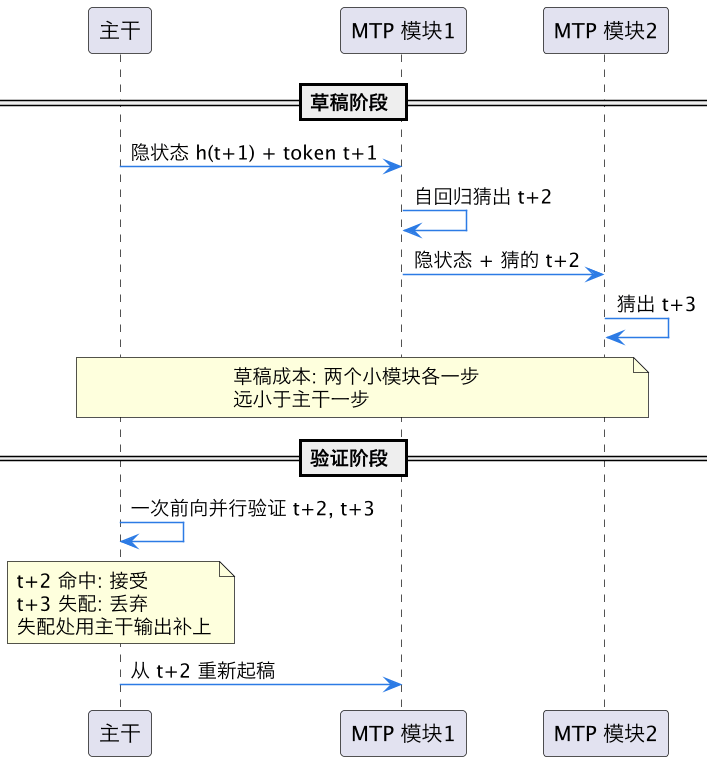
上图的「验证一次、接受前缀」机制保证了输出分布无损——投机解码的数学性质决定接受/拒绝规则不影响最终文本分布,这点所有方案(MTP、EAGLE、外部草稿)都一样。MTP 的差异只在效率侧。
另一个常被忽略的账本细节:MTP 模块推理时可以灵活裁剪。训练了 2 个模块不代表推理要用 2 个——接受率随深度衰减,而每多一层草稿和验证都要付算力,最优草稿深度是负载的函数:GPU 越闲(batch 小),猜得越深越赚;batch 大了算力饱和,投机解码的验证开销会把收益吃回去,此时应该减深度甚至关掉。DeepSeek 推理部署里 MTP 就是可开关的,这个「按负载调节」的弹性是外置草稿模型很难做到的(外置方案关掉草稿就纯亏部署成本,MTP 关掉只是不用而已)。
四、和 EAGLE、Medusa 摆在一起:三条路线的定位
MTP 不是唯一的「自带草稿」方案,把它和 EAGLE 与 Medusa 投机头 摆一张表,定位差异立刻清楚。
Medusa 最简单粗暴:给主干最后一层并行挂 k 个独立输出头,头 d 直接预测 t+d+1。头间无因果链(第 2 个头不知道第 1 个头猜了什么),所以接受率偏低,要靠树状注意力(tree attention,把多个头的候选组织成树一起验证,见 树注意力草稿验证 kernel)来挽回——多个头给出的是「候选集合」而非单链,验证时在树里找最长命中路径。Medusa 的训练是冻结主干只训头,侵入性低,适合给已训好的开源模型「后装」。
EAGLE 走的是「轻量自回归草稿头」:一个小模块吃主干的隐状态序列,自回归地逐 token 起草,输入里带特征层信息所以猜得准,接受率是后装方案里最高的。代价是训练流程两阶段、特征对齐要调。
MTP 的位置:接受率接近 EAGLE(同分布红利),训练侵入性在训练期(一次搞定)但推理期零侵入。它的硬约束是必须在预训练时就决定要用——给 LLaMA 这种没训过 MTP 的模型,你无法事后白拿草稿头,只能走 Medusa/EAGLE 的后装路线。
| 维度 | MTP(DeepSeek 式) | EAGLE | Medusa |
|---|---|---|---|
| 草稿来源 | 训练期自带的 MTP 模块 | 训后外挂自回归头 | 训后外挂并行多头 |
| 训练侵入 | 预训练目标函数改动 | 两阶段,冻结主干训头 | 两阶段,冻结主干训头 |
| 单步接受率 | 高(约 85%~90%,同分布) | 高(特征级对齐) | 中低(头间无因果链) |
| 深度扩展 | 链式,随深度衰减 | 链式,随深度衰减 | 靠树验证补深度 |
| 推理侵入 | 零(模块已在权重里) | 部署额外草稿模块 | 部署额外头 + 树验证 |
| 适用场景 | 自研模型从头训 | 给现成模型提接受率上限 | 给现成模型低成本后装 |
表里最后一行就是选型结论:自己从头训模型,MTP 几乎是默认该开的功能(训练收益独立成立,推理能力白送);给别人训好的模型加速,才轮到 EAGLE 和 Medusa 按预算二选一。三者不是竞品而是「不同决策时间点上的同一类技术」。
五、工程落地:MTP 推理要算清的三笔账
第一笔是显存账。MTP 模块本身参数小,但投机验证要求主干一次前向处理 k+1 个位置,激活和 KV 写入量按位置数放大。batch 大时这部分开销与 batch 延迟吞吐曲线 描述的非线性区叠加,高并发下投机解码可能反而降吞吐——验证失配的算力是纯浪费。实务口径:低并发、延迟敏感场景开 MTP 全速;高并发吞吐场景把草稿深度降到 1 或关掉。
第二笔是调度账。投机解码让「每轮产出的 token 数」变成随机变量(接受几个不确定),continuous batching 调度器要为此处理变长步进——batch 里每个请求前进的距离不同,KV cache 的分配和回收节奏全被打乱。vLLM 系框架对投机解码的支持长期滞后于普通 decode,原因就在这里:不是验证逻辑难,是变长步进把整个内存管理搞复杂了。调度侧的细节可以对照 continuous batching 调度器 的轮次模型来理解。
第三笔是评测口径账。MTP 的接受率高度依赖数据分布:代码、模板化文本接受率高(可预测性强),创意写作、高随机采样(temperature 高)接受率骤降——采样温度越高,主干的分布越平,草稿猜中的概率越低。所以厂商报告的「1.8 倍加速」要看测试集和采样参数;自家业务上线前,必须用真实流量在目标 temperature 下实测接受长度,再决定草稿深度。想进一步压低草稿成本,还可以参考 草稿模型训练 里的蒸馏思路,把 MTP 模块往更小的方向蒸。

把这三笔账和第四节的对照表合起来,MTP 的工程画像就完整了:训练期一份投入换表示能力,推理期零部署成本换可开关的投机加速,代价是接受率要按场景实测、调度器要支持变长步进。对自研大模型的团队,这几乎是没有理由不做的买卖;对用现成模型的团队,MTP 是「别人的福利」,你的战场在 EAGLE 和 Medusa。
这一篇在知识体系里的位置
本篇是投机解码系列的第三条腿:上游基础是 投机解码接受率与接受长度(加速比账本的通用推导,本篇的接受率分析全靠它)和 EAGLE 与 Medusa 投机头(后装草稿方案的对照系);同层配合 树注意力草稿验证 kernel(Medusa 路线补深度的手段,MTP 走链式所以用不上,但对比着看能理解为什么链式接受率天然更高)、草稿模型训练(外置草稿的训练方法学);系统侧关联 KV cache 推理显存、continuous batching 调度器 和 batch 延迟吞吐曲线(三笔工程账各自的展开)。
对读者的落地建议:评估 MTP 先问自己一个问题——模型是不是自己训的。是,就把 MTP 写进训练目标,推理侧按负载动态调草稿深度;不是,MTP 与你无关,去 EAGLE 和 Medusa 里按预算选型。无论哪条路,上线前的接受率实测都必须用真实流量,厂商数字只能当下限参考。
总结
MTP 多 token 预测是 DeepSeek-V3 带火的「训练-推理解耦」设计:训练时给主干挂链式 MTP 模块、把监督信号往未来多推几步(λ 加权的辅助 loss),主干表示能力和下游分数因此变好,这份收益独立成立;推理时同一个模块零成本变身草稿头——与主干同词表同分布,单步接受率高达 85%~90%,链式外推虽有衰减,配一次并行验证仍能换来 1.7~1.9 倍 decode 吞吐;与 EAGLE(训后自回归头)、Medusa(训后并行多头 + 树验证)相比,MTP 的胜负手是「预训练期一次投入、推理期零部署成本」,代价是必须自研模型从头训,且工程上要算清显存放大、变长步进调度、按真实流量实测接受率这三笔账。