STA 报告分诊:每天几千条违例先分类再批处理的评审流程
更新时间:2026-10-07。布线后每一轮 nightly 回归跑完,signoff STA(静态时序分析,不跑仿真、靠模型穷举所有时序路径的检查方法)都会吐出几千条违例:setup、hold、max_transition、max_capacitance 混在一起。新人拿到这份报告的典型反应是从第一条开始逐条看,三天看了两百条,第四天一刷新报告全变了。STA 报告分诊要解决的就是这个场面:报告解析与入库的自动化手段见 STA 报告解析自动化,那篇回答「怎么把报告变成数据」;本篇回答「拿到数据之后怎么排兵布阵」——先分类、再批处理、逐条精修只留给头部少数。
本文要回答的问题
- 几千条违例按什么维度分类,才能让每一类对应一种固定打法?
- 为什么说「逐条看报告」是收敛期最大的工时黑洞?
- 批处理具体怎么操作:一类违例一条命令还是一次 ECO?
- 每天的分诊评审会怎么开,十分钟内怎么定完全天分工?
一、为什么必须分诊:违例数量与人力的数量级错配
先看一组典型数字。一个五百万实例规模的设计,布线后第一轮全 corner 全模式回归,常见产出是:setup 违例三千到八千条,hold 违例五千到两万条,max_transition(最大转换时间,信号翻转快慢的约束)违例上千条,外加若干 max_fanout 与 max_capacitance。而团队里能修时序的工程师通常三到六人,每人每天能有效处理的「真问题」是十到二十个。也就是说,如果逐条处理,第一轮报告够全组修一个季度——可两周后下一轮回归又到了。
这个错配决定了方法论:不能按「条」分配人力,只能按「类」分配。经验事实是,几千条违例里八成以上可以被不到二十个「根因类」解释——某个时钟域的 skew 没收敛、某类接口逻辑被综合工具复制成扇出怪兽、某层金属的 RC 比预估差。把同根因的违例打包,一次动作消掉几百条,这才是收敛期的真实节奏。
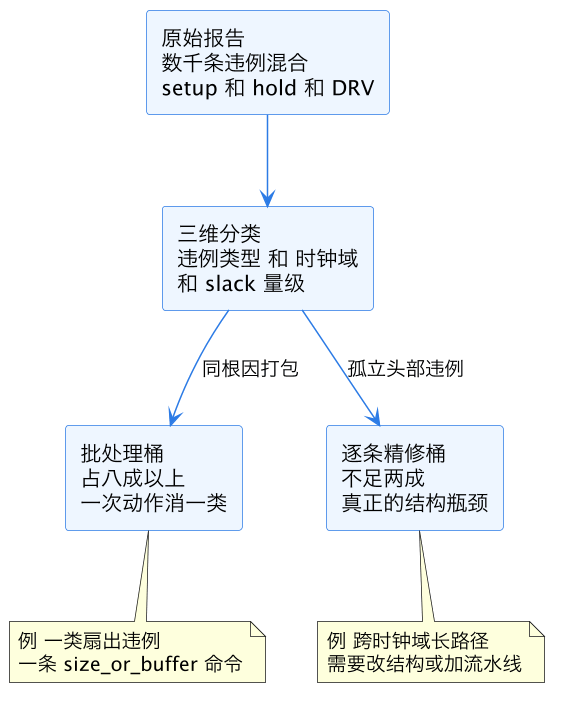
这张图是全篇的主线:分诊的目标不是把报告读薄,而是把报告「分流」——八成以上进批处理桶,按类出招;不到两成进逐条精修桶,那才是值得资深工程师花一下午的东西。下面三节分别展开分类维度、批处理打法与评审节奏。
二、分类维度:类型、时钟域、slack 量级各管一件事
分诊表的第一维是违例类型,因为类型决定修复手段的「性质」。setup 违例是数据到得太晚,修法是加快数据路径或借时间;hold 违例是数据到得太早,修法是插延迟;max_transition 和 max_capacitance 这类 DRV(Design Rule Violation,设计规则违例)是电气特性超标,修法是换驱动或插 buffer,与时序预算无关。三类问题用三套工具链,混在一张表里看只会互相干扰。
第二维是时钟域与物理区域,它决定违例的「归属」。按捕获时钟域聚合违例数,排名立刻暴露问题集中地:常见分布是第一名时钟域独占三成违例,前三名合计过半——这就是本周的攻关清单。再叠加物理区域(按模块或按坐标 bounding box 聚合),如果某时钟域的违例还集中在某个物理角落,那多半是该区域的拥塞或供电问题,一条违例都不用单独看,直接让 PR 同事看那块地。
第三维是 slack 量级,它决定问题的「深度」。把违例按负 slack 分桶:0 到 -50ps 是浅水区,多半是分析悲观度或微小扰动,一轮 ECO 就能推平;-50ps 到 -300ps 是中水区,需要针对性的单元更换与绕线优化;-300ps 以深是深水区,几乎必然是结构性问题——逻辑级数太多、跨层次路径太长、时钟树天生吃亏。深水区违例不进批处理桶,直接升级给架构负责人判断要不要改设计。量级分桶的阈值要按工艺节点校准,先进节点上 50ps 也许就是一两个 buffer 的事,成熟节点上同样问题可能是 150ps。
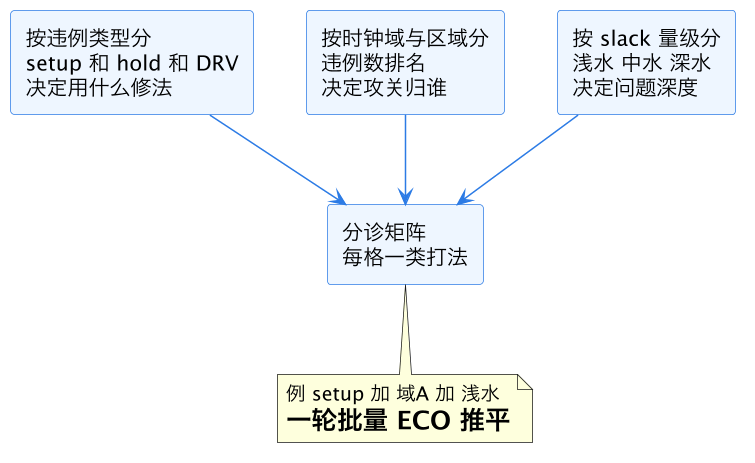
三维交叉就得到分诊矩阵。举个例子坐实它:「setup + 时钟域 A + 浅水区、共 1200 条」这一格,打法就是对该域跑一次批量时序 ECO,预估消掉八成;「hold + 全设计 + 浅水区、8000 条」这一格,打法是先确认分析口径——hold 对时钟公共段抵扣极敏感,很多是分析偏悲观造成的虚报,先按 时序例外 Lint 与评审 里的例外核查清单过一遍,确认没有漏放 false path(伪路径,逻辑上不可能被采样的路径)再谈插 buffer;「setup + 跨域接口 + 深水区、12 条」这一格,直接进架构评审,讨论加流水线还是改握手。
三、批处理打法:一类违例一次动作
批处理的核心纪律是「先验证根因假设,再放量执行」。拿到一个批处理桶,先抽三条代表性违例人工看路径:确认它们共享同一个根因(同一个驱动单元、同一段拓扑、同一个例外缺失),再对整个桶执行统一动作。抽三条而不抽一条,是为了防「桶里混着异类」——一条看不出分布,三条足够暴露。
| 批处理桶 | 典型根因 | 一次动作 | 预期消除率 |
|---|---|---|---|
| DRV transition 桶 | 驱动不足或线过长 | 批量换大驱动或插 buffer | 九成以上 |
| setup 浅水桶 | 单元选型保守 | 批量换 LVT 或 upsize | 六到八成 |
| hold 浅水桶 | 时钟 skew 加悲观度 | 批量插延迟单元 | 七到九成 |
| 接口违例桶 | 预算分配不合理 | 重切 IO 时序预算 | 视协商结果 |
| 例外缺失桶 | false path 漏约束 | 补约束加 Lint 防回归 | 全部 |
表里最后一行值得单独说:例外缺失桶是「零成本收益最大」的一桶——不改任何物理实现,只把真实的设计意图补进约束。它的高收益反过来也是高风险:补错的 false path 会把真违例永远藏掉。所以这条线的纪律是每条新例外必须过评审,具体清单与防回归机制就在 时序例外 Lint 与评审,分诊会上只负责把「疑似例外缺失」的桶挑出来转交,不在会上当场拍板。
还有两个执行细节。一是批处理后必须重跑增量 STA 验证消除率并检查副作用——hold 桶插延迟单元可能压垮邻近的 setup,这类左右互搏在浅水区交界带很常见。二是批处理动作要记录脚本与配置快照,下一轮回归如果同桶复发,有快照才能快速判断是「没修干净」还是「新引入」,这与 签核期时序 ECO 方法学 里环境版本绑定是同一条纪律。
四、逐条精修桶:什么违例值得花一下午
逐条桶只收三类东西。第一类是深水区违例:负 slack 超过阈值、批处理动作救不回来的,要逐条做路径解剖——看逻辑级数分布、看哪一级贡献延迟最大、判断是换结构还是加寄存器切拍。第二类是跨时钟域接口违例:这类路径的约束本身常常语焉不详,修之前要先和前端确认接口协议到底允许多少拍。第三类是「反复复发」的违例:同一终点连续三轮回归都在榜上,说明每次批处理都没碰到真根因,值得一次彻底的人工分析,把它的根因写进项目的问题库,否则它会陪你到 tapeout。
精修的产出不只是「这条修好了」,而是一份可复用的判例:根因分类、修复手段、副作用检查点。判例库攒厚后,新违例分诊会明显加快。
五、每日评审节奏:十分钟分诊会怎么开
分诊要变成日常机制,靠的是固定节奏的短会。每晚回归跑完,解析脚本(手段见 STA 报告解析自动化)自动产出分诊矩阵:每个桶的违例数、与上一轮相比的增减、头部违例清单。第二天早上十分钟站会按矩阵过一遍:哪个桶新增了就问谁负责、批处理动作昨天执行了没有、消除率对不对得上。逐条精修桶的条目在会上一句话分派到个人,不在会上讨论技术细节——细节留到会后的工位上。
| 会议议程 | 时长 | 产出 |
|---|---|---|
| 分诊矩阵环比 | 3 分钟 | 确认收敛方向没反 |
| 批处理桶复盘 | 3 分钟 | 消除率未达标的桶重新归因 |
| 逐条精修分派 | 3 分钟 | 每条有主、有截止日 |
| 新增深水违例升级 | 1 分钟 | 转入架构评审清单 |
这套节奏的关键指标是「桶数收敛」而不是「条数收敛」:条数会随实现迭代大幅波动,桶数(未关闭的根因类数量)单调下降才是真收敛。把每轮的桶数与违例数存进 QoR 看板,趋势判读方法见 时序收敛迭代方法学 的收敛曲线一节——分诊矩阵就是那个方法学在「日」粒度上的落地形式。
这一篇在知识体系里的位置
本篇是 STA 报告处理流水线的「调度层」:上游是 STA 报告解析自动化(把文本报告变成可分诊的结构化数据),同层关联 时序例外 Lint 与评审(例外缺失桶的处置纪律)与 Signoff STA 与 PrimeTime(报告来源引擎);下游衔接 签核期时序 ECO 方法学(批处理桶的物理修复手段)与 时序收敛迭代方法学(分诊指标在收敛曲线中的读法)。
总结
STA 报告分诊的本质是把「几千条违例」翻译成「不到二十个根因类」:按违例类型定修法、按时钟域与区域定归属、按 slack 量级定深度,三维交叉成分诊矩阵后,八成以上违例进批处理桶、一次动作消一类,逐条精修只留给深水区、跨域接口与反复复发的少数硬骨头;配套十分钟日会与桶数收敛指标,让评审从「读报告」变成「管收敛」——先分类再批处理,是收敛期唯一扛得住数量级错配的姿势。