FPGA 原型验证专题 02:多 FPGA 原型系统 ASIC 分区/TDM
本文是 FPGA 原型验证专题第 02 篇。跨片链路见 Aurora 串行协议,平台调试见下一篇 03 原型平台 bring-up 多片点亮/trace,完整方法论见 04 ASIC 原型验证全链路 RTL ID/GateID/层次映射。
一、为什么需要多片 + 核心难题
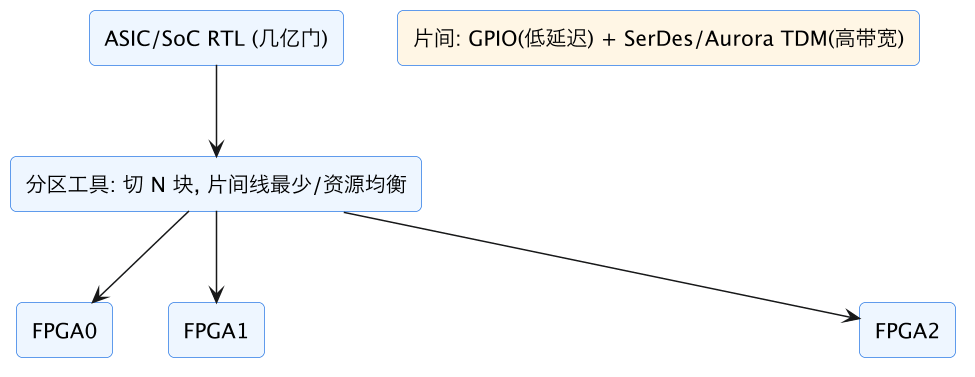
二、三大关键权衡
| 问题 | 方案 | 代价/要点 |
|---|---|---|
| 装不下 | 多片分区 | 紧耦合同片、资源均衡、关键路径不切 |
| 引脚不够 | 跨片信号 TDM 复用到收发器/Aurora | 延迟几十~上百拍→降频 |
| 频率低 | 接受功能验证定位 | OS/软件栈可跑,仿真提速 10^4~10^6 |
三、工程要点
- 时钟/复位:全局时钟分发到各片;跨片信号按同步/异步链路插入握手;
- 存储映射:ASIC SRAM → BRAM/外挂 DDR,容量带宽单独核算;
- 调试可见性:预留 trace 缓冲、JTAG 链复用、工具自动探针路由;
- 容量规划:利用率目标 60~70% 以下(分区开销 20~40% + 调试/迭代 20~30%),引脚/收发器是比门数更早的瓶颈;
- bring-up:逐片、逐链路点亮(见 bring-up 篇)。
四、验证价值边界
| 能验证 | 不验证 |
|---|---|
| RTL 功能、软硬件协同、中断/DMA/协议 | 真实时序(STA 流程负责) |
| 完整软件栈/OS、长时间 soak | 性能上限(原型降频) |
| 真实接口/PHY 系统联调 | 功耗/物理特性 |
| 仿真跑不到的周期数 | — |
五、分区工程学:割集、资源平衡与工具协同
多 FPGA 原型的核心技术问题是一个经典图划分问题:把模块级网表切成 N 块,在“跨片割集最小、各片资源均衡、关键路径不被切、时钟域完整”之间求折中,而实际工程还叠加了物理约束(板上每两片之间有多少收发器/引脚)。理解这一点,就不会把分区当黑盒按钮。割集(cut)的成本由板级互联决定:每个跨片信号若走并行 GPIO 占一根线和相应时序预算,若走 TDM 串行则占用一条收发器链路的一部分带宽并引入固定延迟;因此“片间带宽预算”必须在选型/设计背板时先于分区确定,先有分区结果再抱怨引脚不够是顺序倒置。资源平衡不是平均:BRAM/URAM、DSP、LUTRAM、时钟缓冲和局部布线资源要分别平衡,只看 LUT 会出现某片存储爆满另一片空置;工具通常按多维权重优化,工程师需要根据报告调权重。时钟域完整优先于一切:一个时钟域被切到多片会产生大量跨片同步并改变时序语义,应在 RTL 架构阶段就让大时钟域边界与模块边界对齐,这是最有效的“人工辅助分区”。
人工干预分区有几种高价值手段:把紧耦合的层次(如一个核与其本地缓存)用“同片约束”绑定;把已知关键路径标注为不可切;把物理上连真实外设(收发器、DDR)的模块锁在对应 FPGA;用层次化网表让分区在模块级而不是门级进行(门级割集会产生海量无意义跨片线)。分区是迭代过程:第一次分区报告给出割集和资源分布,按瓶颈做 RTL 调整——把宽总线改成窄的事件/描述符接口、在跨边界处插入 FIFO/寄存器、合并小模块减少边界数——再重新分区,通常需要数轮到十几轮。团队应把每次分区的关键指标(割线数、TDM 比、各片利用率、可达频率)记录成趋势,用于判断 RTL 变更是否在恶化可分性。对于超大规模 SoC,专用原型工具和商业平台(带自动 TDM 宏、自动探针)几乎是必需品;自研流程只在较小规模或特殊拓扑下才划算。
六、TDM 互联的微观机制:延迟、速率与协议语义
时分复用是把成百上千条跨片信号装进少量高速串行管道的技术,理解它的微观机制才能正确设定原型时钟。一条 TDM 链路在发送侧把多组跨片信号按固定时隙轮转:假设复用率 1:N(N 组逻辑信号共享一条物理串行帧),每组信号每 N 个 TDM 周期更新一次;物理 SerDes/Aurora 链路速率远高于原型系统时钟,N 个时隙在一个(或几个)原型时钟周期内传完,于是对被验证设计而言,跨片信号表现为“延迟了若干拍的同名信号”——工具自动在两侧插入保持寄存器和握手宏,使逻辑功能正确,但这条原本 1 拍可达的路径现在延迟 D 拍(D 随复用率、管线级数、跨片跳数变化,几十到上百拍很常见)。如果一个设计跨片往返多次(A→B→A 形成环路),延迟会叠加,这往往是原型频率的最终决定因素:系统时钟周期必须大于最长跨片往返路径。工程上要优化的不只是平均延迟,而是环路割集:尽量让模块间的依赖图是有向无环或弱环结构,避免控制信号频繁跨片往返(把控制状态机和它管理的数据通路放同片)。
协议语义的保留由工具插入的同步宏处理:单 bit 电平信号、脉冲信号、多 bit 总线需要不同封装(脉冲要保证不丢、跨时钟域要带同步器),握手协议(valid/ready、request/ack)跨片时延迟插入不能破坏死锁自由——ready 反向通道也跨片时,环路延迟可能改变 FIFO 所需深度,工具会自动加深但代价是资源。并行 GPIO 通道仍有价值:板上相邻 FPGA 间的几百到几千根低延迟线用于最关键的信号(复位、中断、低延迟总线、时钟握手),与 SerDes TDM 形成混合互联。多跳路径(信号经过 FPGA0→1→2)要尽量避免,每跳都加延迟和抖动,分区时用“距离感知”权重。设计团队能做的最有效优化在 RTL 阶段:减少跨模块的隐式全局状态、避免跨大层次的组合逻辑、把复位/使能等扇出极高的信号本地化——这些“可原型性”规则和良好 RTL 设计风格高度一致,也与仿真加速(emulation)的编码要求相通。
七、时钟、复位与降频:让慢时钟依然验证正确
原型时钟体系与真实芯片完全不同,设计不当会让“功能正确”的 RTL 在原型上跑出假故障。全局时钟分发:平台提供一个或几个低抖动参考时钟树到所有 FPGA,原型系统时钟(可能只有几 MHz 到几十 MHz)由这个基经 PLL/MMCM 在各片本地生成,必须保证所有片同频且相位关系已知;跨片 TDM 物理链路用独立的高速时钟(几百 MHz),与原型时钟之间由插入宏做 CDC。门控与派生时钟是重灾区:真实 RTL 里大量功能时钟门控、分频时钟在降频原型中可能不工作或频率低到无意义,原型流程通常把时钟门控转换成使能、把内部派生时钟映射到平台时钟资源;如果 RTL 从一开始遵循“单时钟+时钟使能”风格,移植成本会大幅降低。异步时钟域在原型中数量会膨胀:物理链路时钟、TDM 宏时钟、各 FPGA 本地时钟之间全是异步关系,工具会插入同步器,但真实的 CDC 设计(FIFO、格雷码指针)仍然需要在目标频率关系下验证——要意识到原型改变了时钟频率比,某些依赖具体频率比的行为(如超时计数器)可能需要参数化。
降频后什么仍被验证、什么不能:功能逻辑、协议状态机、CPU 取指执行、软件栈、DMA/中断、死锁/活锁都照常被验证,且能跑比仿真多几个数量级的周期;但依赖真实时间的电路(UART 波特率、以太网 MII、定时器、SerDes 速率)不能直接用降频时钟驱动——标准做法是这些外设 IP 用独立的真实速率时钟域(平台提供或片上 MMCM 生成真实频率),与慢速原型逻辑通过异步 FIFO 对接,于是软件看到的 UART 仍是 115200、真实 PHY 仍跑满速,而核心 SoC 慢很多。软件也要适配:依赖 cycle 计数的延时循环要改成读真实时间计数器,超时阈值按原型速率缩放。复位体系必须全片有序:平台管理控制器统一分发复位,先释放物理链路和 TDM 宏(链路训练完成)、再释放分区逻辑,避免跨片寄存器在链路未就绪时采到 X;多 FPGA 复位树和启动顺序是 bring-up 的高风险点(系统化上电方法见 03 原型平台 bring-up 多片点亮/trace)。
八、存储映射与容量墙:SRAM、DDR 与内存语义
ASIC/SoC 里的存储层次(寄存器堆、各类 SRAM、缓存、片上 RAM)映射到 FPGA 时各有不同代价,是分区之外的第二堵容量墙。分布式小 SRAM/寄存器堆通常直接映射到 LUTRAM/FF,面积膨胀明显,且常常成为 LUT 资源瓶颈,大量微小存储实例应在综合时合并(memory compaction)。中大 SRAM 映射到 BRAM/URAM,注意端口语义差异:ASIC SRAM 常见的双端口、混合位宽、使能时序与 FPGA 硬核不完全一致,原型库通常提供行为级替换模型,但时序(latency)变化可能暴露 RTL 对存储延迟的隐式假设——任何依赖“SRAM 同一周期出数”的逻辑在替换为一周期延迟的 BRAM 后会出错,可综合性 RTL 应把存储延迟参数化。缓存一致性结构是难点:大 L2/LLC 常常装不下或分区切割破坏一致性目录,原型验证时常见折中是缩小缓存容量(保持关联性和协议不变)、用外挂 DDR 模拟末级缓存(牺牲延迟)、或在早期用非缓存配置先验证功能。
外挂 DDR 作为大容量存储后端:当片上 BRAM 装不下(如片上大 SRAM、帧缓冲、trace 缓冲),用 FPGA 板载 DDR 替换,但带宽和延迟特性完全不同——ASIC 内部单周期 SRAM 变成几十纳秒的 DDR 访问,依赖近内存延迟的逻辑不能接受,只能用于真正的大容量场景;DDR 控制器和控制宏本身吃资源且通常必须整模块放在某一片内,影响分区。地址映射与软件可见性:替换后的存储地址映射要与真实地址图一致(或经软件抽象层转换),软件才能不加修改地启动 OS;内存属性(cacheable/device)必须保留。存储内容初始化与加载:ROM/启动代码镜像要能从主机快速加载(经 JTAG/PCIe/以太网写存储),大镜像加载时间本身影响迭代效率,商用平台提供存储 backdoor 下载。规划容量时的经验:把全部 ASIC 存储按类型折算成 BRAM/URAM 个数和 DDR MB 数,单独列一张存储容量表,与逻辑容量表并行管理;存储往往比逻辑更早触顶。
九、可观测性与可调试性:在 8 片 FPGA 内部看见信号
单片 FPGA 上抓波形很简单,多 FPGA 原型中 99% 的内部信号都不可达,调试能力必须在平台设计阶段内建,这是商业原型平台相对自研背板最值钱的部分。分层观测:第一类是全局状态——各 FPGA 的时钟/复位/链路 up、TDM 错误、收发器误码计数,由平台管理控制器集中采集(思路见 专家 45);第二类是深度 trace——选择一批内部信号经自动探针(工具把观测点路由到预留的 trace 缓冲,通常在 BRAM 里做环形采样)或引出到逻辑分析仪通道,触发条件可配置,trace 深度与观测信号数是资源权衡;第三类是软件视角——处理器经总线能读写的任意内存映射寄存器/存储,始终是信息量最大的观测源,软件断言和 trace 事件写入共享内存再上传主机。自动探针路由是专业工具的核心能力:重新选一批观测信号不需要改变分区,工具在预留的调试网络上重新布线即可,成本是固定比例的 LUT/布线开销(约 5%~10%)。
触发与时间相关:跨片触发需要全局触发网络(管理控制器或专用 trace 链路分发触发),保证多片 trace 缓冲在同一(已知相对偏移的)时刻停止;各片本地时间戳计数器在复位时同步,用于事后对齐事件。JTAG 与下载拓扑:多片 JTAG 串成链或经 JTAG-over-link 隧道(专家 05 第九节的方法),支持逐片配置、单步和边界扫描;8~16 片的全链 JTAG 配置时间不可忽略,通常用并行配置或高速 SelectMAP。验证工作流建议:从软件可观测层(断言、事件日志)先定位到模块,再动用硬件 trace;在设计中内建断言和性能计数器(这些 RTL 在 ASIC 里也有长期价值);trace 信号清单随版本管理。一个常被忽视的点:调试逻辑本身改变时序和资源,调试版本与性能版本的分区结果可能不同,平台容量预算里必须永久保留调试开销,不能用满载比特流“临时挤一挤”。
十、平台选型与容量规划:一次把账算够
多 FPGA 原型是昂贵且长生命周期的投资(平台、工具授权、机柜、配套软件),选型阶段的容量错算会让项目持续两年缺氧。容量账的正确算法:先把 RTL 总量按器件资源类型(LUT/FF/DSP/BRAM/URAM)统计并打三类折扣——分区与 TDM 开销(20%~40%)、调试观测预留(10%~20%)、迭代增长预留(15%~25%,SoC 项目一年中增长 20%~30% 很正常);目标利用率控制在 55%~70%,高利用率直接导致布局布线时间爆炸(单次构建十几小时)、时序不收敛和分区无解。带宽账先于门数:列出模块间预估通信矩阵,折算为所需 SerDes lane 数和 GPIO 数,与候选平台背板拓扑对照;很多项目逻辑装得下但割集落不了板。存储账:第八节的存储折算表决定需要多少 BRAM 密集型 FPGA 和 DDR 通道。软件与接口账:要跑多完整的软件栈(决定要不要连真实 PCIe/以太网/存储控制器,这些硬核在哪些片可用)、多少并发用户(决定是否需要多平台)、调试下载速度(迭代周期=构建时间+配置时间+软件加载时间)。
商用平台 vs 自研:商用平台(多片 UltraScale/Versal + 背板 + 电源/时钟 + 分区调试软件)带来开箱即用的容量、TDM IP、自动探针和多用户调度,适合时间敏感的主流 SoC 项目;自研背板在接口特殊(要接特定物理外设)、有长期平台团队、或多项目摊薄成本时才划算,且要正视自研软件栈(分区宏、调试网络、管理控制器)的巨大工程量。生命周期决策:原型平台应按项目峰值容量(而非当前规模)选型,因为中途换平台等于重做分区和板级环境;同时评估 FPGA 与 ASIC 工艺代际的速率差距,规划哪些验证必须转仿真加速(emulator,容量更大、时钟更慢、观测更全)或 FPGA 原型(更快、可接真实接口),两者互补——功能回归在 emulator,软件性能/真实接口联调在 FPGA 原型(流程见 04 ASIC 原型验证全链路 RTL ID/GateID/层次映射)。最后建立容量看板:每周跟踪资源、割集、利用率、构建时间、可达频率五条曲线,容量恶化在趋势上可见,项目就不会在流片前三个月才发现原型“装不下新版本”。
十一、bring-up 策略:从一片灯亮到全系统跑软件
多 FPGA 平台的上电集成遵循与高速链路相同的“从内向外点亮”原则,规模放大后更需要严格编排(通用方法见 03 原型平台 bring-up 多片点亮/trace、专家 43)。第一阶段是平台就绪:电源、时钟、配置链路、管理控制器独立验证,各 FPGA 能被逐片配置并读回身份/DNA,跨片链路按 Aurora/SerDes bring-up 流程(参考钟、回环、眼图)逐条点亮,TDM 环回用固定 pattern 验证。第二阶段是骨架设计:先用最小 DUT(空分区+跨片回环+管理接口)跑通“分区→构建→多片配置→链路 up”的全流程,再逐步引入真实模块,每一步都保持系统可运行。第三阶段按分区逐块集成:先单片子系统(处理器核+本地存储)能执行简单程序,再加入跨片模块,每引入一组跨片连接就验证 TDM 宏和握手。第四阶段才是完整 OS/软件栈。每阶段都有明确的通过判据和回退点,切忌全量比特流一次上电。
典型故障的分层归因:配置失败查电源/配置链/JTAG 链;单片中的功能失败查模块;跨片信号随机错查 TDM 链路误码和时钟关系;只有高负载才出错查 FIFO 深度和原型频率余量;软件跑飞但简单测试正常查存储模型(RAM 延迟替换)和真实时间外设。管理控制器应能逐片复位、读链路误码计数、注入时钟降档,并提供统一的上电/掉电编排。平台级自检(所有链路 PRBS、存储 march 测试)应做成一键脚本,每次分区版本更新后先跑自检再交验证团队——这套“平台 BIST”能避免把环境故障误判成 DUT bug,在多人共享平台时尤其关键。
十二、验证计划:原型在整体验证中的定位
成熟的 ASIC/SoC 项目把仿真、仿真加速(emulation)、FPGA 原型和真实接口环境组成一个分层验证体系,原型团队必须清楚自己负责回答哪些问题。原型强项:周期规模大(可跑 bootloader/OS/完整驱动和应用、数小时 soak)、真实软件在真实并行硬件上执行、真实 PHY 和接口设备(示波器外的流量、真实 SSD/网卡)、软硬件协同与性能量级评估、上电/复位/电源管理等长序列。不适合在原型上回答的问题:时序签核(STA 和门级仿真负责)、精确功耗(原型映射改变了负载,只能粗略估计)、极小概率的跨时钟域亚稳态(CDC 审查+形式验证负责)、精确性能数字(降频和 TDM 改变了相对延迟)、模拟/RF 行为。明确边界能避免“原型测过了所以芯片没问题”或“原型频率低所以没价值”两类错误结论。
验证产出应工程化:自动化的每日/每周构建(分区变化时重新出全套比特流,CI 思路见 专家 46);冒烟测试集(启动 OS、跑内存测试、接口环回)在每个构建上自动执行;回归测试集按功能模块组织,失败直接关联 RTL 版本和分区版本;性能相关测试给出“原型周期数”而非墙钟时间,以便换算。与软件团队的接口要提前定义:下载镜像方式、控制台(经真实 UART 或虚拟 console)、共享文件系统(经 PCIe/以太网 host 通道)、调试符号与回溯地址映射(原型地址经 TDM 重映射,trace 要能翻译回 RTL 层次名)。把原型当“共享验证基础设施”运营(容量排期、多用户队列、维护窗口),它才能支撑整个项目而不是只服务 bring-up 期。
十三、成本模型与项目组织:什么时候值得上多 FPGA
最后从项目经济学角度给决策框架。多 FPGA 原型的真实成本包括:平台采购/租赁(单平台七位数人民币级并不罕见)、商业分区与调试软件授权(常按年计费且价格可观)、机柜/电源/散热、2~5 人的专职平台团队(分区、bring-up、TDM、工具链)、每次 RTL 变更的构建算力与等待时间(大规模分区构建一轮数小时到一天)。收益是:软件提前 6~18 个月在硬件上开发、验证周期吞吐比仿真高 4~6 个数量级、流片前发现系统级 bug(一个流片后 bug 的代价远超整个原型项目)。决策门槛通常是:SoC 门数确实超过最大单片 FPGA 的有效容量(打七折后仍超)、软件复杂度高(OS、协议栈、大量驱动)、有多个硅前里程碑需要演示或认证、组织有能力或预算获得平台与工具链。中小规模 ASIC 优先考虑单片大容量 FPGA(容量足够时简单一个数量级),早期架构探索用仿真加速,接口密集型子系统可用专门的接口原型板,最后才是全尺寸多 FPGA 平台。
组织上建议设三个明确角色:平台/基础设施负责人(背板、工具链、构建系统、bring-up)、分区工程师(理解 RTL 也理解工具,负责割集迭代和频率)、验证对接人(测试自动化、软件接口、回归)。RTL 设计团队则承担“可原型性”责任:单时钟风格、参数化时序、层次边界清晰、不依赖门级延迟(相关编码规范与 HLS/RTL 质量要求相通,见 专家 20)。项目计划上,平台 bring-up 与 RTL 开发并行启动,在 RTL 冻结前数月平台就应可用;不要把平台采购当作 RTL 完成后的采购动作。一句话收尾:多 FPGA 原型不是“更大的开发板”,而是一套包含物理平台、分区软件、验证方法学和专职团队的系统工程;以系统工程的方式投资它,它就是大芯片项目性价比最高的硅前保险;反之,把多 FPGA 平台当作“插上就能用的大板子”,项目往往在流片前半年陷入分区无解、构建以天计、bring-up 无人负责的被动局面。分区、互联、降频、调试、容量五件事,缺一不可,这就是多 FPGA 原型工程的全部要点。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 门数÷单片容量估片数 | 余量不足跑不动 | 留 30~50%,利用率<70% |
| 忽略引脚/收发器瓶颈 | 分区无法落地 | 按片间带宽先行核算 |
| 关键路径切跨片 | 降频到无法接受 | 关键路径约束同片 |
| 期待原型验时序 | 定位错误 | 功能验证,时序靠 STA |
| 全片高利用率 | 迭代极慢/不收敛 | 留调试/迭代空间 |
| 跨片信号不做同步化 | 亚稳态/不稳定 | 工具插 TDM/握手宏 |
相关与延伸
互联:Aurora 协议、收发器。 流程:03 原型平台 bring-up 多片点亮/trace、04 ASIC 原型验证全链路 RTL ID/GateID/层次映射、34 FPGA 与仿真器互联 事务级桥接/SCE-MI。
总结
多 FPGA 原型解决'ASIC 大到单片装不下':用专用工具把网表分区到多片 FPGA——分区三大目标是片间连线最少(跨片引脚/收发器是比逻辑门更稀缺的瓶颈)、资源均衡、关键路径留在同片;切开的信号走片间链路,并行 GPIO 延迟低但线少、大量信号经 SerDes/Aurora 时分复用(TDM,几百条信号轮转进一条串行帧,代价是跨片延迟从 1 拍变几十上百拍),系统因此降频到几 MHz。但验证价值巨大:真实 RTL 并行跑、比仿真快 10^4~10^6 倍、能启动完整 OS 和软件栈做长时 soak,验证功能与软硬件协同(时序由 ASIC STA 负责,原型不做时序签核)。容量规划纪律:利用率压在 60~70% 以下(分区开销 20~40%+调试迭代 20~30%),引脚/收发器带宽比门数更早成为限制,平台选型一次留足余量。