ATPG 向量压缩:静态与动态 compaction、test point 与压缩架构参数选择实战
更新时间:2026-10-04。ATPG(Automatic Test Pattern Generation,自动测试向量生成)的干活在 DFT 扫描 ATPG 与 Tessent 里讲过流程,在 数据流格式之测试向量 里讲过交付物长什么样。这一篇专门回答一个成本问题:向量太多了怎么办。一颗中等规模的 SoC,stuck-at 加 transition 加 path delay 全套打下来,原始向量动辄几万条,ATE(Automatic Test Equipment,自动测试机台)上跑一遍要几十秒,按机台每秒几毛钱到几块钱算,量产几百万颗就是一笔真金白银。ATPG 向量压缩就是把这笔账算回来的全套手段:生成侧少产、结构侧少移、覆盖侧不亏。物理侧的链长与布局配合见 扫描压缩的布局感知,本篇只聚焦「数量」这一个轴。
本文要回答的问题
- 向量数量到底是谁决定的,为什么同覆盖率目标下不同设计能差出 3-5 倍?
- 静态 compaction 和动态 compaction 各在什么环节生效,效果差多少,能不能只用一种?
- test point 插入为什么能降向量数,它和控制点、观察点的代价怎么权衡?
- 扫描压缩架构(EDT 类)的 channel 数、chain 数、压缩比三个参数怎么选,换挡时覆盖率会不会掉?
- fault grading(故障分级)和向量压缩是什么分工,为什么说它们一个管「质量账」一个管「成本账」?
一、向量数量从哪里来:成本公式拆解
先建立成本模型。ATE 上的测试时间大致等于「向量条数 × 每条向量的移位周期数 × 移位周期」,移位周期数又约等于最长扫描链的长度。所以降测试时间只有三个抓手:少几条向量、少移几个周期、把时钟打快(受限于功耗和时序,空间不大)。ATPG 向量压缩管的是前两个抓手,而且它们往往是连动的:加了压缩架构后,单条向量的移位长度大降,但同样的故障可能需要更多条向量来打,净收益要靠参数调出来。
向量数量本身的驱动因子有四个:设计规模(触发器与逻辑门数)、故障模型(stuck-at 一遍、transition 又一遍、path delay 通常另起一套)、故障的可测性分布(随机逻辑好打,控制逻辑、时钟逻辑、加密逻辑难打)、以及 ATPG 引擎的「贪心程度」——每条向量顺手多检测几个故障的能力。前三个是设计给的,第四个是工具和手段能撬动的,这正是 compaction 的舞台。
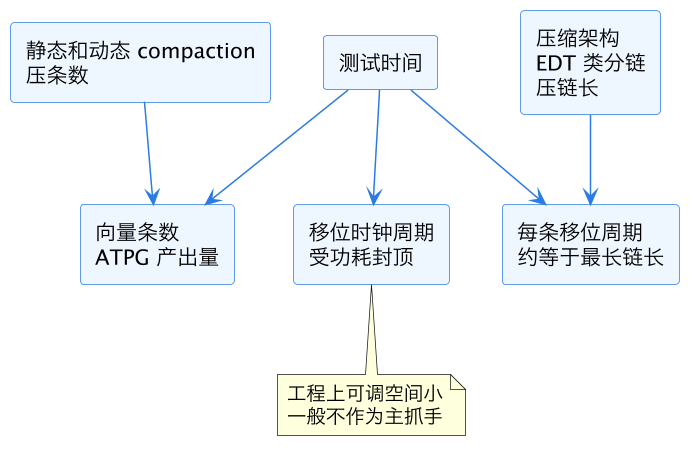
这张图是全篇的账本:测试时间拆成三个因子,compaction 砍「条数」、压缩架构砍「每条的长度」。注意一个容易混淆的点——「ATPG 向量压缩」在业界有两种含义:一种是 pattern compaction(合并向量、减少条数),一种是 test compression(扫描结构上的压缩、缩短移位长度)。本篇两种都覆盖,但读图时记住它们作用在公式不同的因子上,收益是相乘不是相加。
二、静态 compaction:事后合并的免费午餐
静态 compaction(static compaction)发生在向量生成完之后:手里已经有一把向量,每条都带一堆无关位(don't care bit,即 ATPG 没指定、填 0 填 1 都不影响已检测故障的位),把「不冲突」的向量两两或多路合并成一条。典型工业向量集的无关位比例高达 95% 以上,理论合并空间巨大。
合并的约束是「指定位不打架」:向量 A 在某个触发器位置指定了 0,向量 B 在同一位置指定了 1,这两条就不能合。工具的做法是把向量按指定位的冲突关系构图,贪心地找可合并组。效果上,纯静态 compaction 对 stuck-at 向量集通常能砍掉 30%-60% 的条数,而且它是「免费」的——不改电路、不改覆盖率、不改流程,纯后处理。
但静态 compaction 有两个天花板。其一,它只能在已生成的向量之间合并,如果原始生成时就「一向量一故障」地贪心打,向量各自被填得很满(指定位多),合并空间就小;其二,它是 NP 难的组合问题,大向量集上工具只能给次优解,跑一晚上和跑十分钟的合并率可能差 10 个百分点,要不要付这个机器时间是个工程决策。
三、动态 compaction:生成时就塞满
动态 compaction(dynamic compaction)把合并思想前置到生成过程里:ATPG 选定一个主目标故障生成向量时,不急着收尾,而是趁这条向量还有大量无关位,连续追加第二、第三个次要目标故障,把它们的指定要求也「塞」进同一条向量,直到塞不下为止。这样产出的每条向量天生就是「满载」的。
和静态版对比,动态 compaction 的优势在于它掌握「生成自由度」:静态版面对的是两条各自已经固化的向量,冲突就没办法;动态版在次要目标还没固化时就去协调,能主动避开冲突位。代价是 ATPG 运行时间明显变长——每塞一个次要目标都要重做一次蕴含(implication)和冲突检查,典型开销是基本 ATPG 的 2-5 倍。另一个代价是向量调试体验变差:一条向量对应一长串故障,silicon debug 时定位不如「一向量一故障」干净。
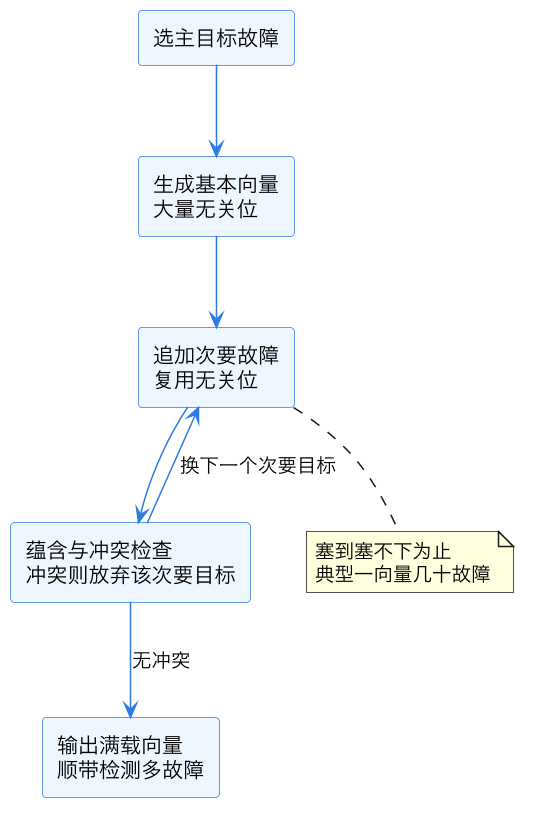
这张图是动态 compaction 的内循环。循环的关键在冲突检查那一步:次要目标不是硬塞,而是「能塞就塞、塞不进就换」,所以最终向量集条数取决于次要目标的挑选顺序——这也是为什么不同工具、不同 seed 跑出来的条数能差 20%。工程建议:动态 compaction 作为主手段常驻开启,静态 compaction 作为收尾再过一遍,两者叠加通常比单用静态再多砍 20%-40%。
| 维度 | 静态 compaction | 动态 compaction |
|---|---|---|
| 生效环节 | 向量生成后,纯后处理 | 向量生成中,与 ATPG 耦合 |
| 单次降条数幅度 | 30%-60%(视无关位密度) | 相比无压缩可到 3-10 倍 |
| 运行开销 | 低,分钟到小时级 | ATPG 时间 2-5 倍 |
| 覆盖率风险 | 无(合并不丢故障) | 无(次要目标检测有保证) |
| debug 友好度 | 中等 | 差,一条向量挂一串故障 |
| 典型用法 | 收尾再压一遍 | 常驻开启的主手段 |
四、test point:从源头降低生成难度
有一类向量膨胀不是合并能解决的:设计里存在「难测逻辑」——深埋的控制信号(比如要 16 个触发器同时满足特定值才能点亮的与门)、不可控的时钟门控、黑盒 IP 外围逻辑。ATPG 为打一个这种故障可能生成几十条向量还打不动,最后标成 aborted,拉低覆盖率还浪费运行时间。
test point(测试点)的思路是改电路:在难控制的节点前插一个控制点(control point,测试模式下由扫描触发器直接驱动该节点),在难观察的节点后插一个观察点(observe point,把该节点值扫出来)。电路的可控性、可观察性上来之后,原本打不动的故障变成普通故障,ATPG 每向量能打更多故障,总条数自然下降。实测在控制逻辑密集的设计上,合理布点能把向量数砍掉 30%-50%,同时把覆盖率从 92% 抬到 97% 以上——这是少数「既降成本又抬质量」的手段。
代价当然也是实的:额外的面积(每个 test point 一个触发器加选择器,通常控制在总触发器数的 1%-5%)、时序路径上多一级 mux 延迟(插在关键路径上要谨慎,常配合 时钟门控检查 的时序口径评估)、以及物理实现阶段要把这些点和扫描链一起布线(见 DFT 物理实现)。布点策略上,工具一般基于可测性分析(SCOAP 类的可控性/可观察性度量)自动选点,工程师要审的是别插到关键时序路径和低功耗域的隔离逻辑上。
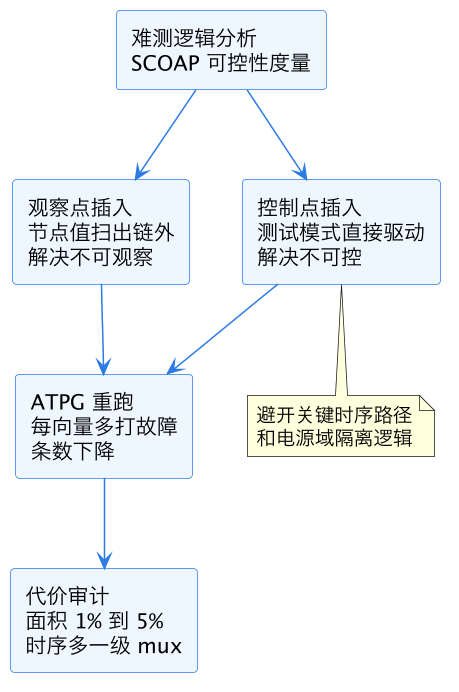
这张图是 test point 的因果链。读图要点:控制点和观察点是两种独立手段,不是必须成对出现——纯观察性问题(节点值传不到任何扫描触发器)只插观察点就行,纯控制性问题只插控制点。布点后的收益要在 ATPG 重跑后用「同覆盖率目标下的条数对比」来验证,没降够就调布点密度重来,而不是直接加量。
五、压缩架构参数:channel、chain 与压缩比的换挡
compaction 压的是「条数」,扫描压缩架构(以 Mentor EDT、Synopsys DFTMAX 为代表的 embedded compression)压的是「每条的长度」:片外只留少量扫描通道(channel),片内用一个解压器(decompressor,通常是线性反馈移位寄存器加相位偏移器)把少量通道数据展开喂给几十上百条短内部链,输出侧用压缩器(compactor,常见 XOR 树)把响应压回少量通道。压缩比(内部链数 / 外部 channel 数)常见配置在 30:1 到 200:1。
三个参数的选择逻辑是互相牵制的。channel 数受 ATE 引脚预算和测试接口(比如 1500 标准的 wrapper)限制,给定 channel 后,压缩比越高,单条向量移位周期越少(链短了),但解压器的编码能力越紧张——每条内部链位置的指定位都要能被外部 channel 的线性组合表达出来,一个 channel 喂 100 条链时,一条向量里指定位一多就「编不出来」,ATPG 只能放弃这条向量重新生成,表现为向量条数回升。所以压缩比和条数之间存在一条 U 形曲线:压得太浅,链长收益不够;压得太狠,编码失败把条数抬回去。工程甜点位通常靠试:从 50:1 起步,ATPG 跑一轮看条数和 coverage,条数暴涨就把压缩比降一档。
给一个具体的换挡例子帮助建立量级感。一颗 200 万触发器的区块,ATE 只分给它 8 对扫描 channel。不加压缩时单链最长约 5 万个触发器,一条 transition 向量移位就要 5 万拍;配 100:1 压缩后内部链 800 条、每条 2500 个触发器,单条向量移位降到 2500 拍,整整 20 倍。但跑下来发现 stuck-at 条数从 8000 涨到 15000——压缩比在 100:1 处已经进入 U 形曲线右侧,编码失败逼着 ATPG 多产向量。把压缩比降到 64:1(内部链 512 条、每条约 3900 触发器),条数回落到 9000,总移位拍数从 1.5 万乘 2500 降到 9 千乘 3900,净省约 6%,覆盖率纹丝不动。这个例子也解释了为什么换挡要看「总移位拍数」而不是只看条数或只看链长——两个因子是相乘的,单边最优不等于全局最优。
另一个参数是移位周期数的均衡:内部链要等长,不等长时按最长的算,短的链浪费周期。这和 扫描链重排与时序 里的物理链均衡是同一个问题的两面——物理侧管链怎么绕,压缩侧管链怎么分。
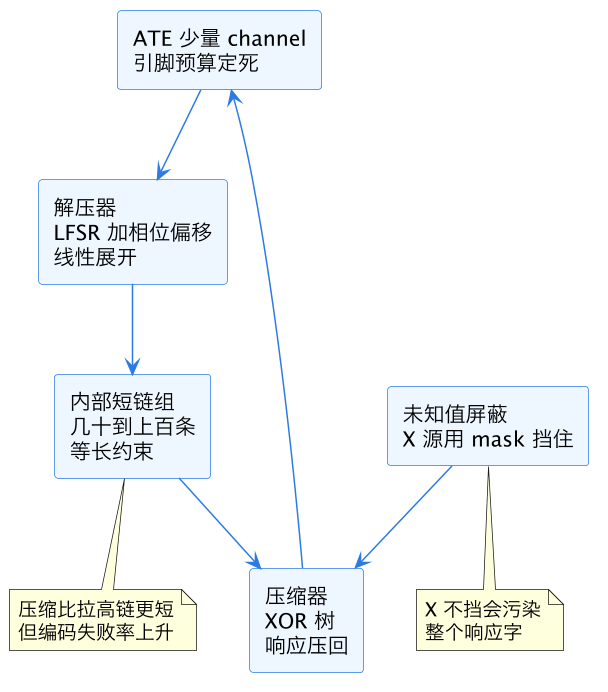
这张图是压缩架构的数据通路。正文里没展开但必须知道的一环是 X 处理:内部链里任何未初始化存储单元、多驱动总线都会产出 X(未知值),XOR 树对 X 是「一脏俱脏」,一个 X 会污染和它共享输出 channel 的所有响应位,所以压缩器前要配 mask 逻辑,而 mask 本身又消耗 channel 带宽——这是高压缩比下另一个隐性成本,选压缩比时要把 X 密度算进去。
六、fault grading 的分工:质量账与成本账各算各的
最后理清一个常见混淆:fault grading(故障分级/故障模拟)和向量压缩是两条线。fault grading 干的是「给定一把向量,逐故障模拟,算出覆盖率、标出未检故障清单」——它是质量侧的审计工具,回答「这把向量够不够好」;向量压缩干的是「在覆盖率目标不动的前提下,把向量的成本降下去」,回答「这份够好能不能便宜点」。典型流程是:ATPG 生成 → compaction 压缩 → fault grading 复核覆盖率没掉 → 交付。
但两者有一个交叉点要用好:grading 报告里的未检故障分类(undetected 里的 AU 不可检、ATPG aborted 打不动、ND 没尝试)直接指导压缩策略。aborted 占比高,说明电路难测,该上 test point;ND 多说明运行时间预算没给够;AU 多(比如被约束死的逻辑)说明该回头清理 testability 约束而不是硬压向量。把 grading 报告当压缩的输入读,而不是当交付的尾巴看,是成熟团队和新手团队的分水岭。
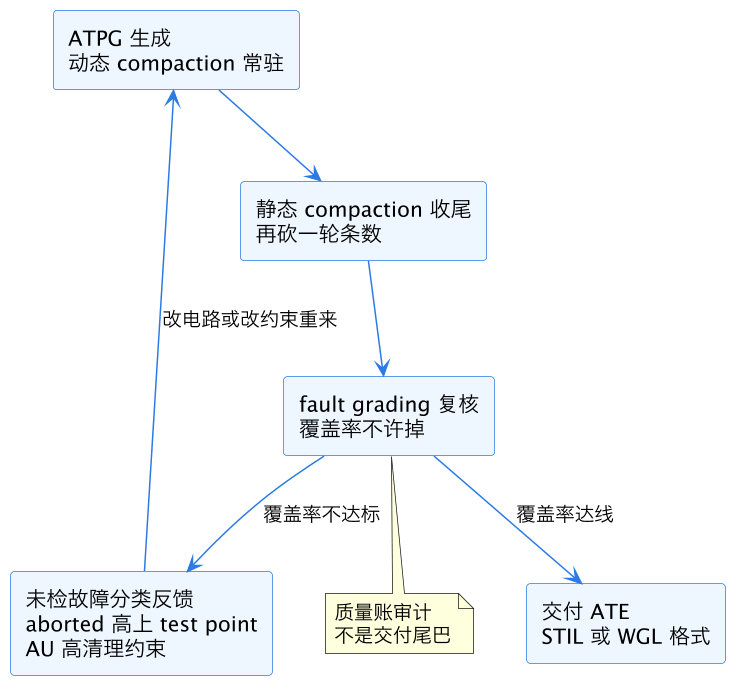
这张图是完整闭环:压缩在前、grading 复核在后、不达标走反馈回路改电路或改约束。交付格式侧的注意事项见 数据流格式之测试向量,那里讲了 STIL 文件里压缩向量怎么带 protocol 信息,和本篇是上下游关系。
这一篇在知识体系里的位置
本篇是 eda/ 目录 DFT 线的成本侧专文。流程上游接 DFT 扫描 ATPG 与 Tessent(向量怎么生成),物理配合侧接 扫描压缩的布局感知(压缩逻辑怎么摆)、DFT 物理实现(test point 和压缩逻辑怎么落版图)与 扫描链重排与时序(链长均衡的物理面),交付侧接 数据流格式之测试向量(压缩后的向量怎么写成 STIL 交给 ATE),存储自测的平行线见 MBIST 物理插入流程(存储器不走扫描压缩这条路)。把这几篇连起来,一颗芯片从「打多少向量」到「向量怎么上机台」的整条成本链就齐了。
总结
ATPG 向量压缩是一套围绕「测试时间 = 条数 × 链长 × 周期」的成本工程:动态 compaction 在生成时把每条向量塞满多故障(主手段,ATPG 时间换条数)、静态 compaction 事后合并不冲突向量(收尾免费午餐,再砍 30%-60%)、test point 用 1%-5% 面积换可测性从源头降压(aborted 故障多时上)、压缩架构用解压器加分链把链长压掉一两个数量级(channel 数按 ATE 预算定,压缩比沿 U 形曲线找条数不回升的甜点,X 屏蔽成本要计入);而 fault grading 管的是另一条质量账——复核覆盖率不掉、把未检故障分类反馈回压缩策略,两条线一前一后把「够好」和「够便宜」同时钉死。