寄存器读写属性验证:RO/W1C/W0C/ROE 逐位验证序列
更新时间:2026-09-29。UVM 寄存器模型集成:RAL 与前门后门访问 讲了寄存器模型怎么接进环境、镜像值怎么同步;这一篇下沉一步,只盯一件事:模型里每个字段声明的访问属性(RO、W1C、W0C……)和 RTL 的真实行为到底一不一致。复位默认值的检查在 复位与初始化验证:释放时序与寄存器默认值,本篇管的是「复位之后,每个字段能不能按规格书说的方式被读写」。
本文要回答的问题
- RO、RW、W1C、W0C、ROE 这些属性各是什么语义,最容易混淆的是哪几对?
- 为什么「写一遍读回来」的普通寄存器测试验不出属性类 bug?
- 每种属性的最小验证序列是什么,能不能机械化逐位生成?
- UVM 寄存器模型里属性写错了会怎样,验证怎么抓出来?
一、属性不是修饰词,是行为契约
寄存器规格书里每个字段后面跟着的小标签——RO、RW、W1C——不是文档装饰,而是软件和硬件之间的行为契约:驱动工程师照着它写代码,验证工程师照着它写检查。属性错了,轻则中断状态清不掉,重则驱动误清别人的状态位导致系统级灵异问题。
先把五种最常见的属性语义钉死:
| 属性 | 全称 | 读行为 | 写行为 | 典型场景 |
|---|---|---|---|---|
| RW | Read-Write | 读回当前值 | 写什么是什么 | 配置寄存器:使能位、模式位 |
| RO | Read-Only | 读回硬件更新值 | 写入被忽略,值不变 | 状态寄存器:IP 版本号、忙标志 |
| W1C | Write-1-to-Clear | 读回当前值 | 写 1 的位清 0,写 0 的位不变 | 中断状态、错误标志 |
| W0C | Write-0-to-Clear | 读回当前值 | 写 0 的位清 0,写 1 的位不变 | 少数厂商的清零约定(易踩坑) |
| ROE | Read-on-Read / 读清零变体 | 读动作本身改变值 | 视具体定义 | FIFO 数据弹出、读清零状态 |
W1C 和 W0C 是最容易搞反的一对。W1C 是绝对主流(ARM 全家、绝大多数中断控制器都用它),但总有 IP 用 W0C 或者混合定义——同一个寄存器一半位 W1C、一半位 RW 毫不稀奇。规格书抄错一个字母,验证序列就整体跑偏。还有一对隐性陷阱:RO 字段如果被 RTL 误实现成 RW,普通的「写 0x5A 读回」测试会通过——因为写入确实生效了——只有「写了不该生效」的负向检查才能抓到它。
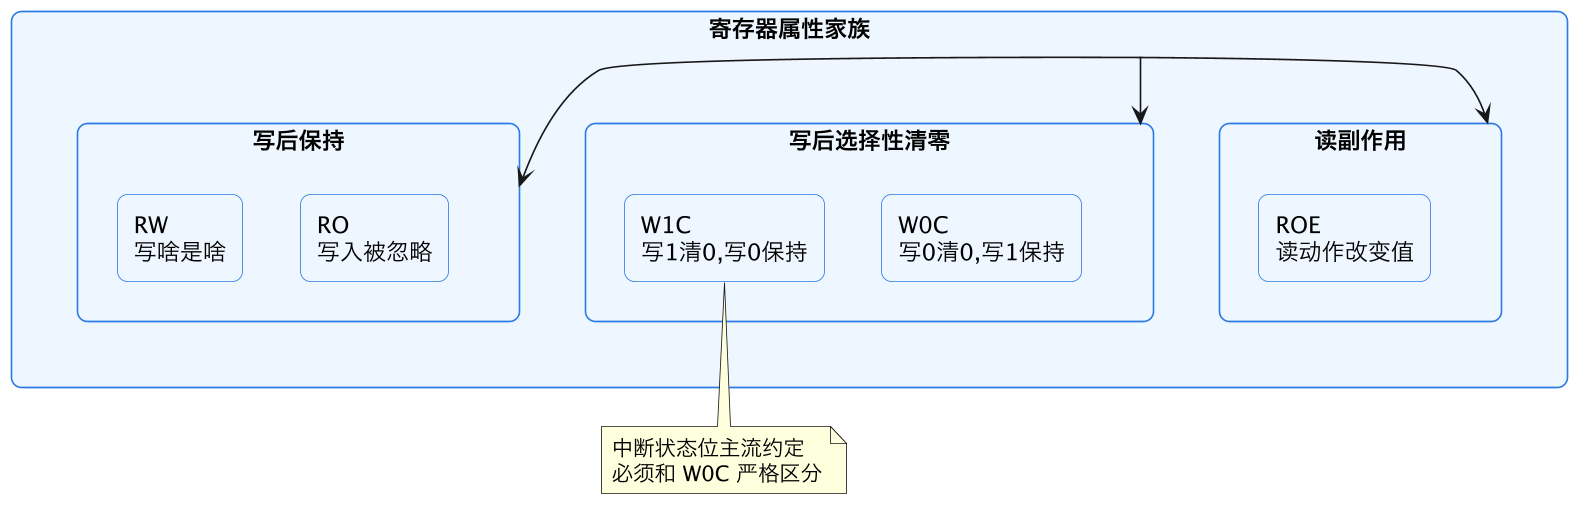
这张分类图把属性按「写行为」分成三支:写后保持(RW/RO)、写后选择性清零(W1C/W0C)、读副作用(ROE)。验证序列的设计也顺着这三支走——每支的核心矛盾不同:第一支要验「写权限的边界」,第二支要验「清零的选择性」,第三支要验「读动作本身的副作用」。把属性归对支,序列模板就有了。
二、为什么普通读写测试验不出属性 bug
最常见的偷懒写法:对每个寄存器 write(0xFFFF_FFFF) → read → 比对。这个序列对 RW 字段够用,对其他属性几乎是摆设:
- 对 RO 字段:写全 1 后读回,如果 RTL 正确忽略写入,读回的是原值;测试如果拿「写入值」当期望就误报,拿「读回值」当期望就什么都没验——写入到底被忽略了没有,要和「写之前的值」比。
- 对 W1C 字段:写全 1 会把所有位置零,读回 0。很多测试看到读回 0 就当「写成功」通过了——实际上它验的是清零,而且还没验「写 0 保持」那一半语义。更糟的是,如果测试顺序没控制好,这次写全 1 把别的中断源的状态位也顺手清了,后面依赖该状态位的检查莫名失败,排查半天才发现是寄存器测试闯的祸。
- 对 W0C 字段:写全 1 按定义应该全部保持不变,读回原值;用 W1C 的期望去判就是全红,用「读回等于写入值」去判也是全红——方向反了。
结论很直接:属性验证的期望不是常量,而是「当前值、写入值、属性语义」三者的函数。每种属性需要一组最小序列,正向负向都要覆盖。
三、逐属性的最小验证序列
设字段复位值为 R,测试写入两个走码图样 A = 0xAAAA_AAAA、B = 0x5555_5555(互为反码,保证每一位都经历 0→1 和 1→0 两个方向)。下表给出五种属性的最小序列与每步期望:
| 属性 | 步骤序列 | 关键期望 |
|---|---|---|
| RW | 写 A → 读 → 写 B → 读 | 两次读回分别等于 A、B(只验该字段掩码内的位) |
| RO | 读初值 R → 写 A → 读 → 写 B → 读 | 三次读回都等于 R;两次写入均被忽略 |
| W1C | 注入置位(让字段变全 1)→ 写 A → 读 → 写 0 → 读 | 写 A 后:A 中为 1 的位清 0,为 0 的位保持 1;写 0 后值完全不变 |
| W0C | 注入置位 → 写 A → 读 → 写全 1 → 读 | 写 A 后:A 中为 0 的位清 0;写全 1 后值完全不变 |
| ROE(读清零型) | 注入置位 → 读一次 → 立即再读 | 第一次读回置位值,第二次读回清零后值;无任何写操作 |
两张走码图样是底线,不是充分条件。对 W1C 这类「写值按位决定行为」的属性,逐位单热点(one-hot)走一遍更稳:32 位字段跑 32 次「只写第 i 位为 1」,确认只有第 i 位被清、其他位纹丝不动。曾抓到一个 RTL bug:设计把 status & ~wdata 写成了 status & ~wdata[0] 的位宽截断版本,写第 0 位正常、写高位全部无效果——走码图样恰好漏过(A 的低位是 0),单热点序列一次就抓出来了。
W1C 的「注入置位」这步要特别说明:状态位通常由硬件事件置位(中断到来、错误发生),软件无法直接写 1。验证环境要么用后门(backdoor)force 置位,要么在测试台制造真实事件。用真实事件更接近系统行为,但每个位都要能独立触发;后门 force 快且可控,适合做穷举。工程上两者结合:穷举走后门,抽几位走真实事件确认「置位路径 + 清零路径」闭环。
四、在 UVM 寄存器模型里落地
UVM RAL 用 configure 的访问参数声明属性,验证序列依靠镜像(mirror)自动算期望:
// 寄存器模型构建期
status_reg = uvm_reg::type_id::create("status_reg");
status_reg.configure(this, 32, "RO");          // 整寄存器 RO(罕见,通常逐字段配)
status_reg.build();

// 更常见:逐字段配置
ctrl_reg.add_hdl_path_slice("irq_status", 0, 8, "W1C");
ctrl_reg.add_hdl_path_slice("err_flag",   8, 4, "W1C");
ctrl_reg.add_hdl_path_slice("mode",      16, 2, "RW");
ctrl_reg.add_hdl_path_slice("version",   24, 8, "RO");
模型配好之后,内建序列 uvm_reg_hw_reset_seq、uvm_reg_bit_bash_seq、uvm_reg_access_seq 能自动完成大半工作:bit_bash 逐位走单热点,access 按属性做前门后门交叉访问。这也是寄存器模型集成 反复强调「属性必须照规格书逐字段核对」的原因——模型里把 W1C 误配成 RW,内建序列就会拿「写 1 应该保持」当期望,回归满江红,而错的是模型不是设计。
两个实战提醒。第一,掩码纪律:一个寄存器里混合多种属性时,任何写操作都要带字段级掩码,一次 write(0xFFFF_FFFF) 会把 W1C 状态位全清掉,污染后续检查;用 reg_model.reg.field.set() 逐字段赋值再 update() 是安全写法。第二,镜像同步:W1C 字段被写清、RO 字段被硬件更新后,镜像值已经和 DUT 不一致,依赖镜像算期望的 scoreboard 会误报;每次属性操作后显式 mirror(status, UVM_CHECK) 让镜像追上真实值,同时这一查本身就是对属性行为的检查。
五、把序列机械化:属性矩阵驱动
属性验证天然适合表驱动。从寄存器规格书(IP-XACT 或 Excel 导出)生成一张「字段 × 属性」矩阵,验证代码遍历矩阵逐字段套用第三节的序列模板:
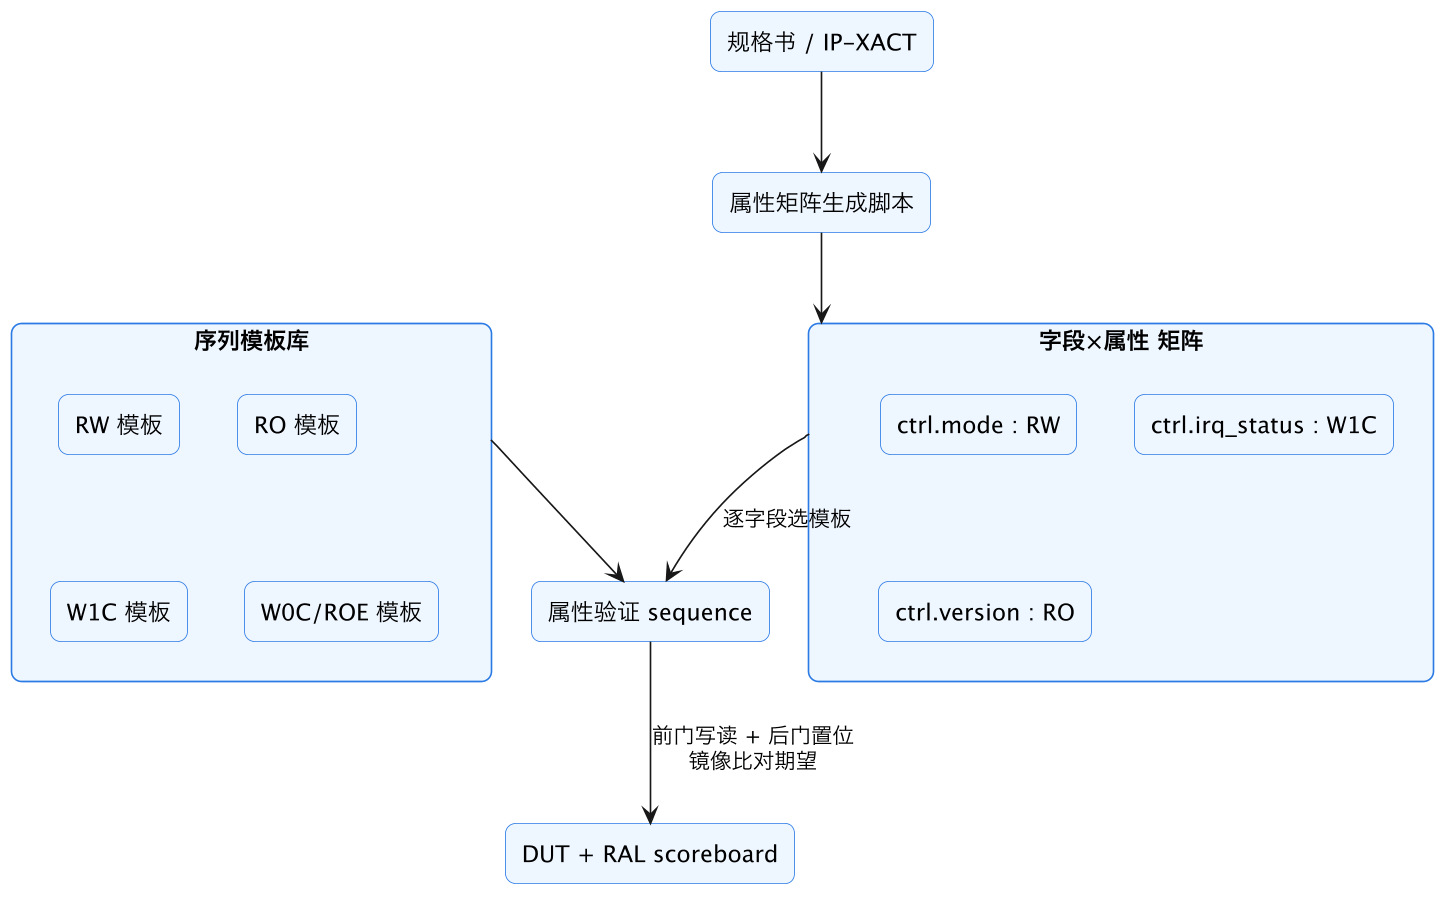
这条流水线的价值在于消灭手工对齐:规格书改一个字段属性,重新生成矩阵即可,验证代码不用动;反过来,如果规格书和模型不一致,序列一跑就红,问题在评审阶段而不是流片后暴露。中等规模 IP 的寄存器上百个、字段上千个,靠人眼对属性清单迟早漏,表驱动是这个量级下唯一靠谱的办法。矩阵同时还是覆盖率的天然数据源——每个字段每种属性验证通过就勾一格,寄存器验证的完备性一目了然,与功能覆盖率的归口见 覆盖率模型:covergroup 与 bins 设计。
这一篇在知识体系里的位置
- 上游:UVM 寄存器模型集成:RAL 与前门后门访问 提供本篇所用的模型、镜像与前门后门机制。
- 复位衔接:复位与初始化验证:释放时序与寄存器默认值 验「复位后值对不对」,本篇验「复位后行为对不对」,两篇合起来覆盖寄存器验证的静态与动态两面。
- 横向相关:中断状态位是 W1C 的最大用户,中断场景的端到端验证见 中断清除验证。
总结
寄存器读写属性验证的核心是把每个字段的 RO/RW/W1C/W0C/ROE 语义翻译成逐位的最小验证序列:RW 验写读一致,RO 验写入被忽略,W1C/W0C 验「指定位清零、其余位保持」的选择性且必须用单热点走码防位宽截断类 bug,ROE 验读动作本身的副作用;期望永远是「当前值、写入值、属性语义」的函数而非常量,UVM 落地靠逐字段配准属性 + 字段级掩码写 + 镜像同步,规模化则靠规格书生成属性矩阵驱动模板序列——属性契约逐位验穿,软件和硬件才不会在状态位上各说各话。