库噪声容限表征:CCS/ECSM noise immunity curve 的表征方法、判据与签核使用
更新时间:2026-10-06。串扰、电源噪声、电荷共享都会在信号线上打出毛刺(glitch),一个毛刺会不会把下游触发器打翻,取决于撞上它的那个标准单元「扛不扛得住」——扛毛刺的能力不是拍脑袋估的,是建库时一条一条曲线仿真出来的,这就是噪声容限表征(noise immunity characterization)。噪声模型的库侧形态见 lib 之 CCS 噪声模型,毛刺分析的机理见 噪声毛刺之攻击者与受害者。本篇讲表征这一环:noise immunity curve 怎么仿真出来、高度宽度判据怎么定、签核工具怎么消费它、表征质量怎么审计。
本文要回答的问题
- 噪声容限为什么不能用一个固定电压阈值打天下?
- noise immunity curve 的横轴纵轴各是什么,怎么仿真出来?
- CCS 与 ECSM 两种噪声模型的表征产物有什么差别?
- 签核工具拿曲线怎么判毛刺违例,表征缺项会以什么形式报复?
一、为什么容限是一条曲线而不是一个阈值
直觉上「扛毛刺」似乎就是一个电压门限:毛刺峰值超过门限就翻,超不过就没事。早期噪声分析确实这么干——用输入高低电平阈值(VIL/VIH)当判据。但这个模型漏了一个决定性命门:毛刺是有时宽的。一个峰值 0.8 倍 VDD 但宽度只有 10ps 的毛刺,通过单元的输入级时被等效 RC 滤波衰减,根本传不到输出;同样峰值、宽度 200ps 的毛刺就能穿透。容限因此是「高度-宽度」平面上的一条分界线:曲线下方的毛刺被吞掉,上方的穿透。
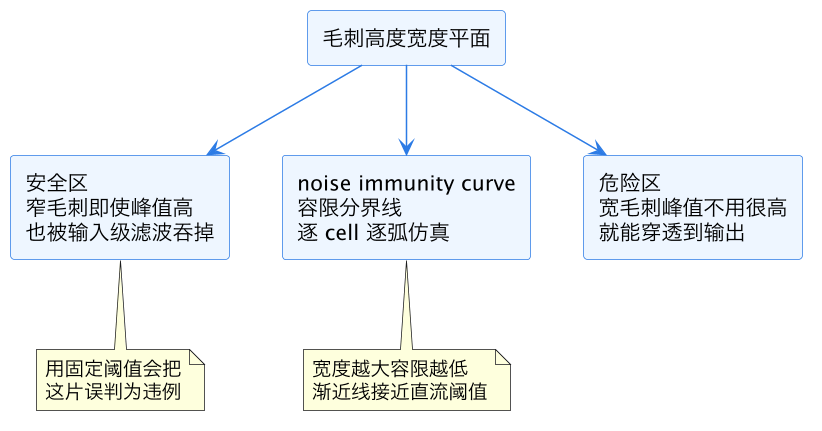
这张图同时解释了固定阈值模型的两种错误:把「高峰值窄毛刺」误判为违例(过严,制造大量假噪声违例,修起来白白绕线扩距);把「低峰值超宽毛刺」误判为安全(过松,放跑真实风险)。曲线模型的价值就是把这两类误判同时压掉。工程上还要记住曲线的一个形态特征:宽度趋于无穷时容限渐近于直流阈值(VIL/VIH),宽度趋于零时容限趋于电源轨——单元对无穷窄的毛刺理论上全免疫,这也是库表征时宽度扫描范围要覆盖实际工艺可达 slew 区间的原因,扫到不现实的宽度区间纯属浪费仿真机时。
二、表征流程:从仿真网表到库文件
noise immunity curve 的表征是标准单元库特征化流程的一个子任务,总流程见 liberty 特征化流程。针对噪声部分,动作链条是:对每个 cell 的每条输入到输出弧,在 SPICE 级网表上注入参数化毛刺(扫描高度与宽度两个维度),观察输出端是否产生「超过判决门限的扰动」,二分搜索出每个宽度下的临界高度,连成曲线,写进库文件。
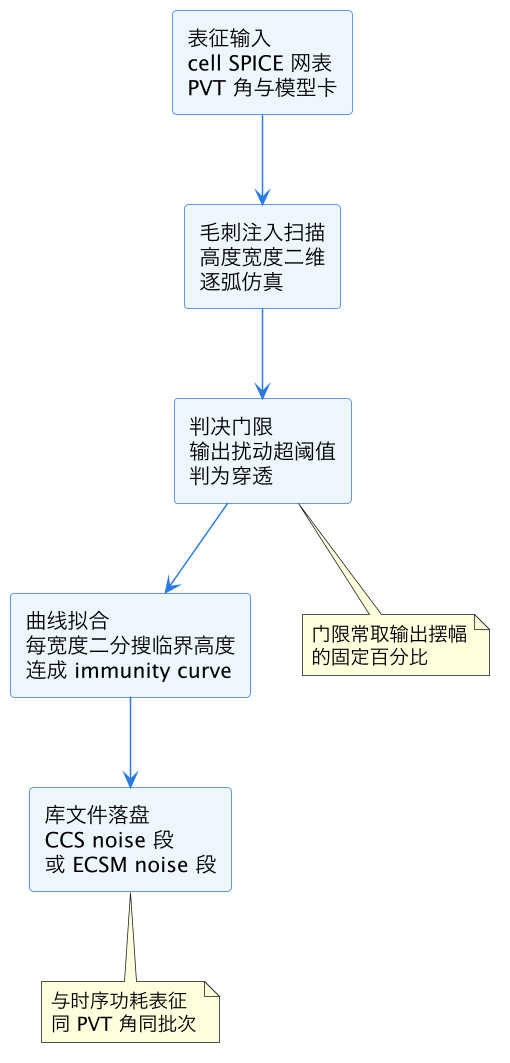
三个工艺纪律必须钉死。第一,判决门限要定义清楚且全库统一:「输出扰动超过电源轨的百分之几」这个数直接影响曲线高低,门限取 10% 和取 20% 出来的容限能差出一截——门限的定义必须与签核工具的默认假设一致,否则库和工具各说各话。第二,PVT 对齐:噪声表征必须和时序、功耗表征在同一批 PVT 角、同一版器件模型下完成——签核 corner 的时序数据来自 A 批模型、噪声数据来自 B 批模型,这种混搭库在审计时要直接打回。第三,弧覆盖完整:每条时序弧都要有对应的噪声弧,缺弧的 cell 在签核时要么被跳过(放跑风险)要么用保守默认值(制造假违例),两种都是事故。多驱动强度、多 VT 变体的曲线差异也不容忽略——同功能 cell 的 X1 与 X8 驱动、HVT 与 LVT 变体的输入级结构不同,容限曲线必须逐变体表征,不允许「同功能共用一条曲线」的偷懒做法。
三、CCS 与 ECSM:两种封装形态的差别
noise immunity curve 表征出来之后,按库的建模体系封装成两种形态:CCS(Composite Current Source,复合电流源)体系的 ccsn 段,和 ECSM(Effective Current Source Model)体系的 noise 段。两者的物理含义相同——都是「容限曲线加传播特性」——但数据结构与配套工具有别。
| 维度 | CCS noise | ECSM noise |
|---|---|---|
| 宿主体系 | Liberty ccsn 段 | ECSM 库文件 |
| 曲线表达 | 高度宽度表加直流容限 | 同类表格结构 |
| 配套时序模型 | CCS timing | ECSM timing |
| 工具生态 | PrimeTime 系为主 | 对应实现工具链 |
| 表征成本 | 与时序表征共享仿真 | 同左 |
选型上没有自由度——跟着签核工具链走,工具吃哪种就表征哪种,混合交付的库要在 数据流格式之 Liberty 视图 的视图清单里显式登记两种噪声段的存在性。真正要管的是「噪声段与时序段的同源性」:CCS timing 的电流波形表征(liberty 之 NLDM 与 CCS 时序模型)和 ccsn 的噪声表征共享同一套 SPICE 仿真基础设施时,数据一致性最好;分两套流程跑的库,噪声段和时序段的延迟-容限联动关系可能对不上,表现为签核工具报出的「毛刺传播后到达窗口」与「时序窗口」对不齐。
四、签核侧怎么消费:从曲线到违例判定
噪声签核工具(PrimeTime-SI 类)的判定链条是:先算受害网络上串扰叠加出的毛刺波形(高度、宽度、到达窗口),再查下游负载 cell 的 immunity curve——毛刺点在曲线下方,安全;在上方,进一步仿真毛刺穿过该 cell 后的传播形态,传到触发器数据端且落在采样窗口内,才最终报 noise violation。修复一侧的流程见 噪声违例修复流程。
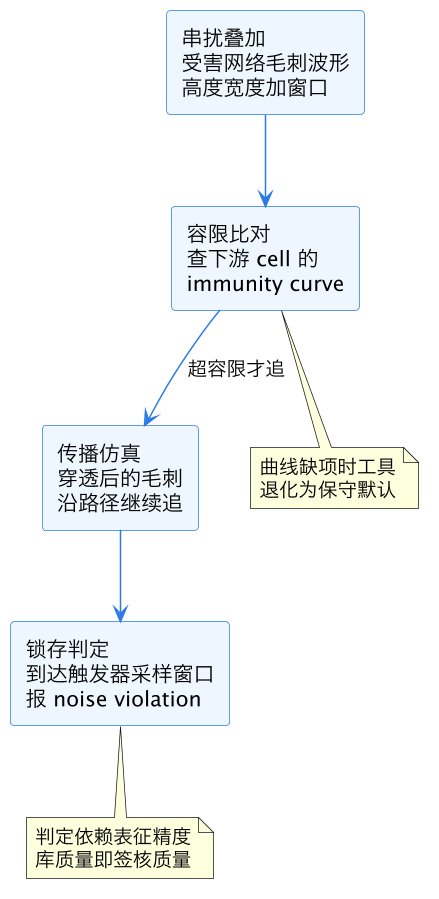
这条链条里库的表征质量直接决定签核质量,两个接口要点。其一,曲线缺项的退化行为:库里某条弧没有噪声段时,工具通常退化为固定阈值或干脆跳过该 cell——前者制造假违例、后者放跑真违例,所以库交付前的审计必须把「噪声弧覆盖率」作为硬指标,审计方法与时序弧覆盖率一致。其二,传播仿真的精度依赖:毛刺穿透一级 cell 后形态会变化(被整形、被衰减),工具按库里表征的传播特性推算,表征只给了 immunity curve 而没给传播模型的库,工具只能用简化假设,多级传播后的累积误差可观——对噪声敏感的设计(宽总线、长线网、低电压域),要选表征了完整传播模型的库版本。
五、表征质量审计与常见坑
库噪声表征的质量审计按五项走:弧覆盖率(每条时序弧有噪声弧)、PVT 对齐(与时序功耗同批)、门限一致性(判决门限定义与工具假设核对)、宽度扫描范围(覆盖工艺可达 slew 区间)、抽样复验(随机抽若干 cell 用独立 SPICE 流程重仿比对曲线)。五项里抽样复验最容易被省,也最有价值——表征流程本身的脚本 bug(比如毛刺注入极性接反、负载条件挂错)不做独立复验根本发现不了,而这样的库一旦流片,噪声分析全链路的结论都失去根基。
常见坑最后钉三个。坑一:低电压 corner 的容限崩塌——电压降低后容限曲线整体下移,且毛刺相对电源轨的占比上升,低电压域的噪声违例会成片涌现;表征时低电压角的扫描密度要加密,签核时低电压域的噪声报告要单独评审。坑二:多输入 cell 的并发假设——NAND、NOR 多输入同时受扰时的容限与单输入不同,表征按单输入假设做的库在多输入同扰场景下偏乐观;宽总线同向翻转正是这种场景,评审时对多输入 cell 集中的数据通路要加严判据。坑三:把噪声容限和 delay pushout 混为一谈——容限管「静止网络上的毛刺」,串扰对翻转中网络的延迟推挤(delta delay)是另一套分析,见 SI 串扰增量延迟,两者的库数据、判据、修复手段都不同,报告里看见 noise 字样先分清是哪一种再动手。
六、容限数据与修复手段的联动:从曲线到动作
噪声容限数据不只是「判违例的尺子」,它还直接指导修复手段的选择。把违例报告和曲线数据摆在一起看,修复决策可以钉成一张对照表。
| 违例形态 | 曲线数据解读 | 首选修复 | 为什么 |
|---|---|---|---|
| 毛刺点略超曲线 | 容限差几个百分点 | 换高容限 cell | 同功能不同变体容限不同 |
| 毛刺宽度很窄但峰值高 | 处于曲线左端陡升区 | 通常无需修 | 复核工具判据再定 |
| 毛刺宽且峰值中等 | 处于曲线右端渐近区 | 减耦合或加屏蔽 | 换 cell 救不了 |
| 多级传播后违例 | 累积整形效应 | 截断传播链 | 中间插 buffer 整形 |
| 触发器数据端违例 | 直接威胁采样 | 最高优先级 | 换 cell 加修源双管齐下 |
表里第一行是容限表征的隐藏红利:同一功能的不同 cell 变体(不同驱动、不同 VT、不同输入级结构)容限曲线可以差出可见的一截——签核工具报违例时,如果修复手段清单里有「换同功能高容限变体」,这几乎总是成本最低的一招:不动走线、不动布局结构,只是库内替换。这也是表征覆盖率的另一面价值:变体的容限差异只有逐变体表征过才知道,共用曲线的库等于把这个修复选项从工具箱里删掉了。
第三行值得展开:宽毛刺落入曲线右端渐近区时,容限已接近直流阈值,换任何 cell 的容限都大同小异——此时修复必须在「毛刺本身」上做文章:减小耦合电容(扩距、换层)、削弱攻击者 slew(限制驱动)、或者加屏蔽线,手段排序与 SI 串扰增量延迟 第四节的优先级同一套逻辑。判错这一行——对着渐近区的违例狂换 cell——是噪声修复里最典型的无效劳动,报告数字纹丝不动,工时烧掉一周。
第四行的「截断传播链」也有讲究:毛刺每穿过一级 cell 都会被整形一次,整形方向取决于该级的容限曲线和驱动能力——在传播路径中间插一级 buffer,等于强制把毛刺重新整形为正常逻辑摆幅,累积效应就此归零。这招的代价是增加延迟和面积,所以要用在传播链长、穿过多级才到触发器的路径上;传播链短的违例直接修源头更划算。
修复完成后还有一步回头动作:把修复前后的违例数与容限裕量分布存进项目数据库。几轮项目积累下来,「本工艺节点、本库版本下,哪类 cell 变体是噪声修复主力」就有了一手统计——这份统计反过来指导下一个项目的库选型与表征审计重点,库表征才真正从「交付物清单里的一项」变成「项目间复用的资产」。
这一篇在知识体系里的位置
本篇是库特征化专题的噪声篇:模型概念前置在 lib 之 CCS 噪声模型,总流程在 liberty 特征化流程,时序模型侧在 liberty 之 NLDM 与 CCS 时序模型;下游消费方是 噪声违例修复流程 与 噪声毛刺之攻击者与受害者;横向关联 SI 串扰增量延迟(delay pushout 一侧的边界)、数据流格式之 Liberty 视图(库交付的视图登记)与 标准单元 PDK 库视图。
总结
库噪声容限表征的核心是把「单元扛毛刺」从固定电压阈值升级成高度-宽度平面上的 immunity curve:逐 cell 逐弧做毛刺注入扫描、按统一判决门限二分搜索临界高度、与时序功耗同批 PVT 角表征后封装进 CCS 或 ECSM 噪声段;签核工具拿曲线做「容限比对加传播仿真加锁存判定」的三段式违例判定,曲线的弧覆盖率、PVT 对齐、门限一致性、宽度范围与抽样复验五项审计直接决定签核结论的可信度——库里的曲线有多准,硅上的毛刺风险底数就有多清。