逻辑努力与扇出:门尺寸优化的一阶算术,反相器链最优扇出 e 是怎么来的
逻辑门与晶体管:从开关到门电路的电气特性 讲过一个直观事实:一个门驱动的下级输入越多、负载电容越重,翻转就越慢;工程上靠选 X1/X2/X4 不同驱动强度的单元来平衡。但「具体该选多大、中间插几级缓冲、每级放大多少倍」并不是凭感觉试出来的,背后有一套干净的一阶算术:逻辑努力(logical effort)方法。它把门的拓扑复杂度和负载状况折算成同一套无量纲系数,让设计者用纸笔就能估算一条路径的最小延迟与各级尺寸。本篇讲清这套系数怎样定义、路径延迟怎样求最小值,以及反相器链最优扇出为什么在数学上指向自然常数 e、工程上又普遍取 4。全篇只用教材级公认系数与自设算例,不引用任何具体工艺数据。
本文要回答的问题
- 门延迟为什么能写成 d = p + g·h 这种线性形式,τ、p、g、h 各自是什么?
- 逻辑努力 g 衡量的是门的什么成本,为什么 NAND 的 g 比反相器大、NOR 又比 NAND 大?
- 电气努力、分支努力、级努力和路径努力 F = G·H·B 之间是什么记账关系?
- 一条多单元路径延迟最小的条件是什么,各级门尺寸按什么规律递推?
- 反相器链的最优扇出 e≈2.718 是怎样推导出来的,实际工程为什么常用 ~4 而不是 e?
- 这套一阶方法在什么情况下失真,它和 Elmore 线延迟、STA 签核怎样分工?
先给一张流程卡,把本篇的推理主线铺开:从延迟模型出发,依次定义门级系数、汇总成路径努力、求最优条件,最后落到尺寸递推与工程修正。
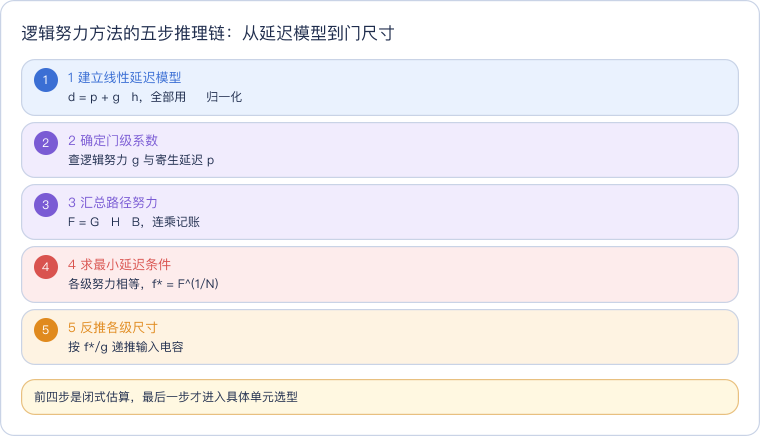
这张卡对应全篇的阅读顺序:前四步只处理无量纲系数,回答「这条路径理论上能多快、该分几级」,最后一步才把系数翻译成标准单元库里的具体驱动强度。读完整篇后回到这张卡,每个箭头都能对上一段推导。
一、线性延迟模型:把门延迟拆成寄生项与努力项
逻辑努力方法的地基是一个经验上足够准的线性模型。先定义时间单位 τ:一个理想反相器驱动另一个相同反相器(即扇出为 1、忽略寄生的理想情形)的延迟。用 τ 归一化后,任意一个门的延迟 d 写成两项之和:
# 线性延迟模型(d 为无量纲延迟,绝对延迟 = τ × d)
d = p + g·h

# p:寄生延迟,门自身输出节点的扩散电容造成,与负载无关
# g:逻辑努力,门拓扑相对反相器的本征成本
# h:电气努力,外接负载电容与自身输入电容之比
为什么是线性的?CMOS 门的传播延迟近似等于输出电阻对负载电容充电的 RC 时间。把门等效成一个导通电阻 R_drive 驱动两个并联电容——门自己输出端的寄生电容 C_par 和外部负载电容 C_load,延迟就正比于 R_drive·(C_par + C_load)。第一项与负载无关,归为寄生项 p;第二项随负载线性增长,归为努力项 g·h。这个近似在输入跳变沿足够陡、负载在合理范围内时与实测吻合良好,也是标准单元库延迟表在固定输入斜率下近似呈直线的原因。
关键在于归一化的方式。同样驱动一个相同反相器时,反相器自己的延迟定义为基准,于是反相器的逻辑努力 g_inv = 1、寄生延迟 p_inv = 1。其他门都相对这个基准度量,所以全部系数都是无量纲的纯数字,不绑定任何工艺节点——这正是这套方法可以脱离工艺手册做架构级估算的原因。
读图抓两条:灰色是模型前提,输入斜率失真问题在第七节专门交代;蓝色门本体贡献与负载无关的寄生项,橙色外部负载贡献努力项,紫色公式是两者的归一化合并。后面所有推导都是在这张图的拆分上做代数,不引入新的物理。
二、逻辑努力 g:门拓扑的本征成本
逻辑努力 g 的严格定义是:为了获得与反相器相同的输出导通电阻,一个门所需的输入电容与反相器输入电容之比。通俗说,g 回答「同样的驱动能力,这个门的输入要比反相器『胖』多少」。输入越胖,前级看到的负载越重,这就是复杂拓扑必须支付的本征成本。
以两输入门为例。反相器输入电容记为 3 份(PMOS 宽 2、NMOS 宽 1,补偿空穴迁移率约为电子一半的工艺事实)。两输入 NAND 为保证最坏情况下输出电阻与反相器相同,两个串联 NMOS 各自宽度要翻倍到 2,两个并联 PMOS 保持 2,总输入电容 4 份,于是 g_NAND2 = 4/3。两输入 NOR 的串联管换成 PMOS,两个 PMOS 各自宽度要做到 4,总输入电容 5 份,g_NOR2 = 5/3。同理可以推出 n 输入门的通式。
| 门类型 | 逻辑努力 g | 寄生延迟 p | 成本来源 |
|---|---|---|---|
| 反相器 INV | 1 | 1 | 基准门 |
| 两输入 NAND | 4/3 ≈ 1.33 | 2 | NMOS 串联,两管加宽 |
| 三输入 NAND | 5/3 ≈ 1.67 | 3 | 串联链更长,加宽更多 |
| 两输入 NOR | 5/3 ≈ 1.67 | 2 | PMOS 串联,迁移率劣势叠加 |
| 三输入 NOR | 7/3 ≈ 2.33 | 3 | 弱管串联,输入电容代价最高 |
表中数值是逻辑努力经典教材在「PMOS/NMOS 迁移率比取 2、上下拉电阻对称」假设下的解析结果,真实工艺库会围绕这些值小幅浮动,但排序不变:反相器最便宜,NAND 随输入数缓慢变贵,NOR 因弱管串联显著更贵。这直接解释了 CMOS 设计里「优先用 NAND、避免高输入数 NOR」的经验法则——它不是风格偏好,而是 g 值表上的算术结论。寄生延迟 p 则主要随串联管数量增长,反相器取 1,n 输入的 NAND/NOR 近似取 n。
三、电气努力 h、分支努力 b 与级努力 f
单门的负载状况由两个系数描述。电气努力(electrical effort) h = C_load / C_in,即外部负载电容与门自身输入电容之比,直白说就是「这一级在电容尺度上放大了多少倍」。扇出(fan-out)这个词在工程语境里常指驱动了多少个下级门,而 h 是把数量折算成电容比值后的精确版本:驱动四个与自己同尺寸的反相器,h 恰好等于 4。
当一个门的输出除了驱动本路径下一级,还要旁路驱动其他支路时,需要引入分支努力(branching effort):
# 分支努力:节点上总电容与本路径电容之比
b = (C_onpath + C_offpath) / C_onpath

# 级努力(stage effort):一个门实际承受的总努力
f = g · h · b

# 代回线性模型,单门延迟也可以写成
d = p + f
没有旁路支路时 b = 1,级努力退化为 f = g·h。b 的记账意义在扇出很大的控制网络里特别重要:时钟使能、复位分发这类节点一个输出挂几十个负载,旁路电容占了绝对大头,不乘 b 就会严重低估延迟。注意 g、h、b 三者都是无量纲数,相乘后仍是无量纲数,这让整条路径的计算可以完全在归一化空间里完成,最后再乘 τ 换回真实时间。
四、路径努力 F = G·H·B 与等努力原则
把视线从单门抬到一条 N 级门组成的路径。逻辑努力方法用三个连乘积给整条路径记账:
# 路径逻辑努力:各级 g 连乘
G = g1 · g2 · … · gN

# 路径电气努力:路径末端总负载与首级输入电容之比
H = C_L / C_in1

# 路径分支努力:各级 b 连乘
B = b1 · b2 · … · bN

# 路径总努力
F = G · H · B

# 路径总延迟 = 寄生项之和 + 各级努力之和
D = Σp_i + Σf_i
# 且各级努力满足连乘约束
f1 · f2 · … · fN = F
最后一条连乘约束是关键:级努力沿路径的乘积被 F 锁死,设计者能自由分配的只是每一级承担多少。数学上,乘积固定时求和的最小值在所有因子相等处取得(均值不等式)。于是路径延迟最小的条件——等努力原则——浮出水面:
# 最优条件:每一级努力相等
f* = F^(1/N)

# 路径最小延迟
D_min = P + N · F^(1/N) # P = Σp_i等努力原则给出的物理图景是:一条优化到最快的路径上,不该出现某一级特别吃力、其余级别很轻松的局面。STA 违例修复:Vt 置换与尺寸放大的工程手法 里提到「级联链上盲目把每一级都 upsize,总延迟反而可能上升」,根因就在这里——放大一级会同时加重它前级的电气努力,破坏努力的均匀分配,净收益被吃掉。
知道每级的目标努力 f* 后,各级输入电容(即门尺寸)沿路径反向递推:
# 由 f_i = g_i · C_in(i+1) / C_in(i)(b=1 时)反推
C_in(i+1) = C_in(i) · f* / g_i

# 反相器链 g_i 全为 1,尺寸直接按 f* 等比放大
蓝色是同构的三级反相器,灰色是路径末端的固定负载,紫色给出贯穿全链的尺寸规则。这张图就是下一节算例一的结构:当每级努力都等于 4 时,输入电容按 1→4→16→64 等比排列,没有任何一级承担超额负担。
五、反相器链最优扇出:e 的由来与工程取 4
缓冲器链(两级反相器构成一个 buffer,故反相器链是缓冲问题的一般形式)的级数选择,是逻辑努力方法最经典的应用。设首级输入电容到末级负载的总电气努力为 H,反相器链 G = 1、B = 1,故 F = H;每级寄生延迟 p_inv = 1。链的总延迟为:
D = N + N · H^(1/N)先做数学上的理想化:忽略寄生项,只最小化努力部分 N·H^(1/N)。令每级努力 f = H^(1/N),则 N = lnH / lnf,代入后:
# 忽略寄生项
D_effort = N·f = lnH · f / lnf

# lnH 是常数,对 f 求最小值
d/df [ f / lnf ] = 0 → lnf = 1 → f = e ≈ 2.718这就是最优扇出 e(自然常数的底数)的由来:在纯努力模型下,让每级承担 e 倍电容放大,级数 N = lnH 时总努力延迟最小。e 不是经验数字,而是「乘积固定、级数可调」这个约束结构的解析解。
把寄生项加回来,结论会小幅移动。此时最小化的目标变成 (1+f)/lnf,求导得到极值方程 lnf = 1 + 1/f,数值解 f ≈ 3.59。也就是说,计入每级都要付一次的寄生成本后,每级少分一点努力、多用一级反而更划算,最优点从 2.718 上移到约 3.6。
工程实践再往外走一步,普遍按 f ≈ 4(扇出 4,FO4,Fan-Out-of-4) 设计,原因有三:其一,延迟曲线在 f 取 3 到 5 之间非常平坦,f=4 与理论最优点的延迟差不足几个百分点,却显著减少级数、面积与功耗;其二,真实输入斜率有限,级努力太大导致沿变缓、斜率退化会被逐级放大,取 4 留有裕量;其三,FO4 本身成了跨工艺的通用延迟标尺——一个工艺下 FO4 反相器的绝对延迟常被当作该工艺的「门延迟货币」,用来粗估任何路径的级数预算。
| 每级努力 f | 相对位置 | 延迟表现 | 级数/面积代价 | 适用判断 |
|---|---|---|---|---|
| 2.7(e) | 纯努力模型解析最优 | 努力项最小 | 级数最多,面积功耗大 | 仅理论参照,寄生不可忽略时不优 |
| 3.6 | 含寄生模型的数值最优 | 总延迟数学最小 | 级数仍偏多 | 理论设计最优点 |
| 4(FO4) | 工程惯例 | 比最优值慢几个百分点 | 级数适中,斜率裕量足 | 主流设计默认选择 |
| ≥6 | 努力过大区 | 单级延迟明显上升、沿退化 | 级数少但单级过载 | 仅面积极端受限时妥协 |
六、两个可复算的手算算例
算例一:三级反相器链的尺寸递推与等努力收益
设一条三级反相器链,首级输入电容为 C,末级负载电容为 64C,即路径电气努力 H = 64,级数 N = 3 固定。
按等努力原则,每级目标努力 f* = H^(1/N) = 64^(1/3) = 4。反相器 g = 1,故每级电气努力都是 4,输入电容按 4 倍等比递推:1C → 4C → 16C,末级驱动 64C 负载。每级延迟 d_i = p + f = 1 + 4 = 5,总延迟:
D_等努力 = 3 × 5 = 15 τ换一组不均匀的尺寸作对照:三级取 1C、2C、8C,末级仍带 64C。三级电气努力分别为 2、4、8,对应延迟 3、5、9:
D_不均匀 = (1+2) + (1+4) + (1+8) = 3 + 5 + 9 = 17 τ两条链的总放大倍数都是 64、级数都是 3,仅仅因为努力分配方式不同,等努力方案快了约 12%。乘积相同(2×4×8 = 4×4×4 = 64)而和不同(14 对 12,另加相同的寄生项 3),正是均值不等式的直接体现,也复现了第四节「不要让单级过载」的结论。
算例二:总努力 100 的反相器链该分几级
设 H = 100,级数 N 待定,用 D = N + N·100^(1/N) 枚举候选级数:
N = 3:f = 100^(1/3) ≈ 4.642,D = 3 + 3×4.642 ≈ 13.93 + 3 = 16.93 τ
N = 4:f = 100^(1/4) ≈ 3.162,D = 4 + 4×3.162 ≈ 12.65 + 4 = 16.65 τ
N = 5:f = 100^(1/5) ≈ 2.512,D = 5 + 5×2.512 ≈ 12.56 + 5 = 17.56 τ
三个候选中 N = 4 最优。用连续最优式校验:取含寄生的最优级努力 3.59,理论级数 N_opt = ln100 / ln3.59 ≈ 4.605 / 1.278 ≈ 3.6,就近取整正是 4,与枚举一致;若用纯努力模型的 e 估算,N = ln100 ≈ 4.6,同样指向 4 到 5 级之间。这个算例也展示了级数决策的完整姿势:先用 N ≈ lnF/lnf* 定方向,再对相邻两个整数级各算一遍 D 收尾——离散的门级数不允许连续解,枚举两个候选的成本只是一次算术。
七、适用边界:线性模型在哪里失真
逻辑努力是一阶手算方法,用它的前提也是它的边界,至少有四条要守住。
第一,输入斜率被默认为足够陡。d = p + g·h 里没有输入转换时间这个变量,而真实门延迟对输入沿明显敏感:慢沿让一对互补管长时间同时导通,输出电阻等效值漂移,延迟不再落在那条直线上。级努力取过大会让斜率退化沿链累积,这正是工程取 4 而非理论值的原因之一。
第二,互连线延迟没有进模型。g、h、b 全部按电容记账,把负载当成集总电容;进入深亚微米工艺后,长互连线的电阻不可忽略,RC 分布效应让「负载只是一个电容」的假设破产。这部分要交给互连线延迟与 Elmore 模型 的一阶矩方法处理:逻辑努力管门的尺寸架构,Elmore 管线段的充电延迟,两者在缓冲器插入点上汇合——插 buffer 把长线切段,既是用反相器链重置驱动能力,也是把每段 RC 压回门延迟可控的尺度。
第三,它给的是架构级估算而非签核数字。标准单元库的实际延迟写在 .lib 的二维表里,按输入斜率与输出负载双重索引,静态时序分析 STA 入门 介绍的签核流程走的是查表加增量迭代,还要覆盖多工艺角落与 OCV 降额。逻辑努力的正确位置在综合之前:综合入门:RTL 怎样变成门级网表 之前做路径级数规划、驱动强度预算和拓扑选型(NAND 还是 NOR、插不插缓冲链),把一阶最优结构交给工具,再由 STA 在真实寄生下精修。
第四,系数依赖对称上升/下降的假设。表里的 g 值假设上下拉电阻对称、迁移率比为 2,实际工艺库逐单元标定,偏斜门(skewed gate,故意让一个方向更快)的 g 会偏离通式。处理这类单元时应从库文档反推等效系数,而不是照套解析值。
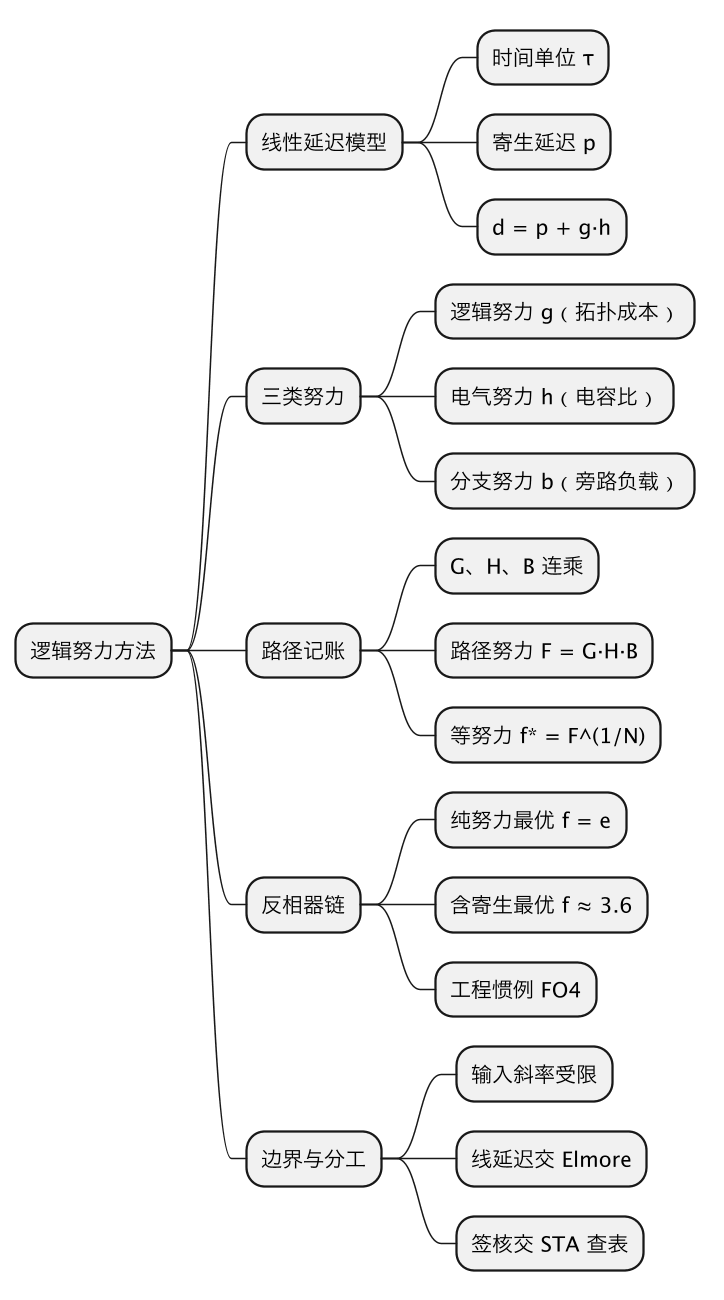
这张思维导图把全篇收成五个分支:模型层定义延迟怎么拆,努力层定义三个系数,路径层做连乘记账与求极值,反相器链给出最著名的特例结论,边界层标明方法失效后由谁接手。读图时沿「模型→系数→路径→特例→边界」的顺序回忆,即可重建整套推导。
这一篇在知识体系里的位置
本篇处在数字 IC 设计知识簇的电路层与时序层交界处。下游直觉来自逻辑门与晶体管 的扇出与驱动强度概念,本篇把那句「负载越重越慢」升级为可求极值的算术;物理实现侧,门延迟与线延迟相加的完整路径延迟观对应互连线延迟与 Elmore 模型,工具落地对应静态时序分析 STA 入门 的查表签核与综合入门 的单元选型,工程修复手法对应 STA 违例修复:Vt 置换与尺寸放大 中尺寸优化为什么必须沿整条链均匀施力。读到 FO4 延迟标尺时,可回到时序为什么不满足:建立时间、保持时间与时钟偏差余量,用它给周期预算做量级核对。
总结
逻辑努力方法在线性延迟模型 d = p + g·h 上建立了一套全无量纲的门尺寸算术:g 度量门拓扑相对反相器的输入电容成本,h 是负载电容与输入电容之比,b 补记旁路分支,三者在路径上连乘成路径努力 F = G·H·B。由乘积固定时求和在因子相等处最小,得到等努力原则 f* = F^(1/N) 与路径最小延迟 D_min = P + N·F^(1/N),门尺寸沿链按 f*/g 递推。反相器链是其最干净的特例:忽略寄生时极值方程的解析解是每级扇出 e≈2.718,计入寄生后数值最优上移到约 3.6,兼顾斜率退化、面积功耗与延迟曲线平坦区后工程统一取 FO4。两个算例验证了等努力分配对不均匀分配的延迟优势,以及用 lnF/lnf* 定级数、相邻整数枚举收尾的决策姿势。这套方法只管输入沿陡、集总负载下的一阶架构估算,输入斜率失真、互连线 RC 主导与签核级精度要分别让位给库表建模、Elmore 延迟与 STA 查表,它的价值不在替代工具,而在动笔写 RTL 之前就把级数与尺寸的结构算对。