仿真回归控制Shell脚本模板:种子循环、逐种子日志与失败汇总
更新时间:2026-10-29。模板实战页,属于芯片设计入门系列。RTL 改了一行,手头的测试全部要重跑一遍——每个种子点开一次仿真、肉眼扫一遍输出,这种活超过三个种子就该交给脚本。本文给出一份可以直接抄走的仿真回归控制 Shell 脚本模板:种子怎么给、日志怎么命名、PASS/FAIL 怎么判、失败了怎么汇总,全部用真实仿真跑过两遍验证。关于回归该多久跑一次、回归规模怎么规划,见 回归该跑多勤;更大规模的方法论见 回归管理方法论。
本文要回答的问题
- 一份最小可用的回归控制脚本要包含哪几段?
- 为什么回归脚本里通常用
set -u而不是set -e? - PASS/FAIL 为什么不能只看仿真进程退出码?
- 失败汇总和退出码怎么设计,CI 才能直接接住?
- 加超时、加并行度,改动落在哪几行?
一、使用场景与整体流程
这套模板覆盖的场景:一个或多个 testbench,每个用若干随机种子反复跑,要求「一次命令跑完所有种子、结束时一眼看到哪几个挂了、整个命令的退出码能直接给 CI 用」。这正是 验证与测试的区别 里说的随机回归侧的日常形态——激励是随机的,覆盖面靠种子数量堆。
什么时候不该用它:只有一个定向用例、跑一次就完事的冒烟阶段,直接命令行跑 vvp 更省事;回归规模上到每晚几百种子、需要跨机调度时,这份脚本是种子管理层的内核,外层要换调度系统,思路不变。
整张脚本的流程可以压成五步,先有个整体印象再逐段看代码。
这张图里第四格是关键:判定不是只看 vvp 的退出码,而是「退出码为 0、日志里有 TEST PASS、日志里没有 TEST FAIL」三个条件同时成立才算过。原因在第三节展开。
二、完整脚本
下面就是模板本体,三十来行,抄走改三个变量(DUT、TB、编译选项)就能用。
#!/usr/bin/env bash
# run_regress.sh -- 仿真回归控制脚本模板(iverilog 版)
set -u                      # 引用未定义变量即报错
LOG_DIR="${LOG_DIR:-logs}"
mkdir -p "$LOG_DIR"

DUT="alu8.v"
TB="tb_alu8.v"
SIMV="$LOG_DIR/simv.out"

# 1. 编译:失败直接退出,回归没有意义
if ! iverilog -g2005 -o "$SIMV" "$DUT" "$TB"; then
    echo "[REGRESS] COMPILE FAIL, abort"
    exit 2
fi

# 2. 种子清单:SEED_LIST 优先,否则随机生成 NSEED 个
if [ -n "${SEED_LIST:-}" ]; then
    seeds="$SEED_LIST"
else
    n="${NSEED:-5}"; seeds=""; i=0
    while [ "$i" -lt "$n" ]; do
        seeds="$seeds $((RANDOM * 32768 + RANDOM))"
        i=$((i + 1))
    done
fi

# 3. 逐种子仿真 + 判定
pass_list=""; fail_list=""
for s in $seeds; do
    log="$LOG_DIR/seed_${s}.log"
    vvp "$SIMV" +seed="$s" > "$log" 2>&1
    rc=$?
    if [ $rc -eq 0 ] && grep -q "TEST PASS" "$log" \
       && ! grep -q "TEST FAIL" "$log"; then
        echo "[REGRESS] seed=$s PASS"
        pass_list="$pass_list $s"
    else
        echo "[REGRESS] seed=$s FAIL (rc=$rc, log=$log)"
        fail_list="$fail_list $s"
    fi
done

# 4. 汇总与退出码
np=$(echo $pass_list | wc -w | tr -d ' ')
nf=$(echo $fail_list | wc -w | tr -d ' ')
echo "[REGRESS] SUMMARY pass=$np fail=$nf"
if [ "$nf" -gt 0 ]; then
    echo "[REGRESS] FAILED SEEDS:$fail_list"
    exit 1
fi
echo "[REGRESS] ALL PASS"
exit 0
三、逐段讲解
set -u 与 set -e 的取舍。 脚本开头只有 set -u:引用未定义变量(比如手滑把 SEED_LIST 写成 SEEDLIST)立刻报错,这是白送的安全带。但不加 set -e——回归循环里 vvp 失败、grep 没匹配到都会返回非零,开了 set -e 脚本会在第一个失败种子处直接暴毙,后面九十九个种子的结果全部丢失,失败汇总也打不出来。回归脚本的核心职责恰恰是「失败也要跑完再汇报」,错误处理全部手工做(每个 if 显式判),比 set -e 的默认行为更贴合语义。
日志命名。 每个种子一个文件 logs/seed_<种子>.log,名字里带种子号,失败后能按名字直接定位;编译产物 simv.out 也放进日志目录,清理时整个 logs/ 删掉就行。对比把全部输出糊在一个大日志里的做法:失败时要在几千行里搜报错位置,CI 归档也没法按种子拆。
种子清单的两种来源。 SEED_LIST 指定种子用于两类场合:失败复现(别人报「seed=13 挂了」,你原样重放)和每日固定回归(清单入库、人人一致);NSEED 随机生成用于覆盖率冲刺——bash 的 RANDOM 只有 15 位,两个相乘凑出 30 位种子,避免高位恒零。关键纪律:随机模式下打出来的种子号就是现场唯一凭证,脚本把每个种子号都打进输出和日志文件名,事后才能复现任何一轮。
判定三重条件。 只看退出码不够:testbench 里 $finish 正常结束时 vvp 退出码也是 0,仿真器自身崩溃则非零。所以要同时满足「rc=0、日志出现 TEST PASS、日志不出现 TEST FAIL」。这要求 testbench 侧有纪律地打印这两个关键串——本模板的 tb_alu8.v 里,50 组随机向量零失配打印 TEST PASS seed=...,否则打印 TEST FAIL 并列出失配明细。关键串定成 TEST PASS/TEST FAIL 而不是裸的 PASS,是为了避开 RTL 里可能出现的同名单词误命中。
退出码约定。 编译失败 exit 2、有种子失败 exit 1、全过 exit 0——三种结局三个码,CI 的 pipeline 可以直接 || 接住失败分支,失败种子清单已经打在标准输出末尾,不用再翻日志。
四、实跑验证
脚本配一个 8 位 ALU 作 DUT、自校验 testbench 作 TB,用 Icarus Verilog 实跑两轮:第一轮五个种子全过,第二轮通过 FAIL_INJECT 宏人为让 seed=13 必挂,验证失败汇总路径。
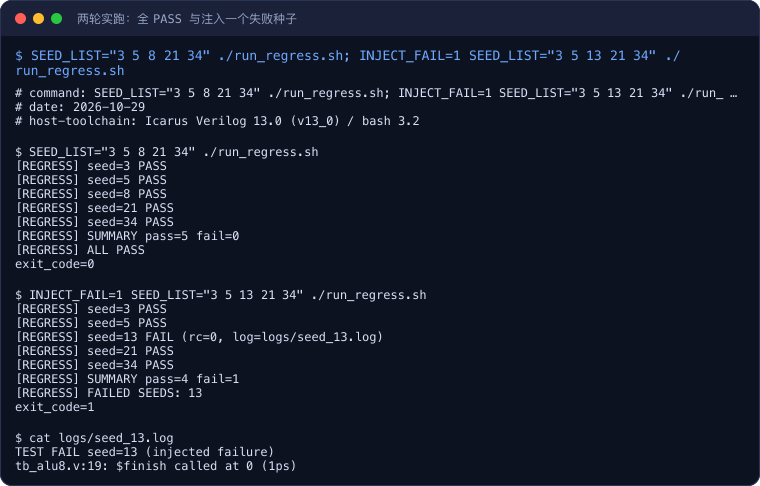
读这份实录抓三个点:全过那轮 SUMMARY pass=5 fail=0 之后 exit_code=0;注入失败那轮 seed=13 FAIL 照样把后面 21、34 跑完(这就是不加 set -e 换来的行为),最后 FAILED SEEDS: 13 且 exit_code=1;最后把 seed=13 的独立日志打出来,里面是 testbench 打印的 FAIL 行——定位到具体种子只需一条命令。
代码获取:完整脚本、DUT 与 testbench 在公开仓 experiments/tpl-regression-shell,克隆后按 README 执行 ./run_regress.sh 即可复现上面两轮结果。
五、注意事项与修改示范
CI 集成。 脚本退出码已经是 CI 友好的,接 Jenkins/GitLab CI 时把 logs/ 目录配成 artifact 归档即可;[REGRESS] 前缀的输出行方便在 CI 日志里 grep 定位。注意 CI 容器里跑 iverilog 这类工具时,把编译与仿真拆成两个 job 能省一半重跑时间——编译产物作为 artifact 传给回归 job,改 testbench 时才需要重编译。想跑更大规模回归再上调度系统,参考 LSF 网格回归。
磁盘清理。 每个种子一个日志,种子多了会攒得很散。两个习惯:日志目录按日期或 CI build 号分层(logs/2026-10-29/),CI 上设保留期定期清;波形文件默认不开,只在失败种子重跑时加 $dumpvars——回归轮次里 99% 的日志没人会看第二眼,只有失败那一两个值得留全。
加超时。 仿真挂死时循环会卡死,给 vvp 套一层 timeout:
timeout 300 vvp "$SIMV" +seed="$s" > "$log" 2>&1
rc=$?   # 124 = 超时被杀,走 FAIL 分支,日志里注明 timeout
加并行。 种子之间无依赖,用 xargs -P 把 for 循环换成并行,8 核机器开 -P 8:
echo $seeds | tr ' ' '\n' | xargs -P "${JOBS:-4}" -I{} \
    sh -c 'vvp "$0" +seed={} > "logs/seed_{}.log" 2>&1' "$SIMV"
并行后判定要改成第二轮统一扫日志(不能再在循环里边跑边判),把种子列表再 for 一遍、逐个 grep 对应日志即可。这种「执行与判定分离」的结构也是大回归系统的通用形态。
只重跑失败种子。 修完 bug 后不必整轮重跑,把上一轮的 FAILED SEEDS 行摘出来喂回 SEED_LIST 即可——这正是清单模式的价值:
SEED_LIST="$(grep 'FAILED SEEDS:' logs/prev.log | cut -d: -f2)" ./run_regress.sh实验环境
- 机器/系统:Mac mini M4 / macOS(Darwin 25)
- 工具版本:Icarus Verilog 13.0(
iverilog -V输出Icarus Verilog version 13.0 (stable) (v13_0)),bash 3.2 - 日期:2026-10-29
- 完整命令:
SEED_LIST="3 5 8 21 34" ./run_regress.sh;INJECT_FAIL=1 SEED_LIST="3 5 13 21 34" ./run_regress.sh;cat logs/seed_13.log
这一篇在知识体系里的位置
本篇是「仿真跑起来之后如何管起来」的最小工程件:向上接 回归管理方法论 的规模化管理,横向对比 Makefile 与 Shell 的 EDA 管理分工,testbench 自校验写法可对照 同步 FIFO 的 iverilog 实验。
总结
仿真回归控制 Shell 脚本模板的核心是五段:编译守卫、种子清单(SEED_LIST 或随机)、逐种子独立日志、退出码加 TEST PASS/FAIL 三重判定、失败汇总与非零退出码。用 set -u 不用 set -e,是为了失败种子不阻断后续执行;退出码 0/1/2 三分让 CI 直接接住。模板三十余行、经 iverilog 两轮实跑验证,抄走改三个变量即可用。