GPU 是什么?和 CPU 的本质区别,为什么 AI 非它不可
更新时间:2026-09-08。本文是
gpu/域入门第 01 篇。域导航见 GPU 计算导读;FPGA 视角对照见 fpga 域的 GPU 计算入门与 FPGA 对照;神经网络侧见 nn/ 神经网络域。
一、GPU 为什么长这样
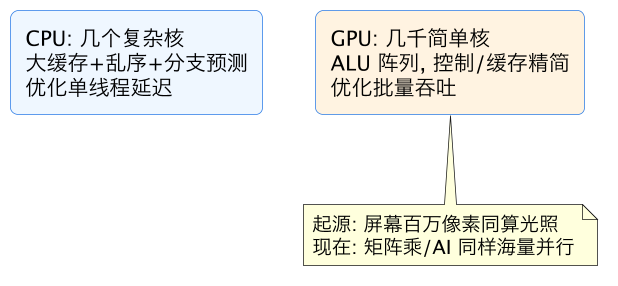
- 渲染需求:百万像素独立同运算 → 天然大规模并行;
- 晶体管预算:GPU 砸在计算单元,CPU 砸在缓存/控制。
二、快起来的两个支柱
- SIMT 众核:warp(32 线程)锁步执行同一条指令处理不同数据;
- 海量线程掩盖延迟:一组等显存就切另一组,计算单元不空转、带宽被铺满。
前提:任务并行度高、规则、算术强度高。
三、生态
| 平台 | 软件栈 | 现状 |
|---|---|---|
| NVIDIA | CUDA + cuBLAS/cuDNN/NCCL | 生态最成熟,AI 默认 |
| AMD | ROCm | 开源,追赶中 |
| Intel | oneAPI / Level Zero | 数据中心 GPU |
| 跨厂商 | OpenCL / SYCL | 可移植,含 FPGA |
常见坑对照
| 误解 | 实际 |
|---|---|
| GPU 什么都比 CPU 快 | 只有高并行规则负载才快 |
| 核心多=单任务延迟低 | GPU 单任务延迟高且抖动 |
| 有 GPU 就能跑 AI | 还要驱动/CUDA/cuDNN 版本配套 |
| GPU 取代 FPGA | 训练 GPU 强,低延迟推理 FPGA 有优势 |
相关与延伸
域导航:GPU 计算导读;并行模型与 CUDA kernel 见入门后续篇。 交叉:GPU vs FPGA、神经网络入门、nn/ 域。
总结
GPU 起源于游戏渲染:屏幕几百万像素要并行做同一套光照运算,于是芯片把晶体管大量铺成几千个简单计算核心(而非 CPU 那样的大缓存+复杂控制),这种"多而简单"的众核结构靠 SIMT 锁步执行和海量线程切换掩盖访存延迟,在规则、大批量、高算术强度的负载上吞吐碾压 CPU——神经网络训练的核心正是海量规则矩阵乘,GPU(加专用 tensor core)配合成熟的 CUDA 生态因而成为 AI 默认算力;但它单任务延迟高且抖动、喂不饱时利用率低,低延迟/自定义接口场景 FPGA/ASIC 更优。软件上 NVIDIA 用 CUDA(事实标准),AMD 用 ROCm,跨厂商有 OpenCL/SYCL——入门直接学 CUDA,SIMT、kernel、显存层次这些概念跨平台通用。