功耗报告怎么读:从分模块功耗表里把电耗子揪出来
更新时间:2026-09-15。本文是「集成电路大类 · 低功耗设计与验证」入门层系统篇第 10 篇。前 9 篇建立了公式、两笔账和一整套省电手段;但真实工程里,你不会先去推公式,而是先拿到一份工具跑出来的功耗报告。能不能读懂这张表、能不能从里面揪出最该收拾的模块,决定了省电动作有没有打在点上。原理背景见《功耗从哪来》与《功耗分析是什么》,系统地图见低功耗导读。
本文要回答的问题
- 一份功耗报告到底在报什么?internal / switching / leakage 三列各是什么钱?
- 为什么读报告前必须先核对「工况」,不核对会被什么数字骗到?
- 怎么从几万个层次条目中,快速定位最耗电的「热点」?
- 为什么只看一个平均总功耗会漏掉毛刺、瞬态峰值这些真问题?
- 报告里的数又是从哪算出来的(凭什么相信它)?
一、报告的骨架:一张按设计层次展开的账本
回忆《动态功耗 vs 静态功耗》,芯片的电分两种性格:翻转带来的动态电、和通电就有的漏电。功耗工具做的事,就是把这两笔钱按设计层次(design hierarchy)——也就是你 RTL 里一层层 module 实例化出来的树——逐项记账,再逐级汇总。
一份典型的层次化功耗报告,简化后大致长这样(数值为讲解用的示意,单位 mW):
Hierarchy                         Internal   Switching   Leakage    Total    %
-----------------------------------------------------------------------------
  soc                              182.400      96.300     12.500   291.200  100.0
    cpu_cluster                   104.200      58.700      4.100   167.000   57.3
      core0                        41.800      23.400      1.600    66.800   22.9
      core1                        39.900      22.100      1.600    63.600   21.8
      l2_cache                     18.600      10.200      0.700    29.500   10.1
    gpu                            33.500      21.800      2.200    57.500   19.7
    mem_subsys (SRAM)              28.100       8.400      3.900    40.400   13.9
    interconnect/NoC               10.400       5.100      0.800    16.300    5.6
    peripherals                     6.200       2.300      1.500    10.000    3.4
三列动态/漏电项要和公式对上号:
| 报告列 | 对应物理来源 | 典型主导因素 |
|---|---|---|
| Internal(内部功耗) | 单元内部晶体管翻转充放电 + 瞬间上下管同时导通的短路电流 | 单元数量、输入翻转、时钟缓冲器、触发器 |
| Switching(开关功耗) | 单元外部负载电容(走线 + 下游输入脚)充放电,即 P=α·C·V²·f 对外部分 | 负载电容、翻转率 α、电压、频率 |
| Leakage(漏电) | 晶体管关断仍存在的亚阈值/栅极漏电,与翻不翻转无关、通电就有 | 工艺、温度、阈值电压、供电电压(详见后续《漏电与工艺》篇) |
很多工具把 internal + switching 合称 dynamic(动态),与 leakage 分开;还常再出一张分组报告,把电按「时钟网络 / 存储器 / 组合逻辑 / 寄存器 / 毛刺」横切一刀。两张表(按层次纵切、按类别横切)配合看,才能既知道「谁费电」又知道「费的是哪种电」。
二、读报告第一条纪律:先核工况,再看数字
同一个设计,工况不同,报告里的数能差出几倍甚至几十倍。一上来不看条件直接比总功耗,是新手最容易犯的错。读任何一份报告,先在抬头/日志里确认四件事:
- PVT 角与电压:典型角(typical, 常温, 标称电压)还是最坏角?漏电对温度和工艺极敏感,125°C 高温慢角的漏电可能是 25°C 典型角的好几倍;电压按平方进入动态功耗,0.75V 与 0.90V 不是一回事(见《电压与频率》)。
- 频率与工作点(OPP):跑在多少 MHz/GHz?降频档(DVFS)下的数字不能和满频档直接比。
- 激励场景(scenario/vector):满负荷跑分、典型使用、还是 idle/睡眠?激励是否真实直接决定翻转率 α——没给激励或给了不真实的向量,动态功耗是空中楼阁。
- 平均还是瞬态:整段仿真的平均值,还是逐周期波形算出的瞬时功耗?两者回答不同问题(见第四节)。
一个高频陷阱是 test mode(扫描测试模式)漏电虚高:DFT 扫描时为提速常把大量单元切到低阈值、并把平时会关断的电源域全部打开,此时漏电显著高于正常功能模式。拿 test mode 的漏电去对功能模式预算,必然误判。
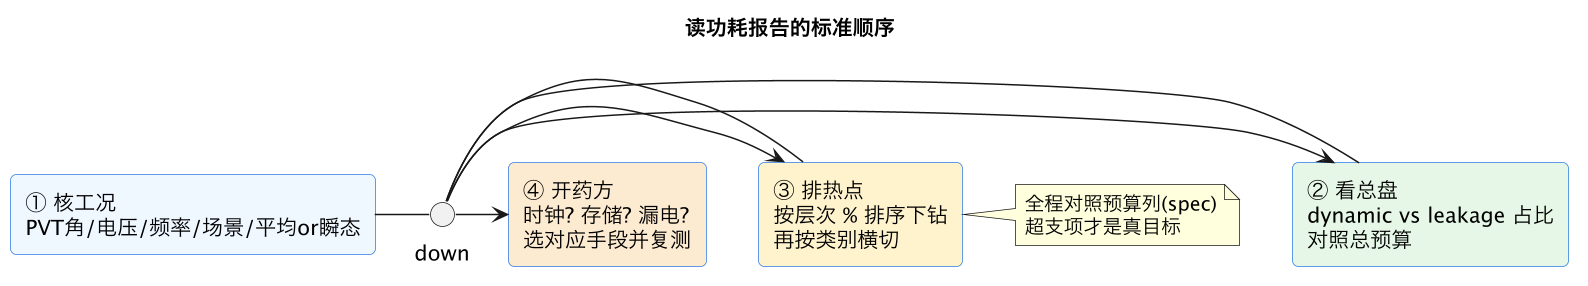
三、排热点:按占比排序,纵切下钻、横切归类
不要平铺地从上到下读,要像查账一样按 % 从大到小抓:
- 纵切下钻:上例里
cpu_cluster占 57.3%,是头号目标;进去看到 core0/core1 各占约 22%、l2_cache 占 10%——于是知道该先收拾两个核,而不是去优化只占 3.4% 的外设。热点的父亲也是热点,沿树往占比最大的分支一路钻到叶子模块。 - 横切归类:对头号模块再问一句「它费的是哪种电」。看分组报告:
- 对照预算列:成熟报告会带一列 spec/budget。绝对值大不等于有问题(CPU 本来就该费电),超过自己预算的模块才是超支项。这正是功耗预算实战思路在报告侧的落点——先有分模块预算,报告才有判定基准(后续功耗预算实战示例篇)。
直觉口诀:总功耗看健康度,占比排序找位置,类别横切定性子,预算列判定超不超支。
四、平均值会骗人:毛刺、瞬态峰值与时间维度
入门最容易踩的第二个坑,是以为「一个平均总功耗」就够了。至少有两类问题会被平均值掩盖:
- 毛刺功耗(glitch / hazard):组合逻辑输入到达有先后,输出稳定前可能在一个周期内来回跳好几次。这些「无效翻转」也在充放电、也耗动态电,但周期一平均就被摊薄藏在 switching/internal 里。门级(带真实延时)的 time-based 分析能反映毛刺,RTL 早期的无延时分析看不到。某数据通路实测动态电明显偏高又解释不通时,单独看 glitch power 分组往往有收获(呼应后续毛刺与无效翻转篇)。
- 瞬态峰值与电流陡度(di/dt):平均 300mW 不代表任何时刻都 300mW。所有大模块同一拍一起翻转、或电源门控唤醒瞬间给保持电容充电,会产生很窄但很高的峰值电流,可能触发本地 IR-Drop(见芯片设计域《功耗与电源完整性》)甚至掉电。这要看 time-based 的逐周期瞬时功耗曲线,也正是 DPA 在验证侧用真实激励刻画的对象(见 DPA 专题)。
所以报告通常分场景各出一份:典型平均对续航/电费预算,高负载瞬态签核峰值与电源完整性,睡眠/深睡对待机电流(电池设备生命线,见动态 vs 静态)。
五、这些数从哪来:报告背后的两个输入
读懂了表,还要知道凭什么信它。工具算每个单元功耗,靠两样东西喂:
- 功耗模型(工艺库
.lib里的功耗表):每种标准单元在不同输入斜率、输出负载下的 internal 功耗与漏电值,由代工厂提供。没这张表,工具不知道一个触发器翻一次耗多少(后续《功耗模型是什么》篇)。 - 翻转率(switching activity):每个信号多久翻一次,来自真实仿真波形 VCD 或其紧凑形式 SAIF;早期没波形时用无向量(vectorless)概率估算兜底,精度差。α 不准,switching 一列就不准(后续《翻转率是什么》篇)。
工具分两大类风格:基于门级网表 + 波形做精确签收的(PrimePower / PrimeTime-PX、Cadence Joules/Voltus 一类),以及 RTL 早期快速估算的(PowerArtist 一类)。入门先掌握报告结构和判读纪律,工具换名字、换列序,账本逻辑是同一套。
六、一个完整的优化闭环长什么样
读报告不是为了「读完」,而是要驱动一次可验证的优化迭代。典型闭环是:读 → 定位 → 下手 → 重读对比。假设首轮报告(仍用前面的示意数字)里 gpu 占 19.7%、且分组报告显示它近六成交在时钟网络与空闲触发器上,说明这块大部分时间无任务却还在跑时钟。于是对 GPU 的各子模块补时钟门控(时钟门控),让空闲子系统停钟。重新跑同一工况、同一 PVT 角、同一激励后,前后报告应这样比:
对比约束(必须三者一致,否则数字不可比):
  同一 PVT 角/电压   同一频率/OPP   同一激励向量与仿真窗口
                        优化前          优化后
  gpu Internal(mW)      33.5     →      24.8
  gpu Switching(mW)     21.8     →      15.2
  gpu Leakage(mW)        2.2     →       2.2   ← 时钟门控不省漏电,符合预期
  gpu Total(mW)         57.5     →      42.2   (−26.6%)
  SoC Total(mW)        291.2     →     275.9
这张对比表能教三件事:① 改动要能在对应列上看到账——时钟门控主要砍 internal/switching、leakage 应基本不动,若 leakage 也大降,多半是工况没对齐或误改了电源连接;② 子模块省的电传到总盘要打折(GPU 省 15.3mW,总盘只降 15.3mW 中未被其他模块活动抵消的部分),别拿子模块降幅当整机降幅;③ 必须同工况复测,换激励、换电压角得到的下降不可信。若优化目标是漏电(比如待机报告超标),则下手点应换成电源门控/HVT,复测时专门看睡眠态 leakage 列。
七、新手常见误读清单
- 拿一个总功耗数到处比:不看 PVT/场景/平均瞬态,把典型角跑分功耗和高温角待机功耗直接比,结论全错。
- 把 test mode 漏电当功能漏电:扫描模式域全开、多用 LVT,漏电虚高,不代表芯片真实睡眠电流。
- 只按绝对值排序、不看预算列:CPU 本来就最费电,绝对值最大不等于最该改;超自己预算的模块才是缺陷。
- 认为平均值能代表峰值:平均达标不代表 IR-Drop/上电涌流安全,瞬态峰值要单独签核。
- 看到 switching 高就去门控时钟:若分组显示高在数据通路组合逻辑和 glitch,时钟门控无效,应查毛刺、操作数隔离、门级使能。
- 早期 vectorless 估算当签收值:无向量概率分析只用于架构期粗筛,落地数字必须用真实 SAIF/VCD 门级分析复核。
- 忽略层次归属与摊派规则:时钟树、宏单元的功耗在不同工具里可能摊到父层或单列,跨工具对比前先看清摊派口径,否则同一物理对象会被记到不同行。
这一篇在知识体系里的位置
- 还没建立两笔账与公式 → 第 01 篇《功耗从哪来》、第 02 篇《动态 vs 静态》;
- 想知道设计侧估算与验证侧实测两条线 → 第 09 篇《功耗分析是什么》;
- 漏电为什么随工艺/温度暴涨、时钟门控为何救不了它 → 第 05 篇《电源门控直觉》 与后续《漏电与工艺》篇;
- 真实激励下的瞬时功耗曲线怎么测 → DPA 动态功耗分析专题、《功耗与电源完整性》。
总结
一句话总结:功耗报告不是一个总功耗数字,而是 EDA 工具按设计层次把每个模块的 internal、switching、leakage 三类逐笔记账再逐级汇总的一张账本,并常配一张按时钟/存储/组合逻辑/毛刺横切的分组表;读它要先核工况(PVT 角、电压、频率/OPP、激励场景、平均还是瞬态,五者任一不同数字都不能直接比,尤其小心高温慢角和 DFT test mode 让漏电虚高),再看动态与漏电总占比对照总预算,然后按百分比从大到小沿层次树纵切下钻到叶子热点、用类别横切判定它费的是时钟、存储、数据翻转还是漏电——时钟高优先时钟门控、SRAM 高想存储休眠、组合翻转高查毛刺与操作数隔离、漏电占比大才动电源门控,并始终对照分模块预算列只收拾超支项而非绝对值最大项;同时平均报告会把组合毛刺摊薄、也反映不出多模块同拍翻转和电源门控唤醒的瞬态峰值电流(那要靠门级 time-based 波形和 DPA 瞬时曲线,关系到 IR-Drop 与掉电),所以典型平均、高负载瞬态、睡眠待机要分场景各出一份;这些数的可信度来自 .lib 单元功耗模型与 SAIF/VCD 真实翻转率两个输入,先用真实激励喂准 α 再谈优化,工具无论 PrimePower 还是 Voltus/PowerArtist 都只是这套账本逻辑的不同皮相,热点判读与「先核工况、再排热点、后开药方」的流程才是要带走的硬功夫。