LEC失败一定代表RTL有bug吗:映射、优化、黑盒三类非bug原因拆解
做数字后端签核的人几乎都遇到过这个场景:综合跑完,Formality 或 Conformal 一比对,报告里躺着几百个 non-equivalent 点,第一反应是「RTL 改坏了?」。先别急着回退代码。LEC(逻辑等价检查,Logic Equivalence Checking)报不等价,真 bug 只是众多可能中的一种。关于 LEC 的基本原理与标准流程,可以先读逻辑等价检查 LEC/Formality,本篇专门回答一个问题:LEC 失败到底是不是 RTL 的锅。
本文要回答的问题
- LEC 报 non-equivalent,真 bug 的占比大概有多少?
- 除 RTL bug 外,哪三类原因最常见、怎么区分?
- 拿到一份失败报告,按什么顺序排查最省时间?
- 哪些「经典误判」会让新人白忙一晚上?
简短结论
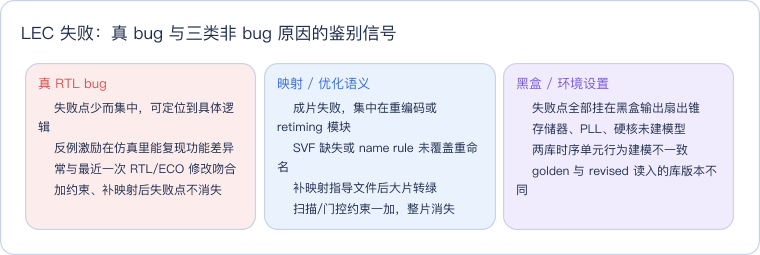
不一定。 LEC 失败 = 「工具没能证明两个设计等价」,而不是「工具证明了两个设计不等价」。这两者的区别正是绝大多数误报的根源。工程经验里,大批量 LEC 失败的案例中,真正由 RTL 功能错误导致的往往只占一小部分,更多是映射没配上、优化语义没告诉工具、黑盒或约束设置有误。真 bug 通常表现为少量、集中、可追溯的失败点;而非 bug 原因常表现为成片、同模式、同区域的失败点。
理由一:关键点映射失败,证明根本没开始
LEC 分两步走:先做 key point 映射(把 golden 侧和 revised 侧的触发器、输出一一配对),再做组合锥等价证明。映射这一步失败,后面的比较直接报 unmatched 或 non-equivalent——但这不是功能不等,只是名字对不上。
最常见的触发场景:
- 综合器做了寄存器重命名、层次打散(flatten)、uniquify,网表里的实例名和 RTL 对不上;
- retiming 把寄存器挪过了组合逻辑边界,一个 RTL 触发器在网表里变成两个;
- 状态机被重编码,
IDLE/RUN/DONE的编码从二进制变成 one-hot,触发器数量都变了。
映射类失败有个鲜明特征:失败点成片出现,且集中在做了重编码或 retiming 的模块。应对办法是打开工具的 name matching 规则、读入综合器输出的映射指导文件(如 Formality 的 SVF、Conformal 的 dofile 指导),让工具知道「这个网表寄存器是从哪个 RTL 寄存器变来的」。SVF 没读或读丢,是映射类失败的第一嫌疑。
理由二:优化语义存在,但工具不知道
综合和版图阶段的很多优化,从「逐比特逐周期」的视角看就是不等价的,必须有额外的约束或建模告诉 LEC 工具「这种差异是合法的」。没告诉,就报失败。典型的几种:
- 扫描链插入:DFT 在触发器前面插了 scan mux,功能模式下 scan_enable 恒为 0 才等价。LEC 时如果没把 test_mode/scan_enable 约束到功能态,工具会认为两条路都活跃,自然不等价。这与 ATPG 与扫描链 是同一枚硬币的两面。
- 时钟门控:RTL 里的
if (en)使能逻辑被综合成 ICG(集成时钟门控单元),数据通路结构变了,需要工具识别门控单元并做对应建模。 - 常数传播与 don't care 优化:综合利用约束(如某些输入恒为定值)优化掉逻辑,LEC 环境没施加同样的约束,就会出现「在约束下等价、无约束下不等价」。
这类失败的判据是:失败点能用「某个模式引脚没约束」解释,且约束一加上,整片失败点同时消失。排查时先数失败点的分布形态,比逐个 debug 快得多。
下面这张对比卡把「真 bug」和三类「非 bug」的信号特征放在一起,拿到报告时先对照判断大方向。
理由三:黑盒与库、环境设置问题
设计里的 SRAM、PLL、SerDes 硬核在 LEC 里通常按黑盒处理。黑盒的输出在两侧被视为「相同输入产生相同输出」的自由点——前提是两侧黑盒的边界一致。一旦边界处理不同,失败就会从黑盒输出的扇出锥里长出来:
- 一侧用了行为级存储器模型、另一侧是空黑盒,或两侧模型时序语义不同;
- 两侧读入的 Liberty/Verilog 仿真库版本不一致,同一个触发器单元的功能描述有细微差别;
- UPF/低功耗意图在单侧生效:isolation、retention 寄存器在功能态本应透明,没约束好就多出一层逻辑。低功耗相关的等价检查要点可对照低功耗设计与 UPF。
还有一个更隐蔽的环境类问题:golden 侧本身取错了。拿综合前的旧版 RTL 当 golden 去比新网表,失败是必然的——这不算 RTL bug,是流程 bug。
一张图看排查顺序
拿到 non-equivalent 报告,推荐的排查顺序是「先环境、再映射、再优化约束、最后才怀疑功能」。原因很朴素:前三类问题的修复是批量生效的,而功能 debug 是逐点进行的,先把批量的排掉,剩下的才是真要啃的。
图里三个蓝色节点是「配置类」排查,红色节点才是「功能类」排查。经验上,大部分报告在前三站就清完了;走到红色节点时,失败点通常只剩个位数,这时用工具生成的反例激励(counterexample)回仿真环境复现,基本就能定位到具体的 RTL 或 ECO 改动。
一个典型例子
某次 DFT 插入后做 RTL-to-DFT 网表比对,报告 1200 个 non-equivalent 点,几乎覆盖全芯片。逐个看第一个失败点的反例,发现差异出现在 scan mux 的 select 上——revised 侧多出来的扫描链路在 LEC 跑的时候没有约束 test_mode。在 setup 阶段加一条约束把测试模式引脚钉到功能态,重跑后失败点从 1200 掉到 3 个。剩下 3 个集中在同一个状态机模块:综合器对这台状态机做了重编码,而 SVF 文件因为综合脚本里一次中间退出没写全。让综合补出完整 SVF 后重跑,全部转绿。
这个例子里,1203 个失败点对应的真实 RTL bug 数量是 0。如果一上来就当成功能问题逐个 debug,以每点半小时计,就是几百个小时的无用功。
常见误区
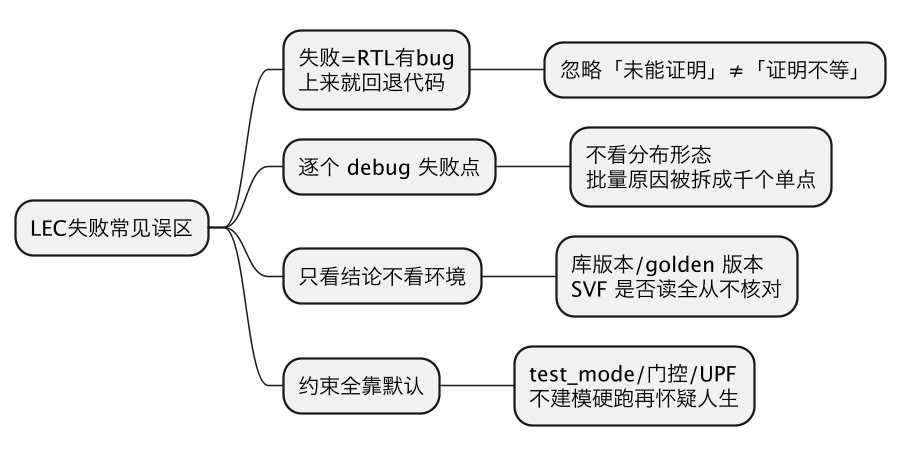
最后把新人最容易踩的坑收成一张脑图,四条分支对应四类惯性思维。
展开说两条最值得记住的:
- 误区一:把 LEC 当仿真用。 仿真报 mismatch 是「测到了一个反例」,LEC 报 non-equivalent 可能只是「证明没走完」。两者的失败语义不同,处置流程也不同。对形式化方法本身不熟的读者,建议先补形式验证入门。
- 误区二:失败点越多越严重。 恰恰相反——上千个同模式失败点几乎必然是配置类问题(一个根因放大出一片),真正危险的是那种「全流程都绿、只有 2 个点顽固不绿」的报告,往往对应着一处真实而隐蔽的功能改动,比如手工 ECO 改错了极性。
这一篇在知识体系里的位置
本篇是 LEC 主题的「排错视角」问答页:原理与标准流程在逻辑等价检查 LEC/Formality,形式化方法的大图景在形式验证入门,与本篇失败原因直接相关的背景知识还有ATPG 与扫描链(扫描约束的来源)、低功耗设计与 UPF(低功耗约束的来源)以及芯片设计全流程(LEC 在流程中各比对点的位置)。读完后建议按「环境→映射→约束→功能」的顺序建立自己项目的 LEC 失败排查清单。
一句话总结
LEC 失败只说明「工具没证出等价」,不等于 RTL 有 bug:先核对库与 golden 版本、补齐映射指导文件、施加扫描/门控/低功耗约束,把成片同模式的配置类失败批量清掉,剩下的少量集中失败点才按真功能问题逐个 debug——失败点的分布形态,比失败点的绝对数量更能告诉你问题在哪。