预加重设计:抽头系数怎么定、摆幅受限下 FIR 均衡怎么做
更新时间:2026-10-04。高速串行链路里,PCB 走线和连接器对信号的衰减随频率升高而急剧加大——28 Gbps 信号的奈奎斯特频率在 14 GHz,一段 30 cm 的普通 FR4 走线在这个频点上能吃掉 15 dB 以上的幅度,眼图在接收端早已闭合。发送端均衡就是把这个趋势提前反向预演一遍:发信号时故意压低低频分量、保留高频分量,让信号穿过信道后自然恢复平坦。这件事在工程上的落地形态就是发送端 FFE(Feed-Forward Equalizer,前馈均衡器),俗称预加重/去加重。本篇是 SerDes 均衡链条的发送端专题:接收端的 CTLE/DFE 与 CDR 协同见 SerDes CDR 与均衡技术,CDR 环路本身见 时钟数据恢复 CDR 原理,本篇只回答发送端这一侧的问题。
本文要回答的问题
- 预加重和去加重是一回事还是两回事,为什么数据手册里两个词混着用?
- 输出摆幅被锁死时,FIR 抽头系数受什么约束,怎么把「想要的高频增益」翻译成具体系数?
- 抽头个数(2 抽头、3 抽头、4 抽头)怎么选,pre-cursor 和 post-cursor 各管什么?
- 系数是拍脑袋定的还是算出来的,标准里的 preset 表是什么逻辑?
- 发送端均衡和接收端均衡怎么分工,单边把均衡拉满为什么往往是坏主意?
一、为什么发送端要「预失真」:信道是低通的
信道的频率响应可以用一个粗糙但有用的模型理解:趋肤效应让损耗正比于频率的平方根,介质损耗让损耗正比于频率,两者叠加后,14 GHz 处的衰减轻轻松松是 1 GHz 处的十倍。对一个 NRZ(Non-Return-to-Zero,不归零码,每个比特周期电平保持不变)数据流来说,频谱能量集中在直流到奈奎斯特频率之间,高频端被信道狠狠砍掉,时域上的表现就是:单个「1」脉冲爬不到满幅度就开始回落,前后比特的拖尾还会叠进当前比特的采样窗——这就是码间干扰(ISI,Inter-Symbol Interference)。
发送端的思路直白得可爱:既然信道要砍高频,那我发的时候就预先把高频抬上去。等信号走完信道,一抬一砍刚好抵消,接收端看到的就是平坦的响应。这就是「预加重」(pre-emphasis)三个字的字面含义——在失真发生之前做加重。
这张图是整篇的骨架:预加重设计的目标不是把发送波形做「好看」——恰恰相反,预失真后的波形在发送端管脚上看起来很丑(低频被压瘪、沿过冲)——而是让接收端的波形好看。评价发送端均衡的唯一考场在链路对端,这也是为什么调预加重必须在接收侧看眼图或者浴盆曲线。
二、预加重与去加重:一枚硬币的两面
数据手册里「pre-emphasis」和「de-emphasis」经常并列出现,容易让人以为是两种技术。实际上它们是同一个 FIR 的两种表述,差别只在参考系。
发送驱动器的输出摆幅是被锁死的:工艺电压、功耗预算、标准规范(比如 PCIe 规定全摆幅约 800 mV 差分)都限制最大输出幅度。想「把高频抬高 6 dB」有两条路:一条路是把跳变沿后的第一个比特真正驱动到更高的电平——但摆幅上限不允许,抬不上去;另一条路是保持跳变后的满摆幅不变,把不跳变的连续比特电平压下去。两条路在频域上产生的高频/低频比例完全一样,只是整体直流电平不同。前者叫预加重(抬高频),后者叫去加重(压低频)。由于摆幅锁死,工程上能做的只有后者,所以真实芯片里实现的几乎全是去加重,规格书里的「6 dB 预加重」实际含义是「连续比特电平比跳变后第一比特低 6 dB」。
看图记住一件事:去加重不是「削弱信号」,而是在摆幅天花板之下重新分配能量。低频被压下去的 6 dB,相对意义就是高频被保留了 6 dB。用 dB 表述时业界有个简洁公式:去加重量 = 20log10(满摆幅 / 去加重后电平),0.5 倍电平对应 6.02 dB,0.63 倍约 4 dB。
三、FIR 抽头:把「想要的频率响应」翻译成系数
去加重电路的通用结构是一个有限冲激响应(FIR,Finite Impulse Response)滤波器:当前比特之外,再把前后若干比特各自乘一个小系数、叠加进输出。三抽头 FFE 的输出写作:
y[n] = c(-1)·x[n+1] + c(0)·x[n] + c(1)·x[n-1]其中 c(0) 是主抽头(main cursor),c(-1) 是前导抽头(pre-cursor),c(1) 是后随抽头(post-cursor)。摆幅约束体现在一条铁律上:所有抽头绝对值之和等于 1(归一化到满摆幅),因为最坏情况下所有比特同号叠加,输出不能越过驱动器天花板。这条约束是预加重设计和教科书 FIR 设计的最大区别——系数不是自由变量,而是一个固定预算的分配问题。

电路实现上,每个抽头就是一组并联的差分对,尾电流正比于抽头系数绝对值,输入接对应延迟后的比特,极性由系数符号决定,各组输出电流直接短接相加。所以「调系数」在硅片上是「调 DAC 控制的尾电流比例」,归一化约束对应「总尾电流恒定」——功耗不随系数配置变化,这是电流模式 FIR 的天然红利。
归一化怎么落到具体数字,看一个例子:目标 6 dB 去加重、只用 main+post 两抽头。6 dB 要求连续比特电平是满摆幅的一半,也就是 c(0)-|c(1)| = 0.5,同时约束 c(0)+|c(1)| = 1,解出来 c(0)=0.75、c(1)=-0.25。验证一下:连续「1」序列输出 0.75-0.25=0.5,跳变沿后第一个比特输出 0.75+0.25=1.0,两者之比 0.5,正好是 6.02 dB。同理 3.5 dB 对应 c(1)≈-0.2,9.5 dB 对应 c(1)≈-0.33。工程数据手册里的去加重档位表,本质就是这组线性方程的离散化解。
三个抽头各管什么,用信道响应的反函数来理解最清楚:
- post-cursor c(1):抵消主光标之后的 ISI 拖尾,是补偿信道高频损耗的主力,几乎总是负系数、绝对值最大。6 dB 去加重基本就是 c(0)+c(1)=0.85、c(1)=-0.3 这一族配置(归一化后)。
- pre-cursor c(-1):抵消主光标之前的 ISI(前导拖尾),主要由封装反射、连接器阻抗突变引起,数值通常比 post-cursor 小,但在背板长链路里不可省。
- main cursor c(0):永远是正的,剩下的预算全给它,它决定信号的「直流底座」。
| 抽头配置 | 典型应用 | 能补偿的 ISI | 代价 |
|---|---|---|---|
| 2 抽头(main+post) | 短走线、<10 Gbps | 后沿拖尾一阶项 | 实现最简,无 pre-cursor 能力 |
| 3 抽头(pre+main+post) | PCIe Gen3/4、主流背板 | 前后各一阶 | 业界默认甜点 |
| 4 抽头及以上 | 长背板、56G/112G PAM4 | 更长拖尾 | 系数搜索空间爆炸,收益递减 |
四、系数怎么定:从信道测量到 preset 表
系数不是猜的。理论路径很直接:测出或仿真出信道的脉冲响应 h(t),求它在目标频带内的「逆」,再截断到 FIR 抽头数能表达的长度,归一化满足摆幅约束。常用的准则有两个:迫零(ZF,Zero-Forcing)让主光标前后采样点的 ISI 严格为零,但会把噪声一并放大;最小均方误差(MMSE,Minimum Mean Square Error)在「残余 ISI」和「噪声放大」之间取最优折中,工程上几乎总是选 MMSE 或其变体。手里有信道 S 参数时,MATLAB 或 Python 十几行代码就能算出一组候选系数。
但现场更常见的做法是扫参:链路训练或直接穷举,在接收端用误码率/眼图面积当裁判,从粗到细遍历系数组合。PCIe 干脆把这个搜索空间标准化成 preset 表:Gen3 定义了 P0~P10 共 11 组固定的(pre-cursor, post-cursor)组合,训练阶段收发双方按协议逐组尝试,接收方用电压/时序裕量反馈选出最优一组,连系数协商的信道都省了。这张表的设计逻辑值得玩味:它不是系数的均匀采样,而是按「去加重量 × pre-cursor 量」的二维网格铺点,P4 附近是不带 pre-cursor 的纯去加重家族,P7/P8 附近是高 pre-cursor 区,覆盖了从短走线到长背板的典型信道形态。协议还规定了两条不变量检查——任何合法系数组合都要满足摆幅约束(|c(-1)|+|c(0)|+|c(1)|=1)和最小提升比,防止对端配置出一个「看起来合法但物理上没意义」的抽头组合。
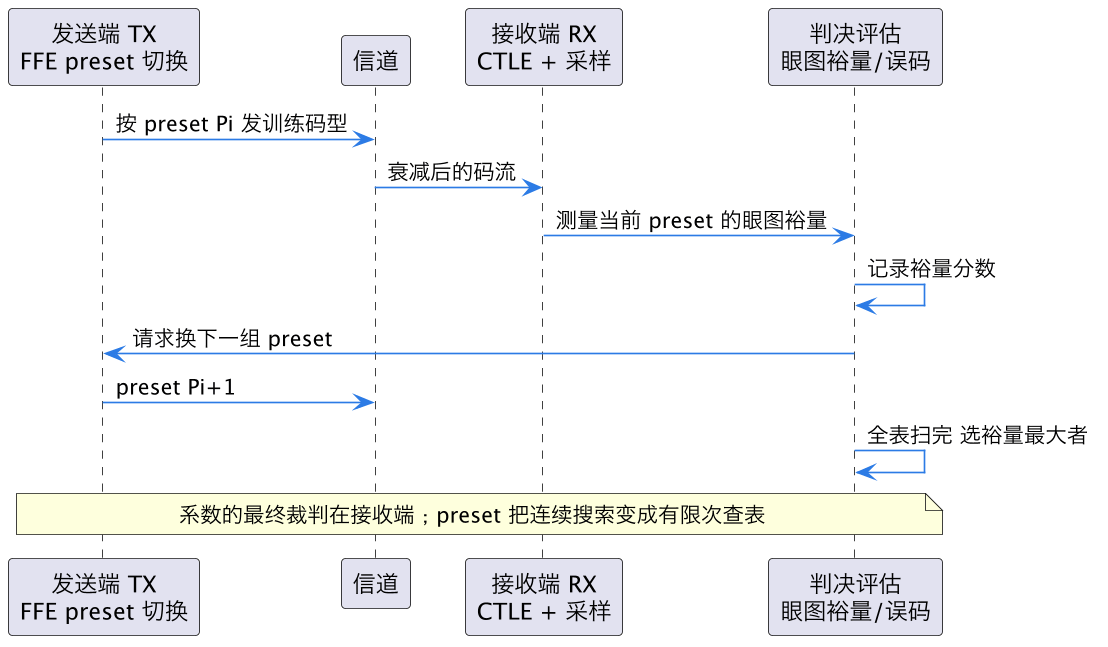
这张图值得细看的是「裁判位置」:系数的优劣只在接收端可判,发送端自己是瞎的。所以一切发送端均衡调试都必须建立「接收端能看到什么」的反馈通道——可能是协议内建的训练握手,也可能是实验室里示波器/误码仪的人工读数。没有反馈通道的链路,只能靠信道建模预计算系数,精度天花板低得多。
实验室调参还有一个实用顺序:先固定 RX 均衡在中档,扫 TX preset 找到粗最优;再固定 TX,细扫 RX CTLE 档位;最后回头微调 TX 一到两档确认没有更优邻居。这个「坐标轮换」两三轮就收敛,比全网格穷举省一个数量级的时间,结果通常只差半个档位。
五、与接收端均衡的协同:别把预算在一端花光
发送端 FFE 不是唯一的均衡手段,接收端还有 CTLE(Continuous-Time Linear Equalizer,连续时间线性均衡器,一个高频提升的模拟滤波器)和 DFE(Decision Feedback Equalizer,判决反馈均衡器,用已判决比特减掉拖尾)。三者的分工逻辑是:
- TX FFE 的优势是「在信号还干净的时候动手」,不放大噪声(它处理的是理想数字比特);劣势是摆幅约束把均衡总量锁死了——去加重压低频的同时也在压信噪比,压 12 dB 去加重意味着低频信号到达接收端时先亏了 12 dB。
- RX CTLE 不损耗摆幅预算,但它对高频的提升会连噪声一起放大。
- RX DFE 只消 ISI 不放大噪声,能力上限最高,但它无法处理 pre-cursor ISI,且存在错误传播风险。
经验法则由此而来:发送端负责粗调和 pre-cursor,接收端负责细调和长拖尾。一个常见的翻车场景是发送端把去加重拉满到 9 dB 以上——低频分量被压得穿过信道后已经逼近接收机灵敏度,CTLE 再抬高频时噪声底跟着起来,眼图反而更差。协同设计的正确姿势是联合扫描:TX preset 与 RX CTLE 档位构成二维网格,用接收端裕量做评价函数找全局最优,而不是各自拉满。这也是 SerDes CDR 与均衡技术 里强调的「均衡是链路边际预算问题」在发送端的投影。数据率再往上走到 PAM4(四电平脉冲幅度调制),每个眼高只剩 NRZ 的三分之一,TX FFE 的抽头分辨率还得跟着细化,112G 世代的 PHY 普遍提供 4~7 个抽头、每个抽头 6~7 bit 的编程粒度,代价是系数搜索不得不交给片上的自适应算法。
这一篇在知识体系里的位置
- 上游:SerDes 与 8b/10b 编码 解释数据流的频谱与游程特性,片上信号完整性 提供信道损耗与反射的物理背景,VCO 拓扑:环振与 LC 覆盖发送时钟源的选择。
- 横向:SerDes CDR 与均衡技术 从接收端视角讲 CTLE/DFE 与 CDR 的协同,与本篇构成均衡问题的两面;时钟数据恢复 CDR 原理 解释采样点为什么必须由均衡后的眼图中心决定。
- 下游:PLL 抖动与相位噪声积分 给链路预算里的抖动项定量语言;发送端均衡调好后的最终验收,仍然落在抖动容限与误码率模板上。
总结
预加重设计的本质是摆幅天花板下的能量再分配:受「抽头绝对值之和等于 1」约束,发送端用 2~4 抽头的 FIR 把低频分量压下去(所以真实实现都是去加重),让信号穿过低通信道后恢复平坦;抽头系数由信道脉冲响应经 MMSE 准则求解或按协议 preset 表扫描确定,优劣的唯一裁判在接收端眼图;工程上发送端负责粗调与 pre-cursor,CTLE 与 DFE 负责细调与长拖尾,单边拉满只会同时压垮信噪比,联合寻优才是正解。