FIFO FWFT 与标准读模式:0 拍与 1 拍读延迟的接口差异和队头旁路实现
专题导航:异步FIFO设计全景。前置要求:已读支柱页与FIFO 指针绕回与扩展位,知道读写指针如何寻址队头、满空如何判定。 上一篇:FIFO 指针绕回与扩展位 | 下一篇:almost 阈值与提前量设计。 读序说明:本篇讨论读接口本身的时序约定,与跨时钟域机制正交——同步 FIFO、异步 FIFO 都有标准/FWFT 两种读法。配套实验在工程包 derekzhuo/async-fifo-mini 的
tb/tb_fwft_vs_standard.v。
本文要回答的问题
- 标准读模式下,拉高读使能后数据为什么要等一拍才出现?这一拍花在哪段路径上?
- FIFO FWFT 模式把队头直接摆在输出端,读使能的语义变成了什么?
- 「空时写入直送输出、非空时 RAM 读出保持、弹出后切下一个地址」的队头旁路 mux 在硬件上怎么搭?
- 同拍读和写、且 FIFO 里只剩一个数据时,两种模式各自发生什么?
- Xilinx FIFO IP 为什么默认 FWFT?什么场景又必须死守标准模式?两种模式能否互相改造?
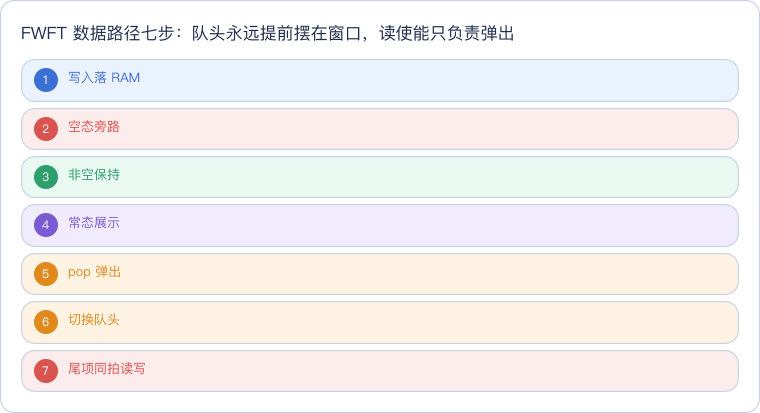
这张流程卡是全文的主干:标准模式是「请求—寻址—读出—打拍」的四拍段动作,FWFT 把其中前三步提前到了数据入队的时刻,读者到窗口前时第一份菜已经摆好,读使能从「取餐口令」降级为「吃完收走」。下面先拆标准模式那一拍的来历,再看旁路结构怎么把它消掉。
一、标准读模式:读延迟的一拍花在 address→memory→register 上
标准模式(standard read,也叫 normal mode)的读口是一块规规矩矩的同步读 RAM 加一级输出寄存器。读者在某个时钟沿拉高 rd_en,沿上读指针 rptr 的值成为读地址;存储体在这一拍内完成译码和位线读出,数据出现在内存的输出端;但这个值是组合逻辑产物,有毛刺、有时序不确定,不能直接交给下游,于是再经过一级寄存器,在下一个时钟沿才进入 rd_data,同时 valid 拉起一拍。
整条路径写出来就是 address → memory → register 三段:地址寄存器送出地址是第 0 段,RAM 内部阵列读出占用第 1 段(这一拍结束前数据稳定在内存输出),输出寄存是第 2 段(下一个沿之后 rd_data 才有效)。所以从读者的视角记账:在第 N 个沿提出读请求,下游在第 N+1 个沿才能采到数据,读延迟固定 1 个周期。这与异步FIFO 满空信号里那三拍保守欠账完全是两回事——那一拍是同步 RAM 的结构性延迟,时钟多快都赖不掉,除非动结构。
读这张波形抓住三级接力:rd_en 在第一个沿被采样,同一沿 raddr 稳定为 N;第二个周期内 RAM 把槽位 N 的数据 A 放到组合输出,但它还不是接口信号;第二个沿上输出寄存器锁存 A,第三个周期 rd_data=A、valid=1,下游正好在这个沿采走。连续读时这条流水线可以每拍吐出一个数据(请求背靠背、valid 背靠背),但第一个数据永远迟到一拍,空 FIFO 更不会主动给你任何东西——rd_data 在没有请求时是无意义的旧值。
二、FWFT:把队头提前摆上窗口,读使能变成 pop
FWFT(First-Word Fall-Through,首字直通)改的是同一件事的时序约定:只要 FIFO 非空,队头数据就直接呈现在 rd_data 上,读者不需要先提读请求;rd_en 不再表示「请把下一个数据给我」,而是表示「窗口这份我收走了,弹出(pop),换下一份」。于是读延迟的定义被抽空——数据在你举手之前已经在总线上,从「决定读」到「拿到数据」是 0 拍。
这个魔法的全部成本在 FIFO 内部:标准模式的输出寄存器被拆掉(或者说被旁路网络取代),取而代之的是一个队头旁路 mux 和它的选择逻辑。
读这张图盯住红色 mux 的两个输入:一路是 RAM 读口的正常队头,一路是写入数据的直送支路,选择信号由占用计数与同拍读写条件给出。它实际要覆盖三种情形,每种都对应流程卡里的一步:
- 空态写入:
count==0的拍发生写,数据若先落 RAM 再绕回读口,最早下一拍才看得到;FWFT 要求「首字坠落即穿透」,这一拍直接让wdata经旁路支路驱动rd_data,写入沿之后(最强的实现里是当拍)队头已在窗口。 - 非空稳态:FIFO 里有货,mux 切到 RAM 读口,
mem[raddr]组合输出并保持,没人 pop 它就一直摆在那里——所以 FWFT 的rd_data在空闲时是有意义的当前队头,与标准模式的旧值完全不同。 - pop 之后:弹出沿让
rptr加 1,mux 的 RAM 支路换一个地址取数,新队头在下一沿后呈现;若弹出的同时还写着、且这是最后一个数据,走第三种特殊情形——下文第四节实测。
紫色的计数/比较逻辑是这套结构真正的额外复杂度来源:它要在空、非空、尾项同拍读写之间及时给出 mux 选择,valid 直接由非空条件组合导出,empty 也随之提前撤销。
三、同激励双变体对照:标准模式欠一拍,FWFT 队头提前五拍就位
道理讲到这里,上实验。testbench 例化同一个可参数化行为模型 fifo_model,只改一个参数:FWFT=0 与 FWFT=1,两个实例喂完全相同的激励——复位后依次写入 A/B/C,空闲两拍,再连续读三次,时钟 10ns、深度 8。监控器每个时钟沿后逐拍打印两个实例的 empty/rd_data/valid/occ,并内置软件期望逐拍核对。
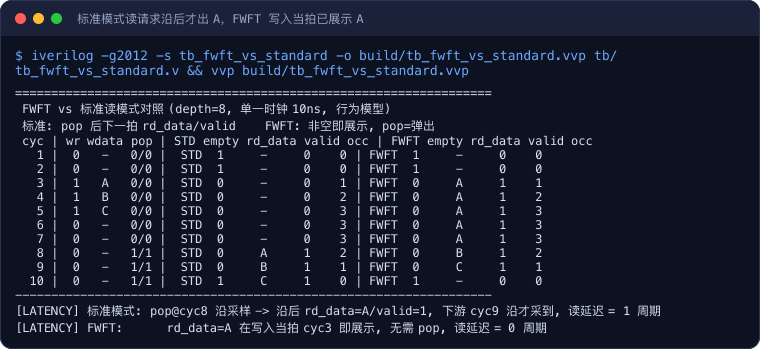
终端卡的逐行对照把两个模式的性格差异全部摊开了。看 FWFT 那一列:cyc3 写入 A 的同一拍(旁路支路生效),empty 已撤、rd_data=A、valid=1;此后 cyc4~cyc7 无论有没有人读,A 一直摆在窗口。标准模式同一时段 rd_data 是横线、valid=0,即使 cyc4 起 FIFO 明明非空——它不知道你要不要读,也不主动展示。读请求在 cyc8 采样后,标准模式沿后才吐出 A(下游要到 cyc9 沿才采得到,欠 1 拍),FWFT 同一沿只是把 A 撤下、换成 B。到 cyc10,FWFT 已 empty=1,标准模式却还亮着最后一个 valid=C——这个差别在对接 DMA 时很关键:FWFT 的空与「窗口无数据」严格同刻,标准模式的最后一个数据有效拖在空之后一拍。
把两种读法的读相画成波形,差别就是「先给后取」与「先取后给」:
读这张波形只看两条数据线的相位:FWFT 的 A 在第一个 pop 之前已经稳定了若干拍,pop 脉冲只是让输出在沿后从 A 滑到 B;标准模式的数据线在请求之后才有内容,而且整体右移一拍。两条线的相位差,就是选型时要付的时间账。
两种模式的接口行为逐项对比如下,表中每一行都能在终端卡里找到对应的拍:
| 对照项 | 标准读模式 | FWFT 模式 |
|---|---|---|
| 读使能语义 | 请求读出下一个数据 | pop:弹出已展示的队头 |
| 首个数据读延迟 | 1 个周期(请求沿后寄存输出) | 0 周期(非空即在 rd_data) |
| rd_data 空闲时含义 | 无意义旧值,valid 恒 0 | 当前队头,只要非空就有效 |
| valid/empty 有效时刻 | valid 滞后请求一拍;读空后 valid 还拖最后一拍 | valid 即非空;empty 与窗口无数据同刻 |
| 空态写入后何时看到 | 仍需再发一次读请求,再等一拍 | 写入沿后(本模型当拍旁路)即呈现 |
| 同拍连续读 | 可背靠背,流水线每拍一个 | 可背靠背,每拍弹出并切换队头 |
| 输出路径结构 | RAM + 输出寄存器,全寄存 | RAM/旁路 mux 组合直出,无输出寄存 |
| almost-empty 行为 | 与占用计数同口径,标志与数据互不遮挡 | 标志须按「弹出后」语义理解,阈值 1 即等价于「窗口只剩当前这份」 |
四、边界用例:只剩一项时 pop 与 write 同拍
FWFT 最容易写错的不是主路径,而是这个角:FIFO 里只剩一个数据 D,读者在同一拍既弹出 D、写者又写入 E。标准模式里这只是普通的同拍读写,存储指针各自前进,E 以后按正常请求再读。FWFT 要回答一个刁钻的问题——**这个沿之后,窗口里应该是什么?**答案是 E:D 在弹出之前已经摆在窗口供人采过,新数据沿 fall-through 支路直接落到输出,占用数仍为 1,数据流不断流。实验的第三个实例专门验证这条路径:
[2] 边界用例 FWFT: FIFO 仅剩 1 项 D, pop 与 write(E) 同拍
  写入 D 后:      rd_data=D valid=1 empty=0 occ=1 (未发 pop, 队头已展示)
  空闲保持一拍:   rd_data=D valid=1 (FWFT 输出保持队头)
  pop+write 同拍: rd_data=E valid=1 empty=0 occ=1 (新数据 E fall-through 到输出)
  再 pop E 之后:  rd_data=- valid=0 empty=1 occ=0
SUMMARY 边界用例: 同拍 pop+write 旁路正确, D 先展示后被弹出, CHECK 失败 = 0
行为模型里这对应旁路 mux 的第二个选择条件:count==1 && pop && wr 时 mux 选 wdata 而非旧的 mem[raddr]。少了这条支路,这一拍窗口会闪空(glitch 到 empty)或读出刚被弹出的旧槽位,下游若按 valid 连续取数就会漏一个 beat。Xilinx FIFO Generator 的 FWFT 模式在文档里明确承诺这一语义,自研行为模型时这个角必须有独立用例压测。顺带一提,占用计数的更新是「加一减一抵消」,判满逻辑也要放行这种情况:满 FIFO 同拍一写一读在 FWFT 下必须允许写入,否则白白丢一个周期的写带宽。
五、设计与思考:什么时候要 FWFT,什么时候死守标准模式
选型先问读者是谁。FWFT 的生态位是读侧逻辑简单、不愿意或不能为取数付一拍的场合:CPU 总线从 FIFO 读数据时,一次地址访问周期里就要拿到内容,标准模式那 1 拍读延迟会逼总线插等待态;简单 DMA、状态机每拍直接消费 rd_data 的流式接口、UART/网络报文缓冲的首字节解析,都属于「窗口前必须有一份」。这也是 Xilinx FIFO IP 把 FWFT 设为默认读模式的原因——块 RAM 本身就是同步读、1 拍延迟,IP 在内部补上旁路逻辑后,绝大多数用户面对的是零延迟读口,接到 AXI-Stream 这类 valid/ready 接口时 valid 直接等价于非空,省掉一个「先发 rd_en 再等 valid」的微型状态机。
标准模式的生态位正好相反:高频、时序紧、输出必须打拍的设计。FWFT 的组合输出路径是 RAM 读出 → mux → rd_data → 下游建立时间,RAM 位线读出本来就慢,再串一个 mux 和计数选择逻辑,读口最高频率显著低于带输出寄存器的标准模式;组合直出还意味着每一次 pop 都让 RAM 读地址翻转、整块列被预充放电,无法用时钟门控关断读口,功耗更高。工艺越先进、频率越高,这两笔账越明显。自研 FIFO 时还要算面积:旁路 mux 位宽等于数据位宽,计数选择与满判定同拍放行逻辑也不便宜。
| 选型场景 | 推荐模式 | 理由 |
|---|---|---|
| CPU/本地总线直接挂 FIFO 读 | FWFT | 访问当拍取数,避免总线等待态 |
| AXI-Stream 等 valid/ready 流式接口 | FWFT | valid 即非空,省预取状态机 |
| 简单 DMA、报文首字节解析 | FWFT | 零延迟拿到队头,控制逻辑直白 |
| 高频数据通路、收敛时序 | 标准 | 输出寄存器切断 RAM 后组合路径,fmax 高 |
| 低功耗、偶发访问的深 FIFO | 标准 | 不 pop 不翻读地址,可门控读口 |
| 读侧已有一级接收寄存器、可重 timing | 两者皆可 | 见下方两种等价改造 |
真正有意思的是:两种模式可以互相改造,而且改造后时序严格等价。第一种,FWFT 外加一级寄存器——在 rd_data 后面串一个接收寄存器,用 ready(或读使能)做移位使能。表面看读延迟又回到了 1 拍,但因为 FWFT 的队头是提前摆好的,这一级寄存器的输入永远稳定,它可以放进轻松的时序周期,反而修掉了 FWFT 组合路径的 fmax 问题;AXI-Stream 的从端带 skid buffer 时就是这种形态。第二种,标准模式加预取读——复位后只要非空就自动发一次内部读请求,把首字取进保持寄存器,读者看到的也是「非空即有数据」,之后每次取走再自动预取下一个。这就是 Xilinx IP 内部把同步块 RAM 包装成 FWFT 的标准手法:一块 1 拍延迟的标准 RAM,加预取保持寄存器和空态旁路,对外呈现 0 延迟。两种改造的判据相同——寄存器这一拍放在 FIFO 里面还是外面:放在里面并加旁路就是 FWFT IP,放在外面由读侧自己收就是标准模式加 skid,系统级延迟和时序预算完全一致,区别只是模块边界划在哪。
代码获取:实验平台在独立公开仓库 derekzhuo/async-fifo-mini 的 tb 目录,本篇对应文件为 tb_fwft_vs_standard.v(自包含行为模型双变体 + 边界用例,不依赖 rtl 目录)。克隆后执行 iverilog -g2012 -s tb_fwft_vs_standard -o build/x.vvp tb/tb_fwft_vs_standard.v && vvp build/x.vvp 即可复现本文全部输出,本机需安装 Icarus Verilog。
实验环境
- 机器/系统:Mac(Intel)/ macOS,本机原生执行(未使用容器)
- 工具版本:Icarus Verilog 13.0(stable)
- 日期:2026-11-03
- 完整命令:
iverilog -g2012 -s tb_fwft_vs_standard -o build/tb_fwft_vs_standard.vvp tb/tb_fwft_vs_standard.v && vvp build/tb_fwft_vs_standard.vvp - 原始记录:本文终端卡与日志摘录覆盖 run1.log 全部 27 行仿真输出,实验源码见上述工程包
这一篇在知识体系里的位置
本篇是异步FIFO 专题原理段第五篇,回答读接口的时序约定问题,与前面四篇的跨时钟域主线正交:格雷码跨时钟域原理解决指针怎么跨域,异步FIFO 满空信号解决标志往哪个方向保守,FIFO 指针绕回与扩展位解决满空状态空间,本篇解决「数据以什么时序交到读手上」——FWFT 内部的旁路与预取同样建立在这些指针和占用计数之上。支柱页异步FIFO设计全景给出整体工程取舍,完整可综合实现照抄异步 FIFO Verilog 模板。下一篇 almost 阈值与提前量设计回答 FWFT 表格里留下的问题:almost-empty 阈值在弹出语义下应该怎么数。
总结
标准读模式的 1 拍读延迟是同步 RAM「address→memory→register」路径的结构性产物,读使能是取数请求,数据下一拍才进输出寄存器;FIFO FWFT 用队头旁路 mux 把取数提前到入队时刻,非空时队头组合直出 rd_data、valid 即非空,读使能退化为 pop,读延迟为 0。双变体同激励仿真逐拍坐实:标准模式 cyc8 的请求沿后才出 A,FWFT 在写入当拍 cyc3 就把 A 摆上窗口并一直保持;仅剩一项同拍 pop+write 时新数据经 fall-through 支路当拍接替、占用数不变。选型上接 CPU 总线、valid/ready 流式接口和简单 DMA 选 FWFT(也是 Xilinx IP 的默认),追频率、重功耗与输出打拍选标准模式;FWFT 外加接收寄存器与标准模式加预取逻辑系统级等价,差别只是那一级寄存器划在模块边界哪一侧。