仿真回归多久跑一次合理:提交级、夜间级、发布级三档怎么分
这是验证团队最常纠结的资源问题之一:回归跑得太勤,仿真 license 和机器被占满,工程师等结果等到下班;跑得太稀,Bug 在主干上潜伏一周才暴露,二分定位成本翻倍。本文给出按「反馈周期 × 资源成本」分三档的答案,与 回归管理方法论 一脉相承,那一篇讲回归体系怎么搭,本篇只回答「多久跑一次」这一个点。
本文要回答的问题
- 仿真回归到底该多久跑一次,有没有公认答案?
- 提交级、夜间级、发布级三档各自跑什么、跑多久?
- 为什么不能所有用例都堆到一次回归里跑?
- 常见误区有哪些?
简短结论
没有单一的「合理频率」,合理的是分层:每次提交(push / merge request)前跑一个 5–15 分钟的冒烟回归;每天夜里跑全量回归(所有用例 + 多随机种子);里程碑/发布前在夜间回归基础上加跑门级仿真、形式验证、覆盖率收口的发布级回归。三档的判据只有一个:这档回归的反馈周期,是否匹配它要拦截的错误的「存活成本」。
为什么是这三档
理由一:Bug 存活越久,定位越贵
一个随机种子打出来的失败,如果在提交后 10 分钟内报出来,提交人还坐在工位上、上下文热着,看日志十分钟就能定位;如果潜伏到一周后夜间回归才挂,期间主干上叠了几十个提交,就要靠二分 + 回归失败分箱 去追,一次定位可能就是半天。冒烟回归的全部意义就是把「常见愚蠢错误」(编译挂、连线接错、基本功能挂)的存活时间压到分钟级。
理由二:算力和 license 是硬约束
全量回归几千条用例 × 十几个种子,一晚就能把几十核的 LSF 计算网格 和全部仿真 license 占满。如果这套东西每次提交都跑一遍,白天谁也别想调试。所以必须按「用例的性价比」分层:冒烟只放最快、最能拦住主干崩溃的 5%–10% 用例;全量留到夜里机器空闲时跑。
理由三:不同错误的暴露概率不同
连线接反、寄存器地址写错这类错误,跑任何一条用例都会挂,冒烟即可拦截;而跨模块时序竞争、极端随机配置下的 corner case,只有大量种子反复打才有概率暴露,天然属于夜间全量;X 传播、门级时序违例这类问题,RTL 仿真根本看不见,只能等发布级的门仿和形式验证收口。频率分档本质上是「错误类型」分档。
理由四:反馈周期决定开发节奏
工程师能接受的工作循环是「改代码 → 几分钟内知道没把主干弄挂 → 合入」。如果提交前检查要跑两小时,大家就会攒一周改动再一次提交,合并冲突和大爆炸式集成随之而来——这是 CI 领域反复验证过的结论,芯片验证同样适用。冒烟回归的时长上限不是技术问题,是「人愿不愿意等」的问题,经验值是 15 分钟封顶。
下面这张对比卡把三档的目标、内容、时长和算力摆在一起。
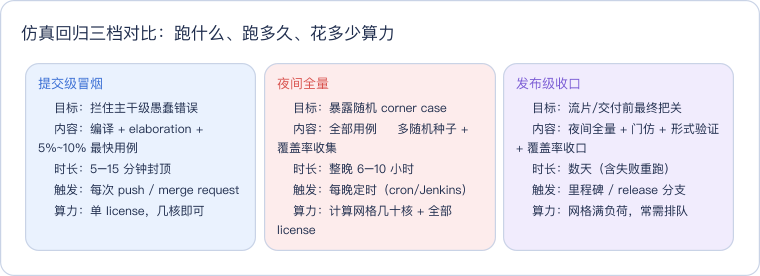
读这张卡抓住一条主线:从提交级到发布级,反馈周期从分钟级拉到数天,换来的是错误覆盖面的逐级放大。三档是互补关系,砍掉任何一档都会在另一头付出代价——没有冒烟,主干天天挂;没有夜间全量,随机 Bug 攒到发布级集中爆;没有发布级,门级和 X 传播问题直接带上硅。
三档怎么串成一条流水线
三档不是三个孤立任务,而是一条逐级放行的漏斗:提交必须先过冒烟才能合入主干;主干每晚自动跑全量,第二天早上 回归分诊 处理失败;到了里程碑,以最近一次全绿的夜间回归为基线,叠加发布级项目收口。下面这张分层图画出这条链路里每一档拦住什么、漏给下一档什么。
图中值得注意的一点:每一档的「拦住」清单互不重叠,这正是分档省算力的根源——冒烟从不试图替代夜间回归去找随机 Bug,夜间回归也不跑门仿。如果哪一档的职责边界模糊了(比如有人往冒烟里塞两小时的长用例),整套流水线的反馈速度就会被拖垮。
一个具体的例子
一个 30 人左右的 SoC 验证团队的典型配置:冒烟套件固定 80 条用例(全部从 冒烟测试 bring-up 策略 筛过,单条不超过 3 分钟),跑在 CI 服务器上,merge request 不过冒烟直接拒收;夜间回归 2400 条用例 × 8 个种子,晚 10 点从 Jenkins 触发,早上 8 点出报告,失败的先走自动分箱再人工分诊;每两个月一个里程碑,发布级在夜间基线上加门级仿真和形式验证,覆盖率没收到 95% 不放行。这套配置下,主干在白天几乎不挂,随机 Bug 平均存活时间小于 24 小时,发布前两周开始集中消化覆盖率空洞——节奏是可持续的。
常见误区
- 误区一:每次提交都跑全量。 看似最保险,实际白天 license 被 CI 抢光、提交排队两小时起步,工程师绕开 CI 直接合主干,防线形同虚设。全量的正确位置是夜里。
- 误区二:只有夜间回归,没有冒烟。 编译错误都要等一晚才知道,白天合进去十个提交、夜里挂一片,早上分不清是谁引入的。
- 误区三:冒烟套件只增不减。 每修一个 Bug 就往冒烟里加一条回归用例,半年后冒烟跑两小时,退化成「提交级全量」。冒烟必须定期体检,单条超时或拦不住新错误的用例要降级回夜间套件。
- 误区四:把「频率」当成唯一调节手段。 回归跑不动时先想到「少跑几次」,其实该先做的是用例分级、随机种子剪枝、网格扩容——频率分档是最后一道阀门,不是第一道。
- 误区五:发布级回归临时抱佛脚。 覆盖率收口、门仿问题在里程碑前两周才第一次跑,发现问题来不及改。发布级项目里能提前跑的(形式验证、覆盖率收集)应该并入夜间回归持续滚动。
延伸阅读
- 回归管理方法论:回归体系怎么搭,本篇的三档频率是其中的一个旋钮。
- 回归失败分箱:夜间全量挂了几百条,怎么快速归类定位。
- 回归分诊:每天早上处理夜间回归报告的标准流程。
- LSF 计算网格上的回归:夜间全量占用算力资源的调度细节。
- 冒烟测试 bring-up 策略:冒烟套件的用例怎么筛。
一句话总结
仿真回归没有单一的「合理频率」,合理的做法是把回归按反馈周期与算力成本分成三档——提交前跑 5–15 分钟的冒烟拦截主干级错误、夜间跑全量多种子暴露随机 corner case、发布前叠加门仿与形式验证收口——三档各司其职、逐级放行,Bug 存活时间被压到最短,算力花在性价比最高的地方。