FPGA 原型验证专题 10:RTL ID 体系——ID 分配规则、层次路径绑定、稳定性与增量编译漂移
更新时间:2026-09-12。本文是「ASIC FPGA 原型验证系统」专题 06~25 深体系列分册,对应阶段 1(Elaboration 之后分配 RTL ID)。总览见 06 原型验证系统全景与文档地图,链路速览见 04 ASIC 原型验证全链路 RTL ID/GateID/层次映射,ID 在下游如何与 GateID 对接见 16 GateID 与逻辑网表模型 cell/net/ID 分配 与 17 info_table 映射表 GateID↔RTLID/回溯/版本。
这一篇在链路里的位置
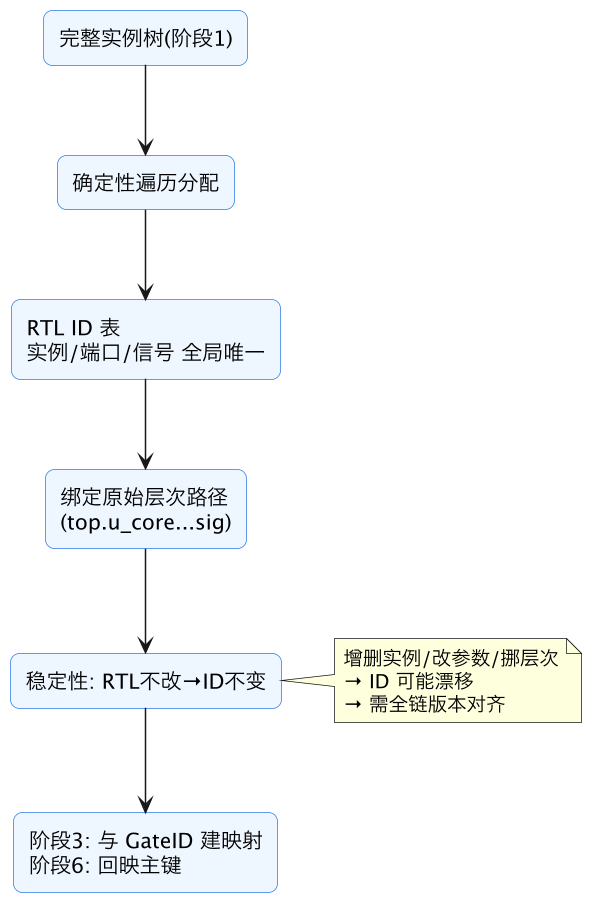
阶段 1 展开得到实例树后,编译器遍历整树分配 RTL ID。此阶段只有 RTL ID、没有 GateID。RTL ID 一旦分配,在"原始 RTL 不修改"的前提下跨后续所有阶段、跨多次构建保持固定;它是阶段 3 建立 GateID↔RTL ID、阶段 6 回映到 RTL 层次的主键。
本文要回答的问题
- 为什么不能直接用层次字符串当 ID,还要再分配一个 ID?字符串与 ID 各有什么优劣?
- 典型 ID 编码方案:层次路径编码、扁平自增/哈希、实例+信号复合键;如何保证全局唯一?
- ID 分配的遍历顺序如何确定,才能对并行/无序展开稳定(确定性构建)?
- 哪些 RTL 修改不影响已有 ID,哪些会引发漂移?如何设计编码让漂移局部化?
- 增量编译如何做 ID 复用(名称/结构匹配、指纹),减少网表/映射/调试缓存失效?
- RTL ID 与 Verilog 全限定层次名(top.u_core.u_alu.sig)如何一一对应?
一、为什么需要一个数字主键
最直觉的方案是直接拿 Verilog 全限定层次名当标识:top.u_core.u_alu.add_a。它可读,但当不了工程主键:①字符串长、比较与哈希成本高,几百万对象的表里反复传字符串无法接受;②名字可能重名(不同 generate 分支、数组下标)或被综合器改名;③跨工具交接时,有的工具接受层次名、有的只吃数字 ID。于是编译器在展开后的实例树上另发一套全局唯一、紧凑、尽量稳定的整数主键——RTL ID。层次路径不废弃,而是作为 ID 的属性旁路保存,人看路径、机器用 ID。
二、对象模型:四类 ID 空间
展开结果里需要标识的对象分四类,各自独立编号空间或用类型前缀区分:
| 对象 | 举例 | ID 用途 |
|---|---|---|
| 实例 instance | u_alu、u_regfile[17] | 分割、替换匹配、回映聚合 |
| 端口 port | u_alu.add_a | 跨层次连接追踪、probe 定位 |
| 信号 net/reg | 内部网线、寄存器位 | GateID 映射、翻转活动回映的最终落点 |
| 层次节点/特殊对象 | generate block、接口 modport | 保持结构可读、ID 表分组 |
寄存器位信号常要细到 bit(功耗活动按位翻转统计),所以信号 ID 一般支持「基 ID + 位选择」两级表示。
三、编码规则:路径编码 vs 扁平 ID
主流两种方案,实践中多为混合:
- 层次路径编码:ID 由各级序号拼成(如
1/3/0/12)。优点是看 ID 就知道在树里的位置、子树 ID 天然连续、分区聚合快;缺点是父层中间插入节点会导致整棵子树编号平移; - 扁平自增/哈希 ID + 旁路面:遍历发号,层次关系存在另一张父指针表里。优点是新增对象只取新号、不影响别人;缺点是定位层次必须查表。
混合做法:顶层和大模块用路径语义分区(高位段编码子树),区内扁平发号(低位段自增),既控制漂移范围又保持发号简单。无论哪种,唯一性靠「遍历顺序确定 + 发号器单调」保证,不靠对象名字内容哈希(哈希方案抗改名强但不可读、且哈希冲突要处理,工程上少见纯哈希)。
四、确定性分配:并行构建也要逐字节可复现
原型编译很耗时,工具会多线程展开;但 ID 分配必须确定性(deterministic)——同样输入,任何机器跑任何次数,ID 表逐字节相同,否则缓存、版本比对、调试经验全部失效。规则:
- 遍历顺序固定:子实例按 RTL 源码中的词法顺序(不是哈希表迭代顺序、不是完成顺序)排列;
- generate-for 按循环变量升序,实例数组按下标升序,条件 generate 用分支标签的规范名;
- 并行线程只负责构建子树(局部发号或按预分配号段发号),归并时按确定顺序拼接;
- 禁止用内存地址、线程 ID、时间戳参与编号。
五、稳定性定理与漂移影响面
核心承诺:原始 RTL(源码+配置指纹)不改,RTL ID 不变。 反过来,改动的影响面可按对象分类:
| 改动 | ID 影响面 |
|---|---|
| 改 always 内部逻辑、改表达式 | 结构不变 → 实例/信号 ID 全不动(这正是 ID 绑结构而非绑网表的价值) |
| 新增一个实例,挂在父节点末尾 | 仅新对象取号,旧 ID 稳定 |
| 在实例数组/generate 中间插入 | 该点之后的路径编码平移,扁平方案仅局部受影响 |
| 删除实例 | 扁平方案旧 ID 作废、不复用;路径编码后续平移 |
| 改参数(位宽、深度、核数) | generate 数量变化,影响面可能整片子树 |
| 模块改名/移动层次 | 路径属性变;结构型 ID 是否漂看方案,重命名映射可救 |
| 重排例化语句顺序 | 词法序变化,可能整体重排——纯格式调整也会漂 ID,切忌手贱重排 |
这解释了两条工程纪律:给数组追加元素永远加末尾;无功能的代码重排不要混进原型交付。
六、增量编译与 ID 复用
全量重编译一次几小时,增量编译要在「改了几行 RTL」时复用旧结果:
- 给每个子树算结构指纹(规范化后的源码 + 参数实参 + 子指纹),指纹未变的子树直接复用旧 ID 与下游缓存(综合结果、分区归属);
- 新增对象优先分配历史未用号(扁平方案),保证「同结构 = 同 ID」;
- 改名但结构相同时,用名称/位置匹配把旧 ID 迁到新名字下,保住调试断点和 probe 清单;
- 输出最小失效集:只有受影响子树的 GateID 映射、网表、P&R 需要重做,其余增量保留。
七、RTL ID 表的物理形态
阶段 1 落盘一张 rtl_id 表(文本 JSON/CSV 或工程库格式),每条至少含:RTL ID、对象类型、全限定层次路径、位宽、所属时钟域、源码文件与行号、结构指纹。它在阶段 3 被逻辑综合引用:每个新产生的 GateID 都要回溯到驱动它的 RTL 信号/实例,形成 info_table(17 info_table 映射表 GateID↔RTLID/回溯/版本 详述表结构)。RTL ID 表只存在工程服务器,绝不进比特流。
八、四位一体的版本纪律
RTL ID 是跨阶段引用的主键,因此一次上板运行涉及的四样东西必须严格同版本:RTL(含配置指纹)→ RTL ID 表 / info_table → 网表 → 比特流。在旧比特流上用新映射表回映,采到的波形会张冠李戴且毫无报错。工程做法是把配置指纹与 ID 表 hash 写进比特流旁边的版本清单(不进比特流本身),烧录与采集时强制核对(20 比特流烧录与四方版本一致 manifest/门禁 展开版本一致性流程)。
九、ID 稳定性在跨团队消费侧的真实含义
「RTL 不改则 ID 不变」这句话写在设计文档里很简单,但它的价值要等到下游各种工具都把 ID 当外键使用时才真正兑现,理解这一点有助于反过来约束 ID 的设计。采集团队会用 ID 列表配置「这次要看哪些信号」;波形和活动数据库以 ID 为行键存储历史数据;覆盖率平台按 ID 聚合每个实例的命中情况;软件团队的调试脚本可能直接引用某个状态寄存器实例的 ID 做条件触发。如果一次无关的重构(比如在两个模块之间插入一层 wrapper、调整文件编译顺序、把一个 generate 展开方式换掉)让成批 ID 漂移,那么所有历史采集配置失效、上周的波形数据无法与今天的对齐、回归基线无法比较,损失远大于编译器多花几分钟重新编号。因此稳定性定理在工程上要细化成几条可验证的不变量:同一上游提交、同一适配层提交、同一编译器版本下,ID 必须逐字节可复现(确定性分配);上游一个叶子模块内部改动,只允许该模块内部新增对象的 ID 变化,模块外部所有 ID 不动(局部性);新增模块只能获得此前未使用的新 ID,不允许重排既有 ID(单调性);删除模块产生的空缺 ID 默认不复用,避免旧数据被错误地解释成新对象的活动(无复用)。每条不变量都应有自动测试:取两份设计,一份只改某个叶子模块的一行逻辑,diff 它们的 ID 表,变化必须只落在该子树内。这套测试本身就是编译器回归测试的一部分,一次破坏稳定性的优化(比如为了压缩 ID 空间做全局重排)会立刻被拦住。ID 体系的设计者要永远记住:主键的价值不在唯一性——那很容易——而在它被几百个下游资产引用之后仍保持稳定,这才是昂贵的部分。
十、层次压缩与重展开:什么时候允许动 RTL Hierarchy
RTL Hierarchy 是回映的锚点,直觉上似乎「任何层次都不能动」最安全;但完全保留层次会让综合优化被模块边界捆住手脚(边界上的冗余寄存器无法合并、跨模块组合逻辑无法一起优化),也会让分区粒度过粗。实际系统采取的是声明式层次策略:设计师在交付时给层次打标签——哪些边界必须保留(回映锚点、验证黑盒边界、固件可见模块)、哪些允许优化穿越(叶子内部的纯数据通路)、哪些可以在实现时展平。原型编译器遵循标签:标记保留的模块在网表里作为实例对象存在、有自己的 GateID 范围、回映时统计可以聚合到该层次;允许穿越的边界在综合后退化为扁平 cell 集合,但 info_table 仍保留每个 cell 来源于哪个 RTL 实例的记录,因此即使物理层次消失,逻辑归属仍可查。这里的关键区分是综合期展平与ID 期遗忘:网表可以打平,映射关系不能丢。另一种操作是重展开——为了分区平衡,编译器可能把一个大模块拆成两个子块放不同 FPGA,这不是层次变更而是同一实例对象在物理上的分散,GateID 仍归属同一 RTL 实例,回映时该实例的活动由两片采集结果合并。报告中要区分「层次内聚」(一个实例在一片 FPGA 内)与「层次分散」两种情况,因为后者的活动统计带有跨片合并误差。对设计师的可操作建议是:凡是你将来想在活动报告里看到独立一行的模块(要做功耗签核的 IP、要评估利用率的加速器、怀疑有性能问题的子系统),交付时就明确保留层次;事后想加锚点,往往已经无法从打平网表干净恢复。
十一、ID 冲突、命名碰撞与多语言/多库混编的处理
规模一旦到几万实例、多个第三方 IP 库、外加不同语言(Verilog/VHDL/SystemVerilog)混编,名字层面的碰撞几乎必然发生:两个库里各有一个 u_fifo,generate 展开产生 genblk[0] 之类的工具相关命名,VHDL 的大小写不敏感与 Verilog 的大小写敏感混用时同名不同体。扁平路径字符串作为主键在这种环境里极其脆弱,这正是数字 ID 存在的理由,但数字 ID 仍要处理对象身份问题。工程做法分三层:第一层,规范名(canonical name)——展开器给每个对象生成一个与语言无关的规范路径,规则统一处理 generate 索引、数组实例、大小写、转义标识符,规范名只用于显示和调试,不承担唯一性保证。第二层,身份判定不靠名字——两个对象是否同一实例,由展开树的结构位置(父对象 ID + 本地索引)决定,而不是名字字符串;因此即使两个子模块同名,它们的父链不同,ID 也不同。第三层,冲突显式化而非隐式覆盖——当黑盒库中两个模块定义同名、参数不同,展开器必须报错要求消歧(库名限定),禁止后读入的定义静默覆盖先读入的;历史上不少「为什么这个 IP 行为变了」的事故,根因就是综合器在名字冲突时选了另一个库的同模块。ID 表的物理格式建议同时保存数字 ID、规范名、原始语言内名、父 ID、来源文件与行号、对象类型,让任何一个名字层面的疑问都能反查到结构位置。跨多片 FPGA 时 ID 空间还要带芯片号前缀(见 60 篇),保证两片上各有一个 u_fifo 也不会在合并库里撞车。把这些规则在第一天就定死,比项目中期发现 ID 二义性再迁移代价小几个数量级。
十二、ID 体系的调试接口:人读视图与工具接口
数字 ID 保证了机器稳定,但工程师不可能在讨论中说「请帮我看 1847293 号对象」;一套 ID 体系要同时服务机器和人,需要在设计之初就规划好两层视图和它们之间的严格转换。人读层保留层次路径、模块例化名、信号名和数组下标(如 top.u_core[2].u_pipe.fifo_wptr[5]),它是所有报告、波形、评审材料的呈现形式;机器层是整数 ID。两层之间通过 ID 表双向转换,且转换必须唯一、可校验:路径解析时每一段都能在父对象的子表中找到,下标越界、重名、已删除路径都给出明确错误而不是近似匹配。批量操作接口:调试和采集工具的真实需求很少是点查单个对象,更多是「给我这个子树的全部时序单元」「所有名为 *_gray 的指针」「这个时钟域的全部边界寄存器」,ID 服务要支持层次闭包、按类型、按时钟域、按正则名字的组合查询,返回 ID 列表直接喂给采集配置;查询语句本身可以保存命名(观察视图),并按稳定性定理在版本升级后自动迁移或报告失效,而不是让每版手工重选几千个信号。反查与解释:拿到一个报错里的 GateID,要能一跳查出它的完整身份(路径、类型、来自哪个 RTL 提交、当前在哪片 FPGA、是否在观测集里);这条链路在 bring-up 期间每天被使用上百次,查询延迟应当是毫秒级,因此映射表要常驻服务而非每次打开大文件。版本化 API:所有工具(仿真协同、采集、回映、覆盖率、签核打包)通过同一个版本化服务访问 ID,而不是各自解析各自的文本表;服务接口带版本号,底层表格式演进时工具不连锁损坏。权限与审计:ID 查询本身不敏感,但「谁在什么版本上配置了哪些观测点」属于可追溯信息,结合 64 篇的 run 记录可以完整复盘一次调试活动。把 ID 体系想成一个微型数据库产品而不是一个编号脚本,是它能否支撑上千人、几十个工具并发使用的分水岭。
十三、稳定性失败案例集:ID 漂移是怎样实际发生的
抽象地讲稳定性定理不如看真实事故,以下是原型编译器实践中反复出现的漂移模式,每一条都对应一条应固化为回归检查的规则。编译顺序依赖:并行展开多个文件后按线程完成顺序合并,容器遍历顺序不确定,同一份 RTL 两次构建产生不同 ID。修复方式是所有合并按键排序、并行只发生在计算阶段、归约阶段确定性聚合。哈希迭代器顺序:用哈希表存子实例再直接遍历,不同语言/库版本遍历顺序不同;统一改为有序结构或遍历前排序。环境泄漏:构建结果依赖当前时间、主机名、临时目录路径、工具许可证服务器返回的顺序;这些字符串若进入任何生成内容(注释、调试信息)都会破坏逐字节复现。规则是构建沙箱化,环境变量白名单传入。generate 展开命名歧义:genvar 循环和条件 generate 嵌套时,不同综合器生成 genblk[3] 的编号规则不同,编译器换版本后编号平移;ID 不能建立在这些名字上,必须按结构位置编号,规范名自行生成。「无害」重构的连锁反应:设计师把两个 always 块合并、把一层条件表达式改成 case,功能等价但展开树内部结构变化,导致子对象顺序变化、批量 ID 漂移;这类漂移无法完全避免(对象确实变了),但应被限制在受影响模块内(局部性定理),若报告显示整片漂移说明稳定机制失效。ID 复用事故:删除模块 A 后,新模块 B 在同版分配到了 A 的旧 ID,历史波形把 B 的活动显示成 A——因此废弃 ID 永久保留墓碑标记。跨工具坐标混淆:Compiler 的 GateID 与 Vivado 实现后的单元名是两套坐标,某次脚本错误地用后者去查前者的表,产生看似合理实则错位的数据;两套空间必须前缀分离、转换只走 info_table。每条事故的共同教训是:ID 系统的正确性不能靠约定,要靠确定性构建、内容指纹、稳定性回归测试和墓碑机制共同强制执行。
十四、ID 与映射的最小可用实现:小团队怎么做
前述体系看起来是大公司重型基建,小团队资源有限,需要知道哪些是必须坚持的内核、哪些可以简化。按必要性排序如下。第一优先:稳定的层次命名约定和确定性展开。零成本的纪律价值最大——规定例化名显式且唯一、generate 写法规范、构建输入排序固定,就能拿到 80% 的稳定性收益,不需要自研编译器,只需 lint 脚本和构建包装器。第二优先:一张朴素但完整的映射表。哪怕只是综合后导出的文本文件,只要包含每个网表对象的名字、类型、来源层次、所在器件,并与比特流和 RTL 提交哈希一起打包,就满足了「数据可追溯」的底线;格式用结构化文本即可,重点是随版本不可变归档。第三优先:版本自证寄存器。在设计里加一个几十行的只读版本块、上电打印或通过调试口读出,成本极低,却消灭了最危险的错版事故;这一项对任何规模的团队都是强制的。第四优先:观测点清单化。把 dont_touch/mark_debug 的信号列表作为配置文件管理,与映射表版本绑定,避免信号散落在各工程师的工程文件里。可以暂缓的:列式数据库、增量 ID 分配、交互式查询服务、复杂指纹链——等网表规模和团队人数真的让朴素方案疼了再建,过早建设会变成没人维护的负担。无论规模大小,三条纪律不能省:构建可复现(同输入同输出)、版本强绑定(数据自带出处)、映射不猜测(查不到就标未知)。守住这三条,三人团队的原型数据一样经得起签核会议的追问;丢掉它们,再豪华的平台也只是在快速生产不可信的数字。
十五、ID 体系与系列其他主线的关系
收尾时把 ID 这条主线放回 06~25 的全局,看清它在各处扮演的角色,有助于理解为什么本系列花两册篇幅讲「编号」。对交付与展开(51~53 篇),ID 是交付契约的机器形式:层次稳定的要求最终服务于 ID 稳定,门禁检查的许多规则实际上在保护未来的主键。对替换与分区(55~57 篇),ID 让替换关系和割边归属可以脱离名字字符串表达——规则作用于 ID 集合,分区移动的是 ID 区间,跨片两端的同一信号靠 ID 配对。对插桩与采集(58、66 篇),观测点就是一批被配置进采集硬件的 ID:软件下发 ID 列表,硬件回传带 ID 的活动数据,整条链路不需要任何层次名字在线传输。对综合与映射(15~17 篇),RTL ID 到 GateID 的传播是 info_table 的核心内容,没有稳定上游就没有可信下游。对约束与频率(62、63 篇),时序例外和时钟域标注按 ID 精确施加,避免重名误伤。对部署与协同(64、65 篇),manifest 记录的是各组件的 ID 表指纹,协同激励按 ID 选择观测和注入点。对回映、分析与签核(67~69 篇),ID 是全部统计的坐标轴:活动按 ID 聚合、沿层次上卷、与覆盖率和功耗工具对接。可以说,整条流水线里流动的不是「电路」本身(电路在网表和比特流里),而是对电路对象的引用;ID 体系就是这些引用的命名空间。它的设计哲学也因此清晰:宁可在前期为确定性、稳定性、墓碑、局部性这些枯燥性质投入,也不接受任何一次「这个对象大概是那个」的猜测——因为猜测一旦混入引用系统,错误会沿着采集、回映、签核逐级放大,最终变成流片决策依据里的一个无法察觉的谎言。理解到这一层,「为什么编号要这么较真」就不再是流程问题,而是整条技术路线能否成立的问题。
知识脉络
与系列及现有篇目的衔接
- 上游:09 编译器前端展开 Elaboration AST/实例树
- 下游:16 GateID 与逻辑网表模型 cell/net/ID 分配、17 info_table 映射表 GateID↔RTLID/回溯/版本
- 版本纪律:20 比特流烧录与四方版本一致 manifest/门禁、03 原型平台 bring-up 多片点亮/trace
总结
一句话总结:全限定层次名(top.u_core.u_alu.sig)可读但太长、会重名、会被工具改名,不能充当跨阶段主键,所以编译器在展开后的实例树上给每个实例、端口、信号(细到 bit)和层次节点另发一套全局唯一、紧凑、尽量稳定的 RTL ID,层次路径降为 ID 的旁路属性;编码上多采用「高位段按子树路径分区、低位段区内扁平自增」的混合方案,兼顾子树聚合与漂移局部化;分配必须确定性——子实例按源码词法序、generate 按变量序、数组按下标序,多线程只构建子树并按固定顺序归并,杜绝地址/时间戳参与编号;稳定性承诺是「源码加配置指纹不变则 ID 不变」,改内部逻辑不影响任何 ID,但中间插入实例、改参数、挪层次、重排例化语句都会引起可预测范围的漂移,所以追加节点永远放末尾、不要做无功能重排;增量编译靠子树结构指纹复用旧 ID、改名走名称匹配迁移、输出最小失效集;RTL ID 表(ID/类型/全路径/位宽/时钟域/源码位置/指纹)只存工程服务器、不进比特流,它在阶段 3 被 GateID 引用汇成 info_table,因此 RTL、ID 表/映射表、网表、比特流必须四位一体同版本,错版回映会静默地张冠李戴。