Vivado综合和DC综合结果为什么不一样:目标库与优化策略的差异
同一个 RTL 文件,丢给 Vivado 综合出来一份网表,丢给 Synopsys Design Compiler(下文简称 DC)综合出来另一份网表,单元数量不同、时序报告不同、面积报告更没法直接比——很多从 FPGA 转向 ASIC 流程的工程师,第一次面对这两份报告时都会问:是不是其中一个工具综合错了? 答案几乎总是否定的。关于综合的基础流程可先读 综合入门:从 RTL 到门级网表,本文只聚焦一个问题:差异从哪里来、哪些差异是合理的、哪些差异才值得你紧张。
本文要回答的问题
- Vivado 和 DC 综合结果不一样的根因是什么?
- 哪些报告指标根本不能直接对比、哪些可以对比?
- 同一段 RTL 在两边会分别被映射成什么?
- 什么情况下「结果不一样」才真正说明设计或约束出了问题?
简短结论
不一样是预期行为,一样才是巧合。 Vivado 综合面向 Xilinx FPGA 的固定架构原语(LUT、触发器、DSP48、Block RAM),DC 面向某条工艺线的 ASIC 标准单元库(NAND、NOR、触发器单元)。目标器件的「积木」完全不同,拼出来的成品自然不同。再加上两边的优化目标函数、默认策略、时序约束口径都不一样,面积和时序数字没有可比性。真正需要紧张的不是「数字不同」,而是「功能不同」或「约束下不收敛」。
理由一:目标库完全不同,映射终点就不同
综合的最后一步是技术映射(technology mapping):把通用逻辑门翻译成目标库里真实存在的单元。Vivado 的「库」是 FPGA 的硬件架构——6 输入 LUT 可以实现任意 6 变量布尔函数,乘加运算会被塞进 DSP48,大存储被识别为 Block RAM。DC 的「库」是 foundry 提供的 Liberty 文件(.lib),里面是一个个真实的标准单元:不同驱动强度的 NAND2、带扫描链的 D 触发器,每个单元有真实的面积、延迟、功耗参数。关于 Liberty 库文件的结构可延伸阅读 标准单元库与 Liberty 文件。
积木种类不同,同一张图纸盖出来的房子自然不同——这不是谁的错,是起点就约定了终点不同。
理由二:优化目标与默认策略不同
即便不看映射目标,两边的「优化器性格」也不一样:
| 维度 | Vivado 综合 | DC(compile / compile_ultra) |
|---|---|---|
| 首要目标 | 资源利用率与 FPGA 时序收敛 | 面积、时序、功耗的多目标权衡 |
| 时序模型 | 预布线估算,真实延迟靠实现阶段 | 线载模型(wire load model)估算 |
| 默认面积观 | LUT/FF/DSP/BRAM 用量 | 标准单元面积(平方微米) |
| 时钟门控 | 默认做(映射到 CE 或专用门控) | 需 Power Compiler 选项显式开启 |
| 重定时(retiming) | 默认关,可开 | 默认关,optimize_registers 开启 |
| 面积回收 | 弱(FPGA 资源反正在那里) | 强(面积就是钱) |
同一个乘法器,Vivado 看到 a * b 倾向于推断成 DSP48 原语,DC 则会根据位宽和时序余量在「阵列乘法器 / Booth 编码 / 移位相加」之间做面积-延迟权衡。优化器面对的成本函数不同,做出的取舍必然不同。
理由三:时序约束口径与报告数字没有可比性
很多「结果不一样」的惊呼其实源于报告读法错误。Vivado 的时序报告基于 FPGA 器件的已知走线资源估算,WNS(最差负裕量)以纳秒计;DC 的时序报告基于线载模型——在物理实现之前,它连连线多长都还不知道,只能靠统计模型猜。两边的「时序通过」含义完全不同:Vivado 的时序终点在布局布线之后才算数,DC 综合阶段的时序只是一个「大概率能在后端收敛」的预估值。约束文件的写法也有差异:SDC 标准两边都认,但时钟不确定性、I/O 延迟的建模习惯不同,同一份约束直接搬过去往往要调整。SDC 的基本写法见 SDC 约束入门。
理由四:面积与资源报告单位不同
Vivado 报告的是 LUT 数、FF 数、DSP 数、BRAM 数——这些是离散配额,一个 2 输入与门和半个加法器都可能各占一个 LUT,「用了 1200 个 LUT」不对应任何物理面积。DC 报告的是平方微米(或等效门数),是连续物理量。把「Vivado 用了 800 LUT」和「DC 报了 5000 um²」放在一起比大小,就像比较「用了 3 块乐高」和「占地 2 平方米」——单位体系根本不通。
理由五:同一 RTL 的实例对照
下面这张对比卡把同一段 RTL(一个带乘加和状态机的数据通路模块)在两边综合后的典型差异汇总在一起,可以直观看到每个维度为什么会分叉。
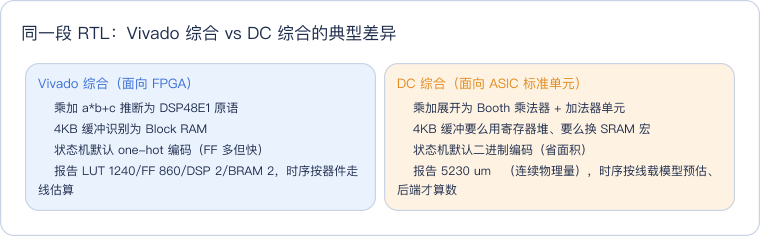
读这张卡的关键一点:左右两边没有一行是可以直接比大小的。原语 vs 标准单元、离散配额 vs 物理面积、器件走线 vs 线载模型——三个层面的度量衡都不同。
差异的分层视角
把上面五条根因按「综合流程发生的先后」分层,会更清楚差异是在哪一层注入的。

读这张图的主线:两个工具只在最顶层的输入是相同的,往下每经过一层就注入一层差异,到报告层已经没有可比性。这也解释了为什么「让两边结果对齐」是个伪命题——你能对齐的只有功能。
常见误区
- 误区一:「面积不同说明一个工具更优」。 单位不同不可比,且 DC 报的面积是 ASIC 物理面积,Vivado 根本没有这个量。
- 误区二:「综合后功能要不要再验证?」 要,而且必须做。网表不同没问题,功能不同就是事故。用形式等价检查(LEC)或门级仿真确认综合后网表与 RTL 功能一致,方法见 LEC 逻辑等价检查与 Yosys 实践。
- 误区三:「在 Vivado 里跑通了时序,搬到 DC 也一定能收敛」。 FPGA 上 200 MHz 能跑,不代表 ASIC 在同约束下能收敛——数据通路结构对 DSP 原语的依赖一旦展开成标准单元,关键路径会面目全非。
- 误区四:「把 DC 的约束文件原样拷给 Vivado」。 SDC 语法通用,但时钟不确定性、I/O 延迟、多周期路径的建模习惯随流程不同,照搬通常要修。
- 误区五:「综合属性两边通用」。
keep、dont_touch这类属性两边语义相近,但 DSP/BRAM 推断属性是 Vivado 专属,DC 不认识;反之 DC 的set_max_area在 Vivado 里没有对应物。属性的可移植性细节见 综合属性用法。
这一篇在知识体系里的位置
本文属于「流程对比辨析」类:上游是 综合入门:从 RTL 到门级网表 和 FPGA 与 ASIC 的区别,横向关联 LUT 与触发器深入(理解 LUT/DSP/BRAM 这些映射终点是什么)与 标准单元库与 Liberty 文件(理解 DC 的映射终点)。往下走,验证侧接 LEC 逻辑等价检查,开源流程对照可看 Yosys 综合流程报告解读。
一句话总结
Vivado 综合和 DC 综合结果不一样,是因为两者的目标库(FPGA 原语 vs ASIC 标准单元)、优化策略(资源利用 vs 面积时序功耗权衡)和报告口径(离散配额 vs 物理面积、器件走线 vs 线载模型)从头到尾都不同——网表不同是设计使然,功能相同才是需要守住的底线;判断综合质量的标准不是「两边数字像不像」,而是「各自在自己的约束下是否收敛、综合后功能是否与 RTL 等价」。