LLM 推理可观测性:从 TTFT/TPOT SLO 到 token 级 tracing 与 DCGM 指标的全景
更新时间:2026-10-03。这是一篇枢纽文:站内已经有一批 LLM 推理长尾深文——TTFT/TPOT SLO 的工程定义、SLO 感知调度与 goodput、推理引擎运行时调度、Nsight 性能分析、vLLM V1 调度器设计——每一篇都深挖一层。这篇换到运维与排障的俯视视角:把「用户视角的慢」「系统视角的忙」「硬件视角的堵」三层信号串成一套 LLM 推理可观测性体系,回答一个工程上最实际的问题——线上推理服务出现延迟抖动,我该先看哪块仪表盘、按什么顺序往下钻。
本文要回答的问题
- 传统微服务的 RED 指标(Rate/Error/Duration)为什么搬到 LLM 推理上会失真?该换成什么?
- TTFT 和 TPOT 为什么要分开监控,分位数又该看 P50 还是 P99?
- token 级 tracing 怎么把一个请求的「慢」定位到排队、prefill、decode、传输中的哪一段?
- DCGM 暴露的几十项 GPU 指标里,真正该上告警的是哪五六个?
- 告警怎么分层才能既不漏报又不把 on-call 淹死?
- 容量回归测试为什么是发布流程的一部分,而不是出了问题才补的作业?
一、为什么传统 APM 在 LLM 推理上失灵
先建立一个反直觉的事实:把一个 LLM 推理服务当普通 HTTP 服务监控,得到的数字几乎都是误导。
普通微服务的请求是「同构」的:一次查询几十毫秒,请求之间耗时差异一个数量级以内,平均响应时间是有意义的统计量。LLM 推理的请求是「异构」到极端的:同一条接口,prompt 可以是 20 个 token 也可以是 10 万个 token;输出可以是一句话也可以是三千字长文;请求耗时从几百毫秒横跨到几分钟——四个数量级。对这样的分布取平均,等于把兔子和骆驼放一起算「平均腿长」。更要命的是,请求耗时的大头由「输出多长」决定,而输出长度是模型自己选的,服务方既控制不了也预测不了,「平均延迟上升」可能只是因为用户开始问更长的问题,系统本身毫无问题。

上图是两种负载形态的根本差异。对应的解法不是放弃监控,而是把监控对象从「请求」换成「token 和阶段」。这是整套 LLM 推理可观测性体系的出发点,站内 TTFT/TPOT SLO 的工程定义 给出了指标口径的完整推导,本文只讲它们怎么嵌进观测栈。
第二个失灵点是资源利用率的语义变了。CPU 服务里「CPU 利用率 90%」几乎等价于「快满了」;GPU 推理里 SM 利用率 90% 可能只是说明 decode kernel 在空转等显存——decode 阶段是带宽瓶颈,SM 占满不代表吞吐满了,反过来 SM 利用率 40% 也可能已经是该 batch 形状下的物理极限。不看 kernel 形状光看利用率百分比,扩容缩容决策全会做错。这一层的硬件背景见 GPU 显存层次与带宽。
第三个失灵点是错误的表现形式变了。HTTP 服务的错误是显式的:状态码 500、超时、连接拒绝,数出来就是错误率。LLM 推理的错误大量是隐式的:请求正常返回 200,流也完整走完,但生成到一半因为 KV cache 被抢占(preemption)重算了一遍,TTFT 没受影响、总耗时翻了一倍;或者引擎因为显存压力静默把请求塞进重算队列,从外部看只是「这条请求偶尔特别慢」。这类「灰色失败」不进任何错误计数,只能靠生命周期事件日志(preempted、recomputed、aborted 这类引擎内部事件)单独成流地采集。vLLM 的 metrics 里 num_preemptions 就是这样一个信号,它上涨时错误率仪表盘上一片平静,用户体感却已经在恶化——这是传统 APM 思维最容易漏掉的一类故障。
二、第一层:用户视角——TTFT/TPOT 双指标与 SLO 分位数
用户能感知的只有两件事:第一个字多久出来(TTFT,Time To First Token)和之后流式输出顺不顺(TPOT,Time Per Output Token,相邻 token 间隔)。这两个指标必须分开监控,因为它们的瓶颈来源完全不同:TTFT 由排队时长加 prefill 耗时决定,对调度器和 prefill 算力敏感;TPOT 由 decode 每步耗时决定,对 KV 读取带宽和 batch 构成敏感。一个服务完全可能 TTFT 健康而 TPOT 超标(batch 里混进了超长上下文的 decode),或者反过来(prefill 集群过载但 decode 空得很)。

工程落地有三个要点。其一,看分位数不看均值,而且 TTFT 看 P90/P99、TPOT 看 P50 加 P99 双档:TTFT 的尾部暴露排队恶化(continuous batching 下队尾请求等了几个调度周期),TPOT 的 P50 反映流式体验的基线、P99 暴露偶发的 batch 抢带宽。其二,指标要按输出长度分桶——把生成 10 token 的请求和生成 2000 token 的请求混在一条曲线上,TPOT 的趋势会被请求构成变化淹没;vLLM 等引擎的 metrics 端点原生带 per-request 计时,接入时在网关侧按长度桶打 label 即可。其三,SLO 要写成业务语言:「对话场景 TTFT P90 小于 800ms、TPOT P50 小于 50ms」这种口径才能和产品对齐,纯系统指标(吞吐、显存占用)只是达成 SLO 的手段。goodput(满足 SLO 的有效吞吐)这个把两层指标缝起来的概念,见 SLO 感知调度与 goodput。
还有两个口径问题要在接入第一天就定死,否则后面所有仪表盘都在各说各话。一是TTFT 的计时起点:从网关收到完整请求体算,还是从请求进入引擎队列算?前者包含鉴权、限流、prompt 模板渲染的开销,后者只反映引擎内部——两段都要采,但 SLO 对外承诺必须用前者,因为那是用户真实感知的起点。二是流式场景 TPOT 的统计方式:相邻 token 到达间隔的原始序列抖动很大(采样、网络缓冲都会制造毛刺),直接对原始间隔取 P99 会难看到没法用;工程上惯用的是「总生成时长除以输出 token 数」的均值口径做 P50 基线,再叠加一个「单间隔超过 200ms 的停顿次数」作为卡顿指标,两条曲线各司其职。多模态或带工具调用的 Agent 场景还要再加一段:模型停下来等工具返回的时间既不算 TTFT 也不算 TPOT,需要单独一个「外部等待」阶段,否则 Agent 负载接进来那天,所有延迟曲线会莫名其妙地整体右移。
三、第二层:请求视角——token 级 tracing 拆解延迟
SLO 曲线告诉你「慢了」,tracing 告诉你「慢在哪一段」。LLM 推理的 tracing 和传统分布式 tracing 有个关键区别:跨服务的 span(网关→调度→worker)只解释 TTFT 里的一小段,真正的大头在单个请求的生命周期内部——排队、prefill、每一个 decode step、采样、流式回传。所以要在引擎内部埋点,把请求生命周期切成可观测的阶段:
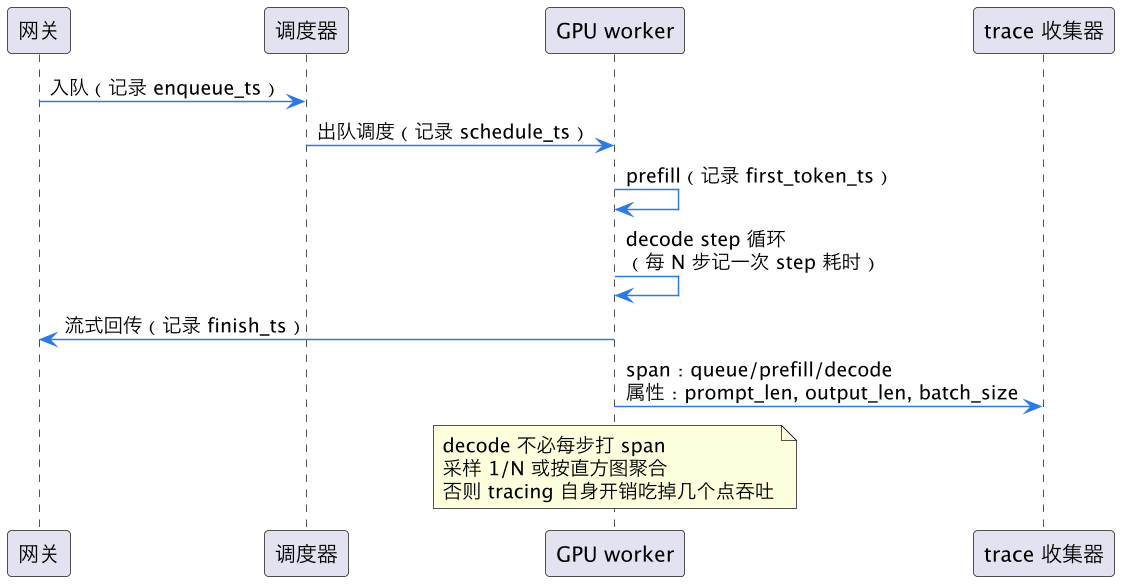
这张图给出了一套实际可用的埋点位置。四个时间戳(入队、出队、首 token、结束)就能把任何请求的延迟拆解成「排队 X 毫秒 + prefill Y 毫秒 + decode Z 毫秒」,配上 prompt_len、output_len、当时 batch_size 三个属性,九成以上的「这个请求为什么慢」的工单可以直接在 trace 查询界面里结案。导出走 OpenTelemetry 协议接进现有 Jaeger/Tempo 体系即可,不需要为 LLM 单独搭一套。
两个落地细节。一是开销控制:decode 每步十几到几十毫秒,逐步打 span 的开销不可接受,工程上的惯例是逐请求保留 queue/prefill/decode 三段粗 span,decode 内部改为每 32 或 64 步聚合一次直方图,或者干脆只在 step 耗时超过阈值时打事件。二是tracing 与调度器的耦合:要知道请求「为什么排了这么久」,span 里最好带上出队时刻的批次构成摘要(batch 内请求数、总 token 数、显存水位),这些字段只有调度器内部拿得到——vLLM V1 的调度循环结构见 vLLM V1 调度器设计,TensorRT-LLM 的对应机制见 TensorRT-LLM in-flight batching。需要再往下一层钻到 kernel 时(比如某个 step 突然花了三倍时间),就轮到 Nsight 性能分析 出场了——tracing 负责圈定嫌疑范围,profiler 负责定罪。
采样率是第三个要算清楚的账。全量请求打 trace 听起来美好,算一下量级:单实例每秒几百个请求、每请求一条 trace 带十几个事件,一个中型集群一天就是几十亿条 span,存储和网络开销会反超推理服务本身的可观测预算。可用的策略是分层采样:正常流量按 1%~5% 随机采样保分布统计,SLO 违规的请求(TTFT 或总时长超阈值)100% 全采——因为慢请求恰恰是最需要被解释的那批;再叠加一条「调试通道」,网关识别特定 header 的请求强制全采,on-call 复现问题时自己打标即可。这样用个位数的存储成本换来「统计上可信 + 个案上完整」两头都占。trace 里还有一类信息常被漏采:引擎的灰色事件(preemption、KV 换出、重算),它们不是 span 而是事件注解,打在受影响请求的 decode 段上——事后排查「这条请求为什么 decode 中途慢了 3 秒」时,有没有这个注解就是两分钟结案和两小时翻日志的区别。
四、第三层:硬件视角——DCGM/GPU 指标该看哪几个
NVIDIA DCGM(Data Center GPU Manager)能暴露上百项指标,全部收进来只会制造噪音。推理场景下真正承载决策价值的就六类,按排查顺序排:
| 指标 | DCGM 字段(缩写) | 健康基线 | 异常时说明什么 |
|---|---|---|---|
| SM 利用率 | SM_ACTIVE | decode 期 30%~70% 都正常 | 长期贴近 100% 要警惕 prefill 抢占 |
| 显存带宽利用率 | DRAM_ACTIVE | decode 应为主要瓶颈信号 | 与 SM 利用率结合判断 bound 类型 |
| KV cache 显存占用 | FB_USED 加引擎侧水位 | 水位低于 85% | 水位顶满说明 batch 被迫缩小 |
| 功耗/电源节流 | POWER_USAGE 加 throttle reasons | 无 throttle | 撞功耗墙或散热墙,频率被压 |
| 温度与降频 | GPU_TEMP 加 CLOCKS_THROTTLE | 无 thermal throttle | 机房散热问题,长期烧卡 |
| PCIe/NVLink 流量 | PCIE_TX/RX、NVLINK_BANDWIDTH | 与拓扑匹配 | PD 分离或多机时暴露传输瓶颈 |
表里最后一行在多机或 PD 分离部署下权重明显上升——prefill 集群往 decode 集群搬 KV cache 的流量会直接体现在 NVLink/RDMA 计数器上,相关架构见 分离式推理集群 与 RDMA 与 GPUDirect。

上图是 SM 与显存带宽两个信号的四象限读法,这是 GPU 指标里性价比最高的一张心智图。特别提醒第四象限:throttle reasons 里出现 SW_POWER_CAP 或 HW_THERMAL 时,所有软件侧调优都是无用功,先解决供电散热。另外 KV cache 显存水位要引擎侧(vLLM 的 gpu_cache_usage_perc)和 DCGM 侧对照着看:FB_USED 顶满而引擎水位只有一半,多半是有显存泄漏或碎片,相关机制见 KV cache 与推理显存 和 PagedAttention 与 vLLM。
表格之外还有两类信号值得单独留面板。一类是 XID 错误(NVIDIA 驱动层的硬件错误码),它不计入任何性能指标,但 XID 13(显存非法访问)、XID 48(ECC 双比特错误)这类码出现时,意味着卡即将或正在出硬件故障,所有该卡上的延迟毛刺都是表象——XID 应该直通 P1 告警并触发摘卡流程,而不是等运维在日志里翻到。另一类是MIG 或时间片共享场景下的指标失真:DCGM 采集的是物理卡视角,多实例共享时单实例看到的 SM_ACTIVE 是分时的瞬时值,拿来判断容量会系统性偏乐观;共享部署的容量判断必须以引擎侧吞吐和排队指标为准,GPU 指标只做健康检查用。多卡互联拓扑对流量指标解读的影响,可对照 多 GPU 与 NVLink 互联。
五、把三层缝起来:指标关联与告警分层
三层指标各自健康不代表服务健康,真正的威力在关联。先看一个典型事故的形态:晚上八点流量高峰,TTFT P99 从 1.2 秒爬到 4 秒,但 GPU 的 SM 利用率只有五成、错误率为零——单看任何一层都得出「没大事」的结论。把三层叠在同一时间轴上才会看到真相:显存水位在 19:50 顶满,之后每个调度周期都有请求被 preempt 重算,重算拉长 batch 执行时间,排队随之恶化,最终全部体现为 TTFT 尾部的四倍放大。根因是一条上午上线的 prompt 模板改动让平均输入长了 30%,KV cache 容量按旧分布配的,新分布下不够用了。没有关联视角,这个案子很容易被定性成「晚高峰扩容」白白加卡。
一条可复制的排障动线是这样的:SLO 层 TTFT P99 告警触发 → 拉同期 tracing 聚合,看慢请求的排队段占比 → 排队段长就下钻调度器指标(队列深度、running batch 大小、等待请求数)→ 队列深再看 DCGM:显存水位顶满说明是 KV cache 容量瓶颈(扩卡或降 max_tokens),水位有余而 SM 满载说明是算力瓶颈(扩 replica 或查 prefill/decode 配比)→ 两层都不满而 TPOT 同步恶化,去查 throttle 和互连流量。这条动线的每一步都对应一张确定的面板,on-call 不需要靠灵感。
告警分层上,建议三级而不是一刀切:

两个容易踩的坑。一是对 GPU 利用率本身告警:前面说过 decode 期 SM 利用率天然不高,对它设阈值必然误报成灾;硬件层只该对 throttle、XID 错误、显存水位这类「确定有病」的信号告警。二是告警阈值写死:TTFT 里排队时长随负载自然波动,大促或热点事件期间固定阈值会刷屏;用 SLO 燃烧率(错误预算消耗速度)代替静态阈值,是这套体系里少数值得直接抄 SRE 教科书的部分。
把三层信号缝到一起的粘合剂是统一的时间轴与关联键。工程上的最低要求是:metrics(Prometheus 系)、trace(OTLP 系)、引擎事件日志三路数据打到同一个可观测后端,全部携带 request_id 与 instance_id 两个标签,时钟走同一个 NTP 源。有了这两条,前面那条排障动线的每一步跳转都是一次点击而不是一次跨系统检索;缺了它们,每次告警都是先花二十分钟对齐时间轴的体力活。这一块没有 LLM 特殊性,但它恰恰是 LLM 团队最容易欠的债——模型工程出身的技术栈里 metrics 和日志常常是两套独立系统,等第一次 P0 事故才发现对不上。
六、容量回归:让观测数据反哺发布流程
观测体系最后一公里是把性能测试变成发布的硬门禁。LLM 推理引擎迭代极快,vLLM、SGLang 一个月几个版本,每次升级都可能带来调度策略或 kernel 路径的回归;而这类回归在功能测试里完全不可见——模型输出照样正确,只是 TPOT 悄悄涨了 15%。
容量回归的做法是固化一个基准负载档案(replay profile):从线上采样若干小时的请求流(prompt 长度分布、输出长度分布、到达率曲线都保持真实形态),在预发集群对候选版本回放,产出三组数字与基线对比——SLO 组(TTFT/TPOT 分位数)、吞吐组(goodput、峰值 QPS)、资源组(同负载下显存水位与功耗)。任何一组劣化超过阈值(常用 5%)就拦截发布。这与 推理容量规划 是同一套数据的两个用法:回归测试回答「这个版本能不能上」,容量规划回答「这个版本要配几张卡」。

回放档案本身也有几条讲究。其一,采样要覆盖峰谷两种形态:只拿平峰流量回放,测不出调度器在高压下的排队行为;档案里至少要有一段接近容量上限的高峰切片。其二,输出长度要用确定性回放:线上请求的输出长度是模型当场决定的,逐字回放必须强制引擎按录制的长度生成(多数引擎支持 ignore_eos 加固定 max_tokens 的模式),否则两次回放的负载本身就不一样,对比失去意义。其三,回归阈值要分指标设:TPOT 这类 kernel 层指标方差小,5% 是合理阈值;TTFT P99 受排队随机性影响大,阈值放到 10%~15% 或改用多次回放取中位,否则门禁会频繁误拦,最后被团队绕过——一个没人信的门禁比没有门禁更糟。
至此整条链路闭环:SLO 指标定义「什么叫好」,tracing 解释「为什么不好」,DCGM 指标说明「硬件还能不能扛」,告警分层决定「什么时候叫人」,容量回归保证「明天不会比今天差」。五块缺任何一块,观测栈都会在某个深夜用一次无头绪的告警提醒你它的存在。
最后给一个落地的先后顺序,供从零起步的团队参考:第一周先把 TTFT/TPOT 分位数和 DCGM 六类指标采进来、各画一张面板——这一步成本最低、收益最直接;第二个月接入引擎生命周期事件与 tracing 的四时间戳埋点,打通 request_id 关联;第三个月建立告警三级分层和回放档案,把容量回归挂进 CI。不要反过来先做告警——没有指标分层打底,告警配出来就是噪音发生器,两周后全组把它静音,观测体系从此名存实亡。
这一篇在知识体系里的位置
本篇是「LLM 推理运维」簇的枢纽:向上接 SLO 语义,TTFT/TPOT SLO 的工程定义 给指标口径,SLO 感知调度与 goodput 讲调度器怎么主动保 SLO;向旁边看执行层,推理引擎运行时调度、vLLM V1 调度器设计、TensorRT-LLM in-flight batching 是 tracing 埋点要钻进的那三台引擎;向下钻硬件,Nsight 性能分析 承接 kernel 级深挖,GPU 显存层次与带宽 与 KV cache 与推理显存 是读懂 DCGM 指标的前置;向部署形态延伸,分离式推理集群 和 推理容量规划 分别对应互连指标与容量回归的落地场景。
总结
LLM 推理可观测性的核心是把监控对象从「请求」换成「token 与阶段」:用户视角用 TTFT/TPOT 分位数加 SLO 燃烧率定义好坏,请求视角用入队、出队、首 token、结束四个时间戳的 token 级 tracing 拆解延迟来源,硬件视角只盯 SM 利用率、显存带宽、KV cache 水位、throttle、互连流量这六类 DCGM 信号,告警按「用户受损、容量消耗、慢变量趋势」三级分层,最后用固定负载档案的容量回归测试把性能门禁焊进发布流程——五层缝在一起,任何一次延迟抖动都有一条确定的、不靠灵感的下钻动线。