Verilator 层次化编译:--hierarchical 分块加速大工程的用法与限制
更新时间:2026-11-04。常规工程走 Verilator --cc 编译仿真全流程 的一条命令就够:Verilator 把整个设计展平(flatten)成一个 C++ 模型再交给 g++。但当顶层挂着十几个大模块、Verilation 本身要跑十几秒时,这条单块流水线就成了瓶颈。本篇讲 Verilator 5.020 已实装的 Verilator 层次化编译:用
--hierarchical把指定模块各自编成独立库,再由顶层包装链接,并给出真机实测数字与版本限制。
本文要回答的问题
- 扁平编译在大工程上慢在哪,为什么单条
--cc流水线会变长? --hierarchical怎么打开,块边界用什么文件、什么语法标注?- 分块后
obj_dir里多出来的Vxxx_hier.mk、.sv包装和lib*.a各自是什么? - 真机上到底快多少、什么场景才值得开,5.020 这一版有哪些坑?
整条分块编译链路五步,先给总览:
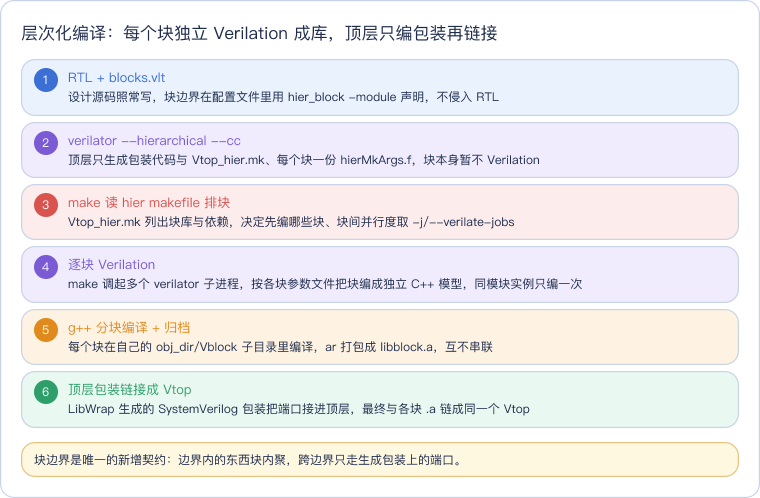
读这张卡抓住一个变化:扁平模式下「Verilation → g++」是一整块,分块后 Verilation 被拆到 make 阶段按块执行,块之间可以并行(--verilate-jobs),同一种块的多个实例只编一次、共享一个库。
一、这一步在流程里的位置
层次化编译仍然处于「RTL 到仿真可执行文件」这段,与 Verilator 接入 CI 流程 里的 sim gate 是同一步,只是把 sim gate 内部的编译动作从单块改成分块。上游输入不变:RTL 与 C++ testbench;下游产物也不变:一个 Vtop 可执行文件,testbench 代码一行都不用改。
读图对比两条流水线:扁平模式产出一套翻译单元,g++ 自己并行但 Verilation 始终单进程;层次化模式多出「逐块 Verilation」一环,块库先于顶层形成。两种模式最后跑出来的仿真结果必须逐位一致——本篇实测两种模式 q 都是 0x7ffff003,分块只改编译组织,不改语义。
二、命令与配置逐段解读
完整命令只有两处变化:开关加 --hierarchical,文件列表多一个块配置。
verilator --unroll-count 65536 --hierarchical --cc --exe --top-module top \
  rtl/top.v rtl/bigblock.v sim/tb.cpp blocks.vlt
make -C obj_dir -f Vtop.mk -j4--hierarchical:打开层次化 Verilation。不加它,即使给了块配置也不会生成 hier makefile;加了它却不给任何块声明,则等价于普通编译,不会凭空切块。blocks.vlt:块边界配置,后缀.vlt是 Verilator 配置文件的约定。5.020 实测可用内容如下,注意模块名必须带双引号,裸写标识符会报syntax error ... expecting STRING:
`verilator_config
hier_block -module "bigblock";
配置按模块名选块:所有 bigblock 实例都进同一个块库,16 个相同参数的实例共享一次编译;同一模块参数不同会生成不同的块(本篇产物名带参数散列后缀 bigblock_7)。
-j4:g++ 与块 Verilation 的并行度;帮助里另有--verilate-jobs(Verilation 阶段并行)与--build-jobs(g++ 阶段并行),-j同时给两者赋值。块种类越多、机器核越富余,并行收益越大。--unroll-count 65536:与层次化无关但大工程常撞上。生成器里 4096 次的genvar循环超过默认上限 1024,不开这个参数两种模式都报Loop unrolling took too long ... set --unroll-count above 1024。两种对比模式必须带同一个值,计时才公平。
三、输入输出文件:多了哪些产物
| 文件 | 模式 | 作用 |
|---|---|---|
blocks.vlt | 仅层次化 | 唯一的新增输入,声明哪些模块是块 |
obj_dir/Vtop_hier.mk | 仅层次化 | 总装 makefile:列出块库、逐块调 verilator、再调 Vtop.mk |
obj_dir/Vtop__hierMkArgs.f、Vbigblock_7__hierMkArgs.f | 仅层次化 | 顶层与每个块的 verilator 参数文件,子进程 -f 读入 |
obj_dir/Vbigblock_7/bigblock_7.sv | 仅层次化 | LibWrap 自动生成的 SystemVerilog 包装,块实例经它接入顶层 |
obj_dir/Vbigblock_7/libbigblock_7.a | 仅层次化 | 块独立编译后的静态库,多个实例共享 |
obj_dir/Vtop | 两者都有 | 同一个仿真可执行文件,testbench 无感知 |
可以直接从生成的 Vtop_hier.mk 读到分块机制:块库规则是 Vbigblock_7/libbigblock_7.a: Vbigblock_7/Vbigblock_7.mk,块的 Verilation 规则则依赖全部输入文件列表 VM_HIER_INPUT_FILES。这个依赖粒度在第五节的增量实验里会暴露问题。
四、常见错与检查点
| 现象 | 先查什么 | 纠正 |
|---|---|---|
make 阶段报 exec: /usr/share/verilator/verilator_bin: not found | Debian 打包版二进制在 /usr/bin,分块子进程却按 /usr/share/verilator 找 | 容器内补链接:ln -sf /usr/bin/verilator_bin /usr/share/verilator/verilator_bin(run.sh 已内置) |
Loop unrolling took too long | 展开循环超过默认 --unroll-count 1024 | 显式调大,两种对比模式同值 |
vlt 报 expecting STRING | hier_block -module 后漏了引号 | 写成 hier_block -module "bigblock";,文件首行带 `verilator_config |
%Warning-HIERBLOCK: Top module illegally marked | 块边界落到了顶层模块上 | 顶层不能是块,块必须是被例化的子模块 |
开了 --hierarchical 却像没开 | 文件列表里没给块配置,或模块名拼错 | 确认 .vlt 参与编译且模块名与 RTL 一致 |
工具本身的其他告警含义查 Verilator lint 入门流程。
五、真实跑一遍:200 万触发器设计的两阶段计时
设计由生成器产出:顶层 top 例化 16 个 bigblock,每个块是 4096 级、32 位宽的移位异或链,合计约 209 万触发器;同一 testbench、同一机器(容器可见 12 核,统一 -j4),先删干净 obj_dir 再冷构建。扁平模式的两段实测:
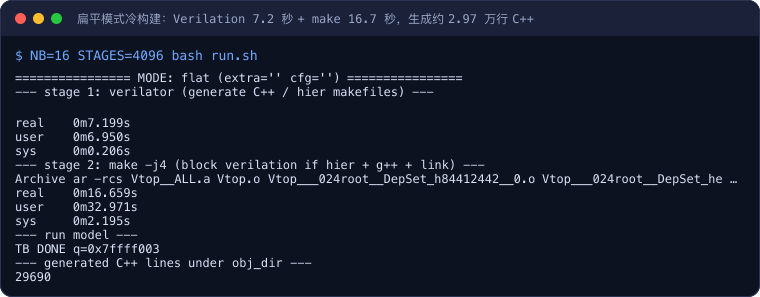
层次化模式首条 verilator 命令只处理顶层包装,1.5 秒就返回;块的 Verilation 推迟到 make 里由 /usr/bin/verilator -f .../Vbigblock_7__hierMkArgs.f 完成,随后归档出独立的 libbigblock_7.a 再链进顶层:
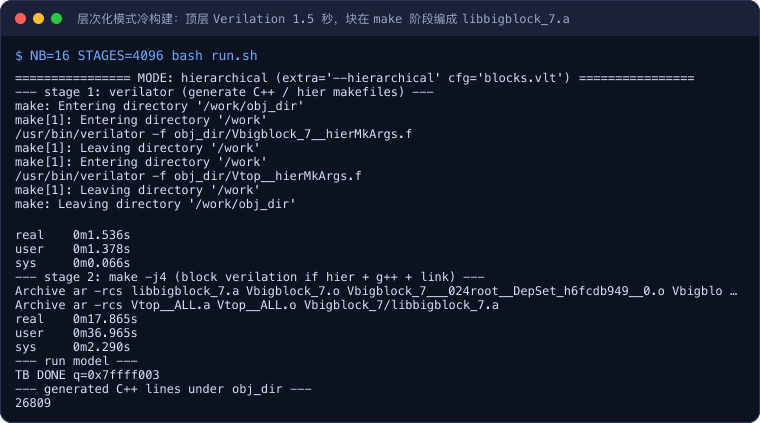
两份实录的数字汇总如下,全部来自 time 真机输出:
| 指标(冷构建,16 块 × 4096 级,-j4) | 扁平 | 层次化 |
|---|---|---|
| 首条 verilator 命令 | 7.199 s | 1.536 s |
make -j4 | 16.659 s | 17.865 s |
| 端到端合计 | 约 23.9 s | 约 19.4 s |
| 生成 C++ 总行数 | 29690 | 26809 |
| 块库 | 无 | Vbigblock_7/libbigblock_7.a |
仿真输出 q | 0x7ffff003 | 0x7ffff003 |
要诚实读这张表。冷构建端到端快约 19%,但它不是「每段都快」:层次化把 4.7 倍的 Verilation 时间从首条命令挪进了 make,make 反而略慢,因为它包含了块的 Verilation。这个设计里 16 个块是同模块同参数,扁平模式本身也会对重复实例做池化合并,所以收益被压低;块种类多、结构异质的大顶层(CPU 核加一堆外设)才能让 --verilate-jobs 把多个块真正并行起来,那才是它的主场。
5.020 的增量粒度还要单独记一笔。构建完成后分别 touch 两个源文件再跑 make,实录如下:
--- incremental: touch top.v (block internals unchanged) ---      # flat
real    0m0.033s
--- incremental: touch bigblock.v (block source changed) ---     # flat
real    0m0.027s
--- incremental: touch top.v (block internals unchanged) ---      # hierarchical
Archive ar -rcs libbigblock_7.a ...
Archive ar -rcs Vtop__ALL.a Vtop__ALL.o Vbigblock_7/libbigblock_7.a
real    0m18.942s
--- incremental: touch bigblock.v (block source changed) ---     # hierarchical
real    0m18.688s
扁平模式的 Vtop.mk 默认不自动重跑 Verilation,touch 后 make 认为无事可做(改 RTL 需要手动重发 verilator 命令);层次化模式的 Vtop_hier.mk 会按源文件戳记自动重跑,但 5.020 里块规则和顶层规则都依赖全部输入文件,动任意一个 .v 都会把块与顶层整条链重新 Verilation 加编译一遍,约 19 秒。所以这个版本别指望「改块内只重编块」的细粒度增量,它的价值在冷构建并行与工程拆组织,频繁小改的内循环未必占便宜。
实验环境
- 机器/系统:macOS(Darwin 25.5,Apple Silicon)上的 Docker Desktop,容器
geek-eda:0.4-flow,容器内可见 12 核,统一make -j4 - 工具版本:
Verilator 5.020 2024-01-01 rev (Debian 5.020-1),verilator --help含--hierarchical Enable hierarchical Verilation;g++ (Debian 13.2.0)、GNU make、python3 - 日期:2026-11-04
- 完整命令:
docker run --rm -v "$PWD":/work -w /work geek-eda:0.4-flow bash -c "NB=16 STAGES=4096 bash run.sh"(脚本内顺序执行 flat、hierarchical 冷构建,各计时 verilator 与 make 两阶段,并追加touch top.v、touch bigblock.v两次增量计时)
代码获取
完整工程(RTL 生成器、块配置、testbench、对比脚本)已同步到公开仓库:geek-doc.cn/experiments/flow-verilator-hierarchical,克隆后进入该目录,执行 docker run --rm -v "$PWD":/work -w /work geek-eda:0.4-flow bash run.sh 即可复现全部计时;换规模用 NB=8 STAGES=2048 bash run.sh,本机直装 Verilator 5.x 时执行 bash run.sh,注意 Debian 打包版需自行补 verilator_bin 符号链接。
这一篇在知识体系里的位置
- 不分块的标准编译四步与 testbench 写法:Verilator --cc 编译仿真全流程;
- 把分块编译挂进团队回归:Verilator 接入 CI 流程;
- 配置文件里另一类常见声明(局部关告警):Verilator lint 入门流程。
总结
Verilator 层次化编译在 5.020 上的最小形态是:命令加 --hierarchical,再用首行为 `verilator_config 的 .vlt 文件以 hier_block -module "名字"; 声明块边界;make 阶段逐块调起 verilator 子进程,把每个块编成独立的 LibWrap 包装与 lib*.a,顶层只编包装再链接,testbench 完全无感。真机 200 万触发器设计上冷构建从约 23.9 秒降到约 19.4 秒,仿真输出逐位一致;收益主要来自块级 Verilation 并行与重复实例共享块库,结构异质的大顶层比同构复制更受益。限制要记牢:顶层不能标块、模块名必须加引号、大循环要抬 --unroll-count、Debian 包需补 verilator_bin 链接,且 5.020 的 hier makefile 依赖粒度粗,动一个源文件会全链重 Verilation——它是为冷构建与工程拆分准备的开关,不是小改快迭代的银弹。