FPGA 进阶 32:高层次综合 HLS 入门——C/C++ 到 RTL
本文是
fpga/进阶层第 36 篇。HLS(Vivado HLS / Vitis HLS)让 C/C++ 算法自动综合成 RTL IP。接口对接靠 AXI4-Stream/Lite,导出后在 块设计里当普通 IP 用;优化指令深入见下一篇 HLS 优化。
本文要回答的问题
- HLS 把什么变成什么?顶层函数、接口怎么映射?
- 为什么说"还在设计硬件"?流水/展开/分区指令干什么?
- HLS 的开发和验证流程?
- 什么模块适合 HLS、什么必须手写 RTL?
一、HLS 的基本映射
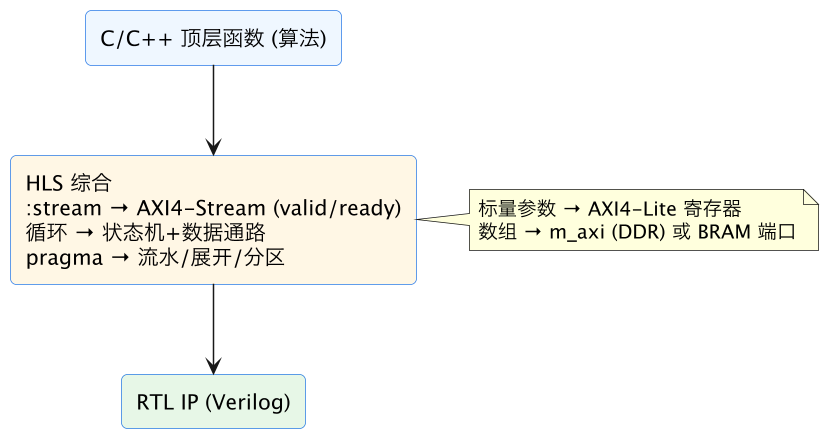
| C/C++ 写法 | 综合成的硬件 |
|---|---|
| 顶层函数 | 一个硬件模块(IP) |
| 标量参数(配置/控制) | AXI4-Lite 控制寄存器 |
| 数组参数 | AXI4 主机口(m_axi,搬 DDR)或 BRAM 端口 |
hls::stream<T> | AXI4-Stream(valid/ready 流) |
| 普通循环 | 串行:一个运算单元反复用,II = 循环体延迟 |
#pragma HLS PIPELINE | 循环迭代重叠流水,II → 1 |
#pragma HLS UNROLL | 循环展开:复制运算单元,全并行 |
ARRAY_PARTITION | 数组拆成多块 BRAM/寄存器,解除访存瓶颈 |
DATAFLOW | 函数/循环间乒乓/流式并行 |
II(Initiation Interval,启动间隔):每多久能接受一个新输入,是 HLS 最核心的性能指标——II=1 表示每周期一个,流水打满。
二、一个最小例子
// 流式 FIR:每来一个样本,输出一个结果
void fir_top(hls::stream<data_t> &src,
             hls::stream<data_t> &dst,
             const coef_t coeffs[N]) {
  #pragma HLS INTERFACE axis port=src
  #pragma HLS INTERFACE axis port=dst
  #pragma HLS INTERFACE s_axilite port=coeffs bundle=config
  #pragma HLS ARRAY_PARTITION variable=coeffs complete

  static data_t shift[N];
  #pragma HLS ARRAY_PARTITION variable=shift complete

  data_t x = src.read();
  acc_t acc = 0;
  #pragma HLS PIPELINE II=1
  for (int i = N-1; i > 0; i--) shift[i] = shift[i-1];
  shift[0] = x;
  for (int i = 0; i < N; i++) acc += shift[i] * coeffs[i];
  dst.write((data_t)acc);
}要点:stream 做 AXI-Stream、系数走 axilite 配置、数组 complete 分区成寄存器、循环 PIPELINE II=1 打满流水——综合后就是一个每周期出一个结果的 FIR 核,等效手写转置型 FIR。
三、开发验证流程
- C/C++ 写算法 + C testbench:先纯软件仿真(csim)把功能和定点调对(定点化见定点 DSP 设计);
- 加接口/优化指令:定接口类型、PIPELINE/UNROLL/PARTITION/DATAFLOW;
- 综合(synthesis):看报告——Latency/II、LUT/FF/BRAM/DSP、接口波形;不达标改代码迭代;
- C/RTL 协同仿真(cosim):C testbench 驱动综合出的 RTL 跑周期级仿真,验证流水/握手/时序行为;
- 导出 IP(package):生成可在 Vivado 块设计里例化的 IP,与手写 RTL/PS 对接;
- 上板:ILA 抓数与 C 参考模型比对。
四、适用边界:HLS vs 手写 RTL
| 适合 HLS | 适合手写 RTL |
|---|---|
| 算术密集算法(滤波/FFT/矩阵/图像/AI) | 底层接口(DDR 控制器、SerDes、源同步) |
| 参数/位宽经常迭代 | 精确周期控制的状态机 |
| 有 C 参考模型、算法团队软件背景 | 资源/时序要抠到极限 |
| 数据流规整、可流水/并行 | 特殊复位/跨时钟/定制协议 |
工程主流是混合:数据通路算法核用 HLS(AXI-Stream 流式),控制、接口、胶水逻辑手写 RTL,在块设计里拼装。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 以为写 C 就自动快 | 综合出串行慢电路 | 主动加 PIPELINE/UNROLL |
| 流数据用数组经 DDR 绕 | 延迟大、带宽浪费 | hls::stream + AXI-Stream |
| 大数组不分区 | 存储端口成瓶颈、II 上不去 | ARRAY_PARTITION/RESHAPE |
| 只看 C 仿真就上板 | 接口/流水行为没验证 | 必跑 C/RTL cosim |
| 循环里有不确定退出(while 等) | 综合困难/性能不可控 | 尽量定界循环 |
| 动态内存/指针乱飞 | 不可综合 | 用数组/stream、定址访问 |
| HLS 写底层状态机 | 可读性/可控性差 | 该手写就手写 |
相关与延伸
前置:AXI4-Stream 与 Lite、块设计 IP Integrator、定点 DSP。 优化深入:HLS 优化 pipeline/unroll/dataflow;取舍深论见专家层《HLS 与手写 RTL》。
一句话总结
HLS 把 C/C++ 顶层函数综合成 RTL IP:标量参数→AXI4-Lite 配置寄存器、数组→m_axi 搬 DDR 或 BRAM 口、hls::stream→AXI4-Stream 流接口、循环→数据通路+状态机。核心认知是"仍在设计硬件":普通循环默认串行(II=循环体延迟),要性能必须显式加指令——PIPELINE 让迭代重叠(II→1,每周期一个样本)、UNROLL 展开复制运算单元、ARRAY_PARTITION 拆存储解除访存瓶颈、DATAFLOW 让任务级并行。流程:C 仿真调功能定点 → 加指令综合看 II/资源报告 → C/RTL 协同仿真验证真实 RTL 行为 → 导出 IP 进块设计与手写 RTL/PS 拼装上板。适合算术密集、迭代快的算法核;底层接口、精确时序、资源极限场景仍手写 RTL。