UVM packer 与 field automation:pack/unpack 字节序与位宽坑
更新时间:2026-09-28。事务对象(transaction)在 scoreboard 里比的是字段,在总线上跑的是比特——把字段翻成比特流再翻回来,靠的就是
uvm_packer。字段自动化宏(field automation macro)的 copy/print/clone 副作用 大家讲得比较多,这一篇只讲它最不起眼也最容易踩坑的那一路输出:pack/unpack。序列化结果常用于 UVM scoreboard 的 trace 对齐与日志比对,两篇可对照。
本文要回答的问题
`uvm_field_int这类宏除了注册 print/compare,是怎么把字段挂进 packer 的?pack、pack_bytes、pack_ints三个入口出来的字节序/位序分别长什么样?- 字段位宽不是 8 的整数倍(比如 13 位、packed struct 里夹着 1 位 flag)时,流里会多出哪些「看不见的位」?
- 什么时候必须甩开宏,自己写
do_pack/do_unpack?
一、field automation 宏在 packer 一侧做了什么
事务类里常见的写法:
class axi_txn extends uvm_sequence_item;
  rand bit [31:0] addr;
  rand bit [63:0] data;
  rand bit [3:0]  strb;
  rand bit        last;

  `uvm_object_utils_begin(axi_txn)
    `uvm_field_int(addr, UVM_ALL_ON)
    `uvm_field_int(data, UVM_ALL_ON)
    `uvm_field_int(strb, UVM_ALL_ON)
    `uvm_field_int(last, UVM_ALL_ON)
  `uvm_object_utils_end
endclass
`uvm_field_int 展开后不止注册 compare/print/copy,还注册了一组 __m_uvm_field_automation 钩子,其中就包括:当有人调用 uvm_object::pack() 时,基类内部的 packer 遍历所有打开 UVM_PACK 标志的字段,按注册顺序、按「高位在前」的约定把每个字段的比特推进 uvm_packer 的位缓冲 m_bits[] 里。flag 集合里的 UVM_ALL_ON 默认就含 UVM_PACK;写成 `uvm_field_int(x, UVM_ALL_ON | UVM_NOPACK) 就能把这个字段排除在序列化之外——「只对齐不比对」的调试字段常用这一招。
注册顺序即打包顺序。这是宏方案第一个隐性契约:宏自上而下写,pack 出的流里 addr 在前、last 在后。如果接收端(比如一个 C 侧 checker 经 SystemVerilog DPI 与 C/C++ 集成 解包)按别的顺序解析,两边字段全错位,但每个字段单独看又都是「合法值」,这种错最难查。
二、三个 pack 入口的位序与字节序
uvm_object 提供三个打包入口,共享同一个 packer,只是最后的切片单位不同:
| 入口 | 返回类型 | 切片单位 | 空位处理 |
|---|---|---|---|
pack(ref bit b[]) | 位流长度 | 1 bit | 无填充 |
pack_ints(ref int u[]) | int 数组 | 32 bit | 高位补 0 到 32 的倍数 |
pack_bytes(ref byte unsigned b[]) | 字节数组 | 8 bit | 高位补 0 到 8 的倍数 |
三个入口都遵循 UVM 的 big-endian 约定:第一个字段占据流的最高有效位(MSB)一侧,最后一个字段在最低位。以 pack_bytes 为例,上面那笔事务总位宽 32+64+4+1 = 101 位,补到 104 位 = 13 字节,addr 的 bit 31 落在 b[0] 的 bit 7,last 落在 b[12] 的 bit 2,末尾 3 个低位是补 0。下图把这笔事务 pack 成字节流再 unpack 回来的完整流向画出来:
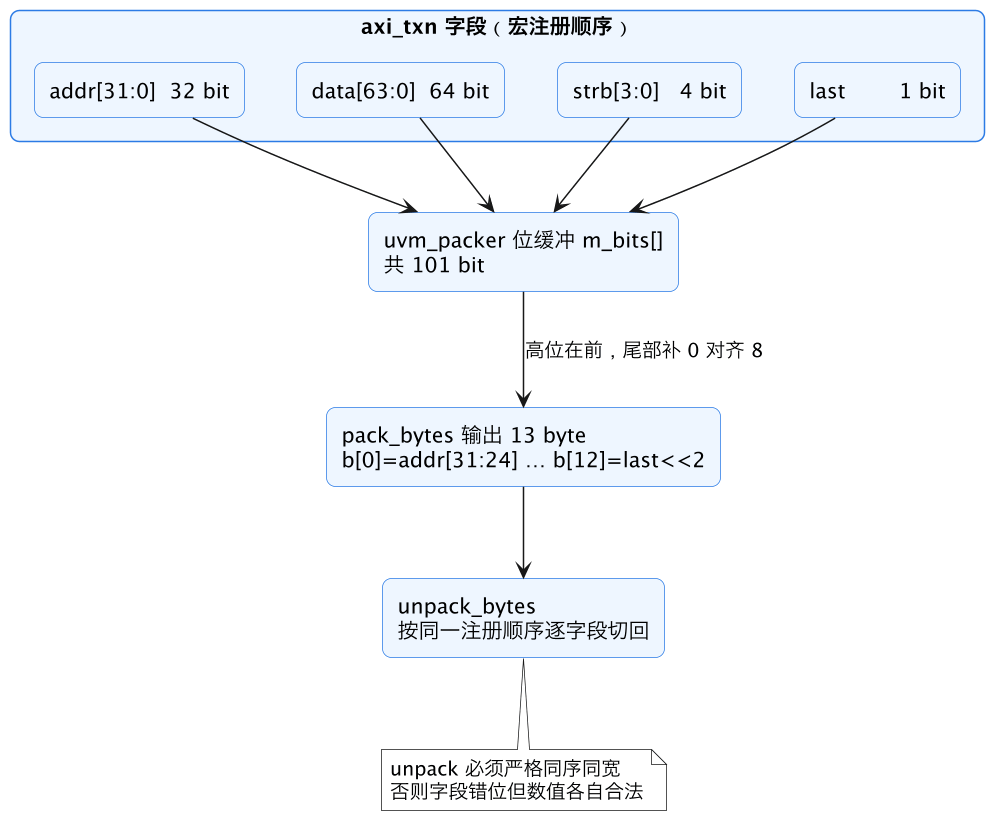
读图抓住两条线:一是宏注册顺序决定流布局,二是尾部补 0 只发生在最后切片那一下。中间字段之间没有任何对齐——strb 的 4 bit 紧贴着 data 的最后一位,last 紧贴 strb。packer 不关心字节边界,只关心位。
为什么 UVM 坚持 big-endian 而不是跟随 x86 服务器上更常见的小端?因为序列化流的消费方多半不是本机内存,而是「线上协议」与「跨语言工具」:协议手册按 MSB 在左画时序图,网络字节序(network byte order)也是 big-endian,DPI 另一侧的 C 结构体 dump 出来同样按高位在前读才直观。packer 选定这个约定后,流里第 0 个比特永远是「第一个字段的最高位」,无论你在哪种切片单位下取,解释都一致。记住这条,后面所有错位问题都能归结为「某一侧没遵守同一个约定」。
还有一个常被问到的问题:pack 出来的流能不能跨仿真器、跨版本直接存盘复用?答案是「同一套类定义下可以,换了类定义就作废」。流里不携带任何字段名、位宽等元信息——它就是一个裸位串,解释权完全在 unpack 那一侧的类定义里。这也是为什么把 pack 结果写进回归基线(golden file)时,必须连同事务类的版本一起管理,字段增删一次,历史基线全部失效。
三、位宽不整除 8 的真实坑
正因「中间字段不对齐」,位宽不是 8 的倍数时会出现三类高频事故。
事故一:和 RTL 时序图对不上。 很多总线协议手册画的是「字段从字节边界开始」的结构体(C 风格 packed struct 带 padding),而 packer 是纯位流。假设协议头实际线上是 cmd[3:0] 占低半字节、len[3:0] 占高半字节组成一个字节,你在类里把 cmd、len 都声明成 bit [3:0] 并按 cmd→len 顺序打宏,pack 出来 len 在高半字节、cmd 在低半字节——恰好和线上反了。修复不是改协议,而是调整宏注册顺序,让先进入流的字段对应线上高位的那个。这类问题只有在把 pack 结果和示波器/协议分析仪抓的原始字节并排比对时才暴露,靠 UVM report 与 verbosity 控制 把 pack 前后的 %p 打到 UVM_HIGH,是排查的第一步。
事故二:unpack 宽度漂移。 unpack 按字段声明宽度从流里切位。若对端改了一处字段宽度(比如 strb 从 4 位扩到 8 位)而只改了一侧代码,之后的所有字段集体左移 4 位,事务内容面目全非却没有任何报错——每个字段切到的都是「位」,位不会喊疼。防御做法是在事务里塞一个 8/16 位的 magic 字段和长度字段,unpack 后先校验,错位立刻 fatal。
事故三:pack 与 pack_bytes 混用。 驱动侧用 pack(纯位流)写进位宽刚好的 DPI buffer,监测侧用 pack_bytes 记录到日志,两者末尾对齐不同,直接 == 比较永远不等。比较序列化结果前先统一入口,或者都先转 bit[] 再比。
四、什么时候甩开宏写 do_pack
宏方案覆盖标量整数字段很舒服,但遇到下面几类字段就得自己接管:
| 场景 | 宏为什么不够 | do_pack 写法要点 |
|---|---|---|
| 动态数组 payload | `uvm_field_sarray_int 只管定长;队列/动态数组长度是运行时量 | 先 packer.pack_field_int(payload.size(), 32) 写长度,再循环逐元素 pack_field_int |
| 嵌套对象 | 宏对 class 句柄字段不递归 pack | 在 do_pack 里调用子对象自己的 pack(packer),do_unpack 里对应 unpack |
| 需要小端或字节内位翻转 | 宏只走 big-endian 位流 | do_pack 里手工按字节构造,或 pack 后整体按字节倒序 |
| CRC/校验和依赖前面内容 | 宏按字段顺序逐个推,算不了「看全流再定值」的字段 | do_pack 尾部基于 packer 已有内容计算后写入 |
自定义 do_pack 的骨架:
virtual function void do_pack(uvm_packer packer);
  super.do_pack(packer);                          // 宏字段照旧
  packer.pack_field_int(payload.size(), 32);      // 长度头
  foreach (payload[i])
    packer.pack_field_int(payload[i], 8);         // 每字节一个字段宽
endfunction

virtual function void do_unpack(uvm_packer packer);
  int unsigned n;
  super.do_unpack(packer);
  n = packer.unpack_field_int(32);
  payload = new[n];
  foreach (payload[i])
    payload[i] = packer.unpack_field_int(8);
endfunction两条铁律:do_pack 与 do_unpack 的顺序、宽度必须逐字镜像;调用 super.do_pack 与否要与宏注册策略一致——一旦写了 do_pack,宏那一套仍然有效(super 会走它),别在 do_pack 里把宏已打的字段再手工打一遍,否则流里每个字段出现两次,unpack 时第二次的值覆盖第一次,现象是「字段值翻倍出现、后半截字段全是别人」。
另外一个容易忽略的点:uvm_packer 默认有最大位流长度限制(UVM_MAX_PACKED_BITS,老版本常见 4096)。大 payload 事务 pack 到一半被截断,unpack 静默拿到半包数据。处理办法是调大 packer.set_max_packed_size(),或者干脆绕开 packer、用 DPI 侧自建 buffer。事务类的深拷贝语义与这部分的关系,可回看 SystemVerilog 对象拷贝:深拷贝与浅拷贝。
最后再给一个落地建议:凡是需要跨组件传递的序列化事务,把「pack 入口、字段顺序、总位宽」三件事写进类的注释头,并在 base test 里加一条一次性自检——构造一笔已知值的事务,pack 后与手工计算的期望位流比较。这条检查仿真零时刻就跑完,成本几乎为零,却能在类定义被后续改动悄悄破坏时第一时间报警,比回归跑飞后从 scoreboard mismatch 倒推省几个小时。
这一篇在知识体系里的位置
- 上游:SystemVerilog 数据类型:packed 与 unpacked 讲位在类型层面的排布,是理解 packer 位流的前置。
- 同窗:SystemVerilog DPI 与 C/C++ 集成 是 pack 结果跨语言消费的典型通道;UVM scoreboard 的 trace 对齐与日志比对 消费序列化输出做端到端核对。
- 平台层:事务类的工厂注册与宏体系见 UVM factory 与 env 派生。
总结
UVM packer field automation 的本质是:宏按注册顺序把字段以「高位在前」的位流推进 packer,pack/pack_ints/pack_bytes 只在最后切片时对齐;守住「注册顺序即协议布局、do_pack/do_unpack 逐字镜像、位宽不齐时先校验 magic、比较前统一入口」四条线,字节序错位和静默截断这类最阴的序列化 bug 就都拦得住。