TTFT 排队模型:prefill 队列的 M/G/1 近似、SLO 分位数与容量规划表
更新时间:2026-10-06。TTFT(Time To First Token,首 token 延迟)是用户对一个 LLM 服务「快不快」的第一印象,站内 LLM 服务 TTFT 与 TPOT SLO 讲了指标定义与验收口径。这篇往下钻一层:TTFT 的大头往往不是 prefill 计算本身,而是请求在 prefill 队列里的等待。等待时间服从排队论的规律——它随利用率的上升不是线性而是发散的,这就是「平均负载只有六成,P99 TTFT 却炸了」这类事故的理论根源。本文用 M/G/1 模型把这件事量化,最后落到一张可以直接查的容量规划表。
本文要回答的问题
- prefill 队列为什么可以用 M/G/1 近似,近似的误差从哪来?
- 利用率和 TTFT 各分位数的关系曲线长什么样,拐点在哪里?
- prompt 长度的离散分布如何进入服务时间项,为什么长 prompt 的破坏力是平方级?
- 给定 SLO(比如 P99 TTFT 小于 2 秒),怎么反推出一个 prefill 池能扛多少 QPS?模型上线后又该盯哪些信号、按什么节奏重估参数?
先给本文的核心结论一个预告:排队系统的等待时间随利用率发散而非线性增长,所以 TTFT 容量的运营哲学是「用冗余换分位数」,不是「用满利用率换成本」。
一、为什么是 M/G/1:prefill 队列的排队论建模
把一个 prefill 节点(或一个 prefill 池)抽象成排队系统:请求按某种随机过程到达,服务台是 GPU 的 prefill 执行单元,服务时间是这条请求的 prefill 耗时。排队论的标准记号里,M/G/1 表示:到达是泊松过程(M,无记忆性,API 型流量很接近)、服务时间是任意分布(G)、单服务台(1)。
为什么到达可以当泊松?生产网关日志里,独立用户发起的 API 请求到达间隔普遍接近指数分布——这是大量独立源叠加的经典结论。突发性的批量任务(定时任务一次性打几千条)不服从泊松,这类流量应该单独建模或用削峰队列隔离,不能和交互流量混在同一个模型里。验证方法也简单:对到达间隔做一次指数分布的拟合优度检验,或者直接看间隔的变异系数——泊松到达的间隔变异系数恒等于 1,明显小于 1 说明流量被上层限流器整形过(更平滑,对排队是好事),明显大于 1 说明有突发成分(要单独处理)。
为什么服务时间必须是 G 而不能简化成 M(指数分布)?因为 prefill 耗时的分布形状由 prompt 长度分布决定,而真实负载的 prompt 长度是高度离散的:几百 token 的闲聊和几十 k token 的文档问答混在一起,服务时间方差极大。M/G/1 相对 M/M/1 的全部价值,就是把这个方差项保留下来——后面会看到,方差是以平方项进入等待时间的。
模型的边界也要说清楚:连续批处理(连续批处理调度器)让 prefill 并不是严格的「一次服务一条」,而是 chunked prefill 下多个请求拼批服务,见 chunked prefill 与 PD 分离。严格建模应该用批服务排队模型,但 M/G/1 在「把拼批折算成有效服务率」之后是足够好的工程近似——误差通常在 20% 以内,而排队现象本身是非线性的,20% 的参数误差不改变结论的形态。

上图是建模的总览。三个组件对应三个可测量:到达率 lambda 从网关日志数,服务时间 S 的分布从引擎的 prefill 计时采,利用率 rho = lambda × E[S] 是两者的乘积。整篇的推理都挂在这三个量上。
再把一条请求的生命周期纵向展开成漏斗,看清 TTFT 究竟在哪一段被拉长:
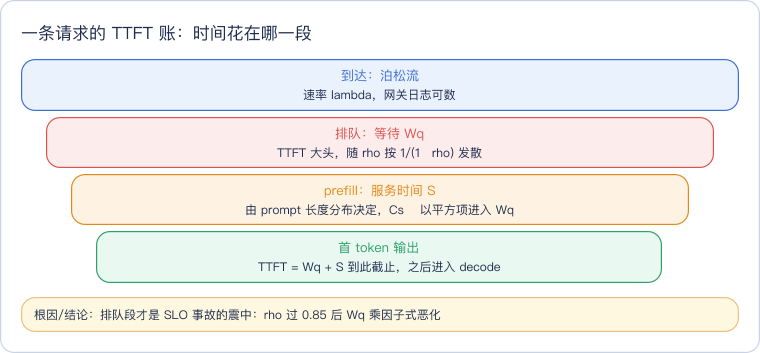
这张漏斗的收窄方向就是时间被消耗的方向:到达段不花时间,prefill 段花的是一个可预测的量(长度拟合可得),唯独排队段是个随利用率非线性膨胀的无底洞。后面 PK 公式的全部价值,就是给中间这一段的膨胀速度一个定量刻度。
多实例的情况怎么处理?严格的模型是 M/G/c(c 个服务台),但 M/G/c 没有 PK 公式这样的闭式解,工程上有两个近似套路。其一是折算成单台:如果负载均衡做得好,c 个 prefill 实例近似等价于一个服务率快 c 倍的服务台,用 M/G/1 算、把 E[S] 除以 c——这个近似在低利用率区偏悲观(高估等待)、高利用率区相当准,容量规划用它偏保守,是安全的方向。其二是每实例独立建模:把总流量除以 c 后对单实例用 M/G/1,这要求路由器确实把流量打散均匀——如果路由是缓存感知的(把同前缀请求粘到同实例),各实例负载会偏斜,独立建模会低估热点实例的排队。两个套路的选取取决于你的路由策略,这和 LLM 路由负载均衡 里讨论的路由局部性是同一个硬币的两面。
二、PK 公式:利用率与等待时间的非线性关系
M/G/1 的核心结果是 Pollaczek-Khinchine 公式(PK 公式)。平均排队等待时间:
E[Wq] = rho × E[S] × (1 + Cs²) / (2 × (1 − rho))
其中 rho 是利用率,Cs² 是服务时间的变异系数平方(方差除以均值平方)。这个公式里有三个信息,一个比一个重要。
第一,等待时间随 1/(1−rho) 发散。rho 从 0.5 涨到 0.9,分母从 0.5 缩到 0.1,E[Wq] 放大 5 倍;rho 到 0.95 再翻一倍。这就是为什么「加一点点流量,TTFT 就崩」——不是系统变脆了,是你沿着一条双曲线在走。
第二,服务时间方差以 (1 + Cs²) 进入。prompt 长度分布越散,Cs² 越大,同样的平均服务率下等待时间越长。一个 Cs²=0.2 的均匀负载和一个 Cs²=2 的混合负载,同样的 rho 下后者平均等待是前者的 2.4 倍。长 prompt 的破坏力因此是平方级的:它既抬高 E[S],又抬高 Cs²,两项相乘。
第三,分位数比均值更陡。PK 公式给的是均值,P99 等待在 heavy-tailed 服务时间下比均值恶化得更快——经验上 P99/P50 的比值在 rho 0.8 以上能到 10 倍开外。SLO 是按分位数定的,所以容量规划不能拿均值公式直接套,要在分位数上留更大的利用率余量。
代入一组具体数字感受一下。E[S] = 0.4 秒、Cs² = 1(服务时间接近指数分布的散布程度):rho = 0.7 时 E[Wq] = 0.7 × 0.4 × 2 / (2 × 0.3) ≈ 0.93 秒,已经是服务时间的两倍多;rho 涨到 0.85,E[Wq] ≈ 0.85 × 0.4 × 2 / (2 × 0.15) ≈ 2.27 秒——利用率只涨了 21%,平均等待翻了 2.4 倍,而这还只是均值,P99 通常再乘 3 到 5。这组数字解释了生产上最常见的困惑:「CPU 式思维」里 85% 利用率还很健康,在排队系统里 85% 已经是尾延迟事故的前夜。排队系统的设计哲学是用冗余换分位数,不是用满利用率换成本。

上图把 PK 公式的非线性翻译成四个水位(Cs² 取 1 的估算值)。读法很直接:利用率每上一个台阶,等待时间不是加一个量级而是乘一个因子。运营纪律就一条——常态水位压在 rho 0.7 以下,0.7 到 0.85 是留给流量峰值的缓冲区,超过 0.85 必须有自动扩容或降级预案接住,扩缩容机制见 LLM 服务 autoscaler 与 HPA。
三、把 prompt 长度分布代进去:服务时间项怎么估
E[S] 和 Cs² 都要从真实负载估。做法分三步。
第一步,从日志采 prompt 长度直方图,按 token 数分桶(0-512、512-2k、2k-8k、8k-32k、32k 以上),算出每桶占比。注意要按「请求数」加权而不是按「token 数」加权——排队模型里每条请求是一个顾客。
第二步,把长度换算成 prefill 服务时间。单条 prefill 耗时近似 = 长度 × 每 token 算力需求 / 有效算力, chunked prefill 下则是「这条请求的长度 / 每步 token 预算 × 每步时长」。用引擎实测的 prefill 计时对几个代表长度做线性拟合就够,prefill 的二次方注意力项在 32k 以内通常被 GEMM 的线性项盖住,线性近似可用;超长上下文要单独加二次项修正。拟合时还要顺手处理一个混杂因素:命中前缀缓存的请求 prefill 时间大幅缩短,这类请求应该在直方图里单列一桶(服务时间按未命中部分的长度算),否则缓存命中率的波动会让 E[S] 跟着漂,前缀复用的机制见 前缀缓存与 prompt 复用。
第三步,从长度分布算 E[S] 和 Cs²。E[S] 是各桶服务时间按占比加权;Cs² 用同样的权重算方差再除以均值平方。这里有个高频错误:用「平均 prompt 长度」估算 E[S] 再假设 Cs²=0——这等价于假设所有请求一样长,会把等待时间低估 2 到 5 倍。混合负载的 Cs² 实测普遍在 0.5 到 2 之间,绝不能当零。

上图是参数估计的流水线。三步里第一步最脏但最值钱——很多团队的容量模型出错,不是排队论用错了,而是长度直方图用了上个季度的,流量结构已经变了。
还有一个参数估计的陷阱藏在服务时间的定义里。排队模型里的 S 是「这条请求独占服务台的时长」,但 chunked prefill 下一条长请求是分多个 step 服务的,中间还穿插着 decode 批次——它的「独占时长」其实是各个 chunk 服务时间的总和,而 chunk 之间的等待(被 decode 和其他 prefill 挤占的时间)应该算进 Wq 还是 S,取决于你建模范式的选择。工程上最干净的处理是把服务台重新定义成「prefill token 预算的分配器」:服务时间 = 请求长度 / 每步 prefill 预算 × step 周期,排队等待 = 从到达到第一个 chunk 被调度的时间。这样 S 和 Wq 都从引擎的调度日志直接可取,不用做哲学区分。模型验证也很简单:在流量平稳时段,用实测的 rho 代入 PK 公式算 E[Wq],和日志里的实测平均等待对一下,偏差在 20% 以内说明参数可信;对不上优先怀疑 Cs²——它是最难估准、又对结果影响最大的参数。
四、从 SLO 反推容量:一张可以直接查的表
现在把链条完整走一遍:SLO 给定 P99 TTFT 上限,反推允许的 rho 上限,再反推 QPS 上限。这套反推是容量规划里最常用的一次计算,值得把它做成团队共享的小工具而不是每次手算。步骤:
- 把 SLO 拆账:P99 TTFT 上限减去 P99 服务时间(纯 prefill),剩下的就是 P99 Wq 预算。比如 SLO 2 秒、P99 prefill 0.8 秒,Wq 预算 1.2 秒。
- 用 PK 公式(分位数版,或用均值版乘经验分位系数 3 到 5)反解 rho 上限。
- QPS 上限 = rho 上限 / E[S]。多实例则乘以实例数——但注意 PD 分离下 prefill 池的实例数才是分母,见 服务容量规划 的整体框架。
下面这张表用一组典型参数(E[S]=0.4 秒,Cs²=1,P99 系数取 4)算出不同 SLO 下的容量上限,用法是替换成你自己的 E[S] 和 Cs 重新算一遍:
| P99 TTFT SLO | Wq 预算 | rho 上限 | 单实例 QPS 上限 | 体感 |
|---|---|---|---|---|
| 1 秒 | 0.2 秒 | 约 0.2 | 0.5 | 极宽松 适合演示 |
| 2 秒 | 1.2 秒 | 约 0.55 | 1.4 | 在线服务典型 |
| 5 秒 | 4.2 秒 | 约 0.8 | 2.0 | 吞吐优先可接受 |
| 10 秒 | 9.2 秒 | 约 0.9 | 2.25 | 接近极限 P99 抖动大 |
表的最后两行是重点:放松 SLO 换来的 QPS 是边际递减的——从 5 秒放到 10 秒,QPS 只多 12.5%,但 P99 的抖动和尾延迟事故率大幅上升。理性的运营点在第二、三行之间,再配合削峰(排队上限、优先级调度,见 请求优先级与抢占)把超过水位的流量显式拒掉或降级,而不是让它在队列里把全体请求的 TTFT 一起拖垮。排队的另一面是吞吐曲线,batch 与延迟吞吐曲线 从调度器视角讲了同一件事。
模型上线后的运维动作有三个。第一,把 rho 做成实时监控指标:用滑动五分钟窗口算 lambda × E[S],它是比 GPU 利用率更早的容量预警信号——GPU 利用率升高时排队已经在恶化,而 rho 的上升趋势提前半个台阶就能看到。第二,定期重估 Cs²:流量结构漂移(新上线的长文档功能、批量任务混入交互池)首先反映在 Cs² 上,建议按周从日志重算,Cs² 上跳 30% 就该触发容量复算。第三,大促或活动前做压力推演:把预估峰值 lambda 代入公式算 P99 TTFT,如果超 SLO 就提前扩容或准备降级开关,不要等到当天靠 autoscaler 追——prefill 实例的扩容有权重加载和 CUDA Graph 预热成本,追不上陡峭的流量前沿。成本侧的账——多留多少冗余实例划不划算——在 LLM 服务成本模型 TCO 里有完整框架。
这一篇在知识体系里的位置
本篇是服务质量专题的建模篇:指标定义在 LLM 服务 TTFT 与 TPOT SLO;模型输出的参数喂给 服务容量规划 和 LLM 服务 autoscaler 与 HPA;改善排队结构的技术手段在 连续批处理调度器、chunked prefill 与 PD 分离 和 请求优先级与抢占;成本侧的权衡在 LLM 服务成本模型 TCO。
总结
TTFT 的大头是 prefill 队列的等待时间,用 M/G/1 加 PK 公式可以定量:等待随利用率按 1/(1−rho) 发散、随服务时间方差按 (1+Cs²) 放大,长 prompt 因此有平方级破坏力;容量规划的正确顺序是从日志采长度直方图、拟合长度到服务时间、合成 E[S] 与 Cs²,再从 SLO 拆出 Wq 预算反解 rho 上限和 QPS 上限;运营纪律是常态水位压在 rho 0.7 以下、0.85 以上必须有扩容或降级预案,放松 SLO 换来的 QPS 边际递减,理性的做法是用削峰和优先级调度守住水位而不是放任队列发散。