时钟 mesh 与树:偏差、功耗与适用场景的三角权衡
时钟分配网络(clock distribution network)是芯片里功耗最大、对时序最敏感的一张网。主流做法是 CTS 时钟树综合 讲过的 clock tree:从时钟根逐级 buffer 扇出到每个触发器。但在 GHz 级 CPU、GPU 这类对偏差(skew)极度敏感的设计里,纯树往往压不住 OCV(on-chip variation,片上工艺波动)带来的偏差,于是出现了 clock mesh 和介于两者之间的 fishbone(鱼骨)混合结构。本篇把三种结构放在一起比:偏差能压到多少、功耗要多付多少、鲁棒性差异在哪,以及什么场景该选哪一种。
本文要回答的问题
- clock tree、clock mesh、fishbone 三种时钟结构在拓扑上分别长什么样?
- 为什么 mesh 能把 skew 压到最小,代价又是什么?
- fishbone 混合结构是怎么在树和 mesh 之间取折中的?
- 面对一个新模块,按哪些判据决定用哪种时钟结构?
一、三种结构的拓扑对比
先从拓扑上看三者的本质区别:
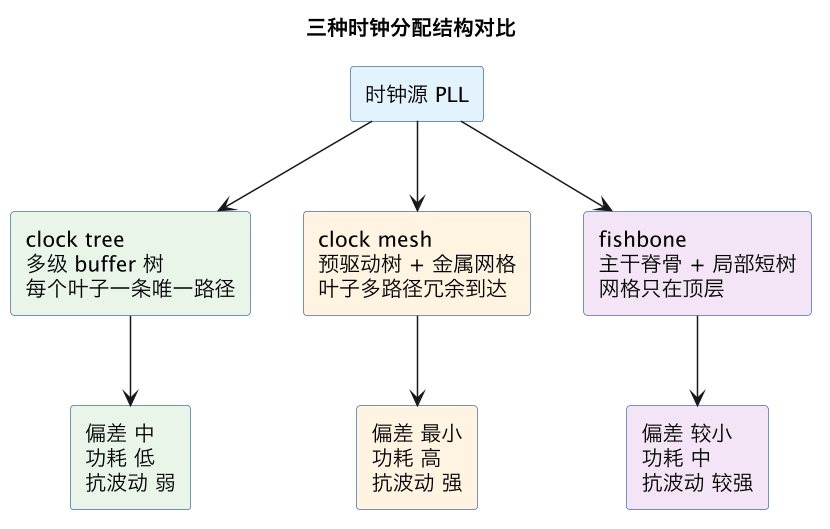
上图概括了三条路线的核心取舍。clock tree 是严格的树形:时钟从根到每个触发器只有一条路径,buffer 逐级平衡插入延迟。结构简单、总线长短、功耗最低,但每条路径独立,任何一段路径上的工艺、电压、温度波动都会直接变成两两触发器之间的 skew。
clock mesh 在树的前端加了一层「冗余」:一棵较短的预驱动树(pre-driver tree)把时钟送到分布在芯片各处的网格驱动器(mesh driver),这些驱动器共同驱动一张覆盖整个时钟域的金属网格(grid)。由于网格上任意两点之间存在多条金属通路,每个触发器实际从多个方向同时接收时钟,局部的路径差异被网格「短路均摊」掉了——这是 mesh 抗 OCV 能力强的物理根源。
fishbone(鱼骨结构)则是显式的折中:用少量高层金属走一条或多条「脊骨」(spine),脊骨上按间隔挂驱动点,每个驱动点只带一小片局部子树。网格化只发生在脊骨这一层,局部仍是树。它拿到了 mesh 大部分的偏差收益,又避免了全网格的功耗爆炸。
二、偏差与功耗:一组有代表性的数字
三者的定量差异可以用一张表说清(数字为文献与工业界报告的典型量级,具体随工艺和实现浮动):
| 维度 | clock tree | clock mesh | fishbone |
|---|---|---|---|
| 全局 skew 典型值 | 30–80 ps | 5–15 ps | 10–25 ps |
| 时钟网络功耗 | 基准(1x) | 2–3x | 1.3–1.8x |
| 金属资源占用 | 低 | 极高(顶层几层近乎专供) | 中(脊骨占少量高层) |
| 抗 OCV / 局部 IR drop | 弱,靠 useful skew 与 de-skew 补救 | 强,网格天然均摊 | 较强 |
| 时钟门控粒度 | 细,任意子树可关 | 粗,网格本身常开,门控放叶端 | 中,脊骨下局部可关 |
| 设计/验证成本 | 工具全自动 | 网格需手工或半自动规划,验证复杂 | 介于两者之间 |
| 适用频率 | 中低频域(< 1–2 GHz) | 高频域(多 GHz CPU/GPU 核) | 高频大核 + 分区 SoC |
几个值得展开的点:
- 功耗差距主要来自冗余金属与冗余驱动。mesh 的网格是整张「铁板」,分布电容远大于树;几十上百个 mesh driver 同时开关,短路功耗和漏电都上去。所以 mesh 只用在「偏差换性能划算」的高频核,全芯片铺满 mesh 的设计几乎不存在。
- 时钟门控是 mesh 的软肋。树可以在任意一级子树上插门控单元,空闲时整支砍掉;mesh 的网格是一个电气整体,没法局部关断,门控只能下沉到触发器前一级(leaf-level gating),省功耗的效率明显差。低功耗场景这条常常是决定性因素。
- skew 不是唯一目标。树虽然全局 skew 大,但 STA 工具可以精确建模每条路径的延迟,配合 useful skew 优化 反而能把偏差「用」起来修 setup/hold;mesh 的 skew 小而不可控,留给时序优化的旋钮少,hold 修复(见 STA hold 修复与 buffer 插入)在 mesh 域里反而更难。
- 历史上还有一个过渡形态叫 H-tree:用等长的 H 形分形走线保证根到每个叶子路径长度完全一致,理论 skew 为零。它对版图对称性要求苛刻、绕线资源消耗大,在标准单元自动布局布线的流程里基本被淘汰,只在存储器阵列、模拟时钟分配等高度规整的场景里还能见到。可以把它理解为「靠几何对称消偏差」的纯结构解,而 mesh 是「靠电气冗余均摊偏差」的电气解。
三、mesh 的设计与验证成本为什么高
表里「设计/验证成本」一行值得单独展开,因为它是很多项目放弃 mesh 的真实原因。
树结构是 CTS 工具一键生成的:给定时钟约束和 buffer 库,工具自动插 buffer、做延迟平衡,工程师基本只看报告。mesh 没有这么省事——网格的行列间距、走哪几层金属、mesh driver 摆多少、摆在哪、每个驱动多大尺寸,目前仍依赖工程师手工规划或脚本半自动生成;driver 太少网格驱动不足、太多则功耗白费,调参往往需要几轮迭代。
验证侧更麻烦。树是无环图,每对触发器的 skew 就是两条路径延迟之差,STA 直接算;mesh 是有环的电气网络,严格的 skew 分析要做瞬态仿真或用专门的 mesh 分析工具抽取等效模型,签核收敛慢得多。网格本身还引入新的物理验证负担:大片同电位金属要过电迁移检查,driver 阵列的 IR drop 要单独签核。这些工作量加在一起,决定了 mesh 只配得上「非它不可」的高频核。
四、怎么选:按频率、面积与波动预算决策
工程上的选型逻辑可以归纳成三条判据:
判据一:时钟周期减去时序裕量后,还容得下多少 skew。 假设核跑 3 GHz(周期约 333 ps),setup 检查吃掉一部分、不确定性与抖动吃掉一部分后,留给 skew 的预算可能只有十几 ps——纯树做不到,只能上 mesh 或 fishbone。反过来,一个 500 MHz 的外设子系统,树的 50 ps skew 完全在预算内,上 mesh 就是纯浪费功耗。
判据二:时钟域的面积与形状。 mesh 的收益随驱动点密度和网格完整性变化,小而规整的核(几毫米见方)最适合 mesh;狭长或 L 形的 floorplan 网格覆盖效率差,fishbone 沿长边走脊骨往往更优。这也解释了为什么现代 CPU 常见「核内 mesh/fishbone + 核间树」的分层组合——每个大核自己一张小网格,整个 SoC 层面仍是一棵树在分发。
判据三:电压降与工艺波动强度。 先进节点下局部 IR drop 造成的时钟延迟抖动是 skew 的重要来源。网格的低阻抗特性对电压波动天然不敏感;如果 IR 分析(方法对比见 IR vectorless 与 vector-based)显示时钟域内压降差异大,这是向 mesh/fishbone 倾斜的信号。
落地时的常见实践是:默认全部用树(工具自动 CTS,成本最低),只有 STA 报告显示某个高频域 skew 预算压不住、且功耗预算允许时,才为该域升级为 fishbone;mesh 留给顶级性能核。任何结构变更都要重跑 MMMC 多角分析 确认各 corner 下 skew 与功耗仍达标。
这一篇在知识体系里的位置
- 前置基础:CTS 时钟树综合 讲树的构建流程,本篇讨论「树不够用时的替代拓扑」;
- 优化手段:useful skew 优化 是树结构内挖掘时序裕量的手段,与换结构是互补的两条路;
- 相关检查:时钟门控检查、IR 分析、STA hold 修复 都因时钟结构不同而有不同约束;
- 流程上下文:S4 CTS 与布线、S5 sign-off 收敛。
总结
时钟 mesh 与树的核心权衡是「偏差换功耗」:clock tree 用唯一路径换最低功耗但 skew 大、抗波动弱;clock mesh 用金属网格的多路径冗余把 skew 压到 5–15 ps,代价是 2–3 倍时钟功耗和粗粒度门控;fishbone 以「脊骨网格 + 局部子树」拿到两者之间的大部分收益。选型的本质是看 skew 预算容不容得下树——高频大核、IR 波动大的域升级到 fishbone 或 mesh,其余一切留给工具自动种树。