SGLang RadixAttention:前缀树的插入、驱逐与 LRU 语义全解
更新时间:2026-10-04。前面 prefix caching 提示词复用 讲过「为什么共享前缀能省 prefill」这个概念的收益账本,PagedAttention 与 vLLM serving 讲过 KV cache 怎么按页切块管理。概念都清楚了,但落到工程上还有一个硬问题:成百上千个并发请求的前缀关系错综复杂,谁在什么时候和谁共享了哪一段 KV,这块共享的 KV 什么时候该留、什么时候该扔? SGLang 给出的答案就是 RadixAttention——用一棵基数树(radix tree)把所有请求的 KV cache 前缀组织起来,插入、匹配、驱逐全自动完成。本篇不讲概念收益,专讲这棵树的工程实现细节:节点怎么分裂、LRU 怎么挂在树上、命中率怎么调上去。
本文要回答的问题
- RadixAttention 为什么选基数树而不是哈希表或前缀列表来组织共享前缀?
- 新请求到来时,树怎么做前缀匹配,匹配到的 KV 怎么直接挂进新请求的序列?
- 请求结束后 KV 插入树时发生的「节点分裂」是什么,为什么非分裂不可?
- 显存吃紧时树上的 LRU 驱逐按什么顺序动手,为什么只敢驱逐叶子?
- 线上怎么通过缓存感知调度和参数调整把命中率拉上去?
一、为什么是基数树:前缀共享的天然数据结构
先回顾问题本身。LLM serving 里,大量请求共享前缀是常态:同一个 system prompt 开头的对话、 few-shot 模板里的示例段、多轮对话里每轮都重放的历史。每段共享前缀对应的 KV cache 只需算一次、存一份,后续请求直接复用——这是 prefix caching 的核心收益,TTFT(首 token 延迟)和算力都能省。
难的是管理。朴素做法是哈希表:以「完整前缀 token 序列」为 key 存 KV 指针。但前缀的共享粒度是任意长度的——请求 A 和 B 共享前 1200 个 token,B 和 C 又只共享前 800 个。哈希表要求精确匹配整串 key,要么枚举所有可能的前缀长度(存储爆炸),要么只能命中完全相同的 prompt(命中率惨淡)。另一个朴素做法是存所有历史序列、每次新请求逐个做最长公共前缀比较,复杂度随历史请求数线性膨胀,几千并发下根本不可行。
基数树恰好是为「任意长度的前缀共享」生的。它是一棵压缩过的字典树(trie):每条边携带一段 token 序列(而不是单个 token),从根到任意节点的路径拼起来就是一个前缀;两个序列共享的部分自然落在同一条路径上,分岔点就是它们前缀分叉的位置。查找一个请求的最长已缓存前缀,只需要从根出发做一遍贪心匹配,复杂度是 O(前缀长度),与树里存了多少条历史序列无关。

上图里,system prompt 加 few-shot 示例共 1200 个 token 被请求 A、B 完全共享,树根到分岔点只有一条路径;A、B 各自的用户问题从分岔点伸出两条边。关键认知是:树上的每条边不只是「记录了这段 token 出现过」,而是实打实持有这段 token 的 KV page 引用。命中一段边,等于白拿这段的 KV,prefill 直接从分岔点之后开始算。
二、匹配与复用:新请求怎么「接」到树上
新请求到达调度器时,第一步不是排队,而是拿它的 prompt token 序列去树上做 match_prefix。匹配算法是贪心逐边比较:从根出发,比较请求剩余序列和当前节点各出边的 token 段,哪条边是请求剩余序列的前缀就走哪条;如果请求序列只是某条边的真前缀(比如边上有 688 个 token,请求只覆盖前 600 个),匹配在这条边的中间停下,记为「部分命中」。最终得到「已缓存前缀长度 L」,请求的实际 prefill 只需要从第 L 个 token 开始。
部分命中带来一个实现细节:命中的那一段必须能被单独引用。SGLang 的 KV cache 按 page(页)管理(与 PagedAttention 同源的分配器),如果命中点正好落在页边界,直接引用即可;落在页中间,早期实现按页粒度截断(只对齐到页边界复用,页内尾巴重算),新版本配合分裂逻辑可以做到更细粒度。这也是为什么 SGLang 默认页大小设得比较小——页越小,匹配截断浪费越少,命中率越高,代价是页表管理开销上升,这是个可调的权衡旋钮。
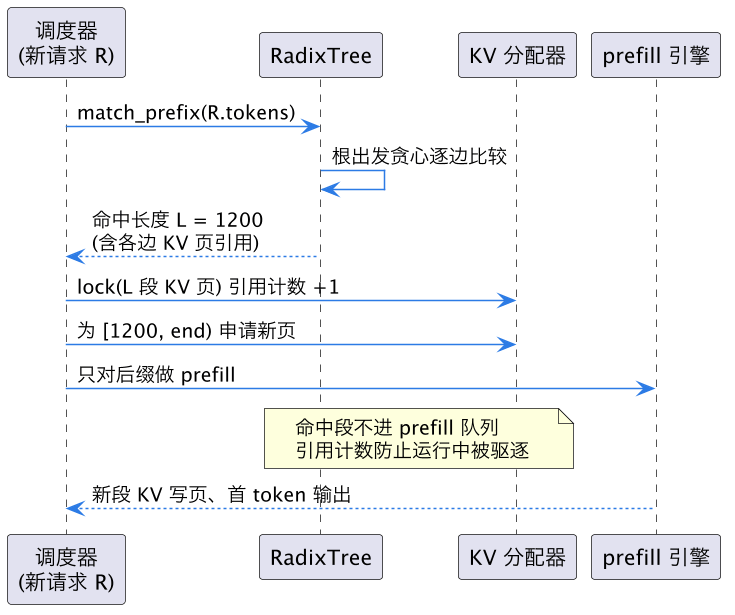
图中还有一个容易被忽略的步骤:lock。匹配成功不等于这段 KV 安全了——请求还要跑很久,期间树可能因为显存压力驱逐节点。所以匹配到的每个页面的引用计数要立刻加一,把它从「可被驱逐」变成「被运行中请求钉住」,直到请求结束释放。引用计数就是 RadixAttention 与驱逐逻辑之间的安全锁。
三、插入与节点分裂:请求结束后 KV 怎么「挂」回树上
请求跑完 decode、释放序列时,它新算出来的那段 KV(从 L 到序列末尾)不能随手一扔——后续请求可能还要共享它。于是调度器执行 insert:拿完整序列再对树做一遍匹配,找到已存在的最长前缀,把剩余部分作为新边挂上去。
最有趣的情形是插入点落在某条边的中间。设想树上有一条边携带 [512, 1200) 共 688 个 token,现在要插入的序列在 800 处与已有路径分叉(前 800 相同,之后不同)。一条边没法同时表达「到 800 分叉」,于是必须节点分裂:把原边在 800 处切成两段,[512, 800) 一段、[800, 1200) 一段,中间新生成一个节点,新序列的分叉边 [800, ...) 从这个新节点伸出。原边持有的 KV 页引用按切分点拆给两段新边。
要强调的工程点是:分裂是纯元数据操作,KV 数据零拷贝。边只是页引用的列表,切分就是把这个列表在对应页边界处拆成两个列表。页大小在这里又一次起作用——如果分裂点落在页中间,粗粒度实现只能对齐到页边界分裂(分岔点前后的少数 token 被并入其中一段,牺牲一点点复用精度);页小则对齐损失小。整棵树的生命周期里,分裂随时发生,树的结构因此持续演化,形态由流量里的前缀分布自然塑造,不需要任何人工配置前缀规则——这正是 RadixAttention 相比「手工配置 system prompt 缓存槽位」方案的本质优势。
多轮对话是插入路径上的高频受益者。第 n 轮请求的 prompt = 前 n-1 轮的完整内容 + 新用户输入,前 n-1 轮部分的 KV 上一轮结束时已经插入树中,本轮匹配直接命中到接近末尾的位置,prefill 只需算新输入那一小段。对话越长,每轮省下的 prefill 越多——这也是为什么 SGLang 在多轮对话 benchmark 上 TTFT 优势特别夸张。
四、LRU 驱逐:只动叶子,引用计数兜底
GPU 显存是有限的,树不可能无限长。当 KV 分配器水位告急(新请求申请不到页),SGLang 触发驱逐:从树上释放一批 KV 页还给分配器。驱逐顺序是 LRU(最近最少使用)——每个节点维护 last_access_time,匹配命中和插入都会刷新路径上节点的时间戳,驱逐器优先挑时间戳最老的节点下手。
但树上有一个硬约束:只能驱逐叶子节点。原因很直白——内部节点如果被驱逐,它的子树还引用着它路径上的前缀语义,路径断裂后子树挂着的所有 KV 都失去意义(前缀没了,后缀的 KV 无法独立被复用,因为复用必须从头匹配)。留着子树指向悬空前缀是错误,连带删除整个子树又太浪费。所以实现上驱逐器只收集叶子,按 LRU 排序逐个释放,直到腾出足够的页。这也意味着热点内部节点天然受到结构保护:共享的人越多、越靠近根,越不可能是叶子,越难被驱逐——高复用前缀的存活期和它的价值自动对齐。

上图总结了驱逐的三条规则:叶子优先、LRU 排序、引用计数兜底。第三条再展开一点:运行中的请求持有的页(引用计数大于零)即使是叶子也不能驱逐,驱逐器会跳过它们。这带来一个水位规划上的推论——可供驱逐的「弹性显存」只是树上未被引用的那部分,如果流量大到运行中请求本身就占满显存,驱逐也救不了,只能排队或拒绝请求。规划显存水位时要把「树上待机缓存」和「运行中刚需」分开算账,前者是可以随时牺牲的加速层,后者是硬底线。
还有一个细节是驱逐与连续批处理的交互。continuous batching 调度器 下请求进进出出,每轮迭代都可能有请求结束(触发插入)和新请求到来(触发匹配),树的操作频率是每调度轮数次。SGLang 把树操作放在 CPU 侧调度器里做,和 GPU 的 prefill/decode 计算重叠,树本身的匹配、插入、分裂、驱逐都是微秒到亚毫秒级的指针操作,不占用 GPU 关键路径——这也是为什么它敢在每一次调度决策前都做一次全量匹配。
五、命中率调优:从缓存感知调度到页大小
树建起来了,怎么让命中率真正上去?SGLang 及工程实践里有四个有效手段。
第一个是缓存感知调度(cache-aware scheduling)。默认的请求调度是 FCFS(先来先服务),但请求间的亲缘关系不同:两个共享长前缀的请求如果紧邻着跑,后一个直接命中前一个刚插入的 KV;如果被调度器隔开很远,中间插入大量无关流量,共享前缀可能已被 LRU 挤出去。SGLang 的做法是在调度时对等待队列按「与树的最长匹配长度」排序或分组,让前缀相近的请求扎堆执行。代价是可能轻微破坏公平性(无共享前缀的孤立请求排队变长),实践上通常给排序加权重或限幅,避免饿死。
第二个是页大小与对齐。前面讲过页越小截断浪费越少,但页表项数与分配器开销随页数上升。社区实践里 16~64 token 每页是常见区间,多轮对话这种匹配点经常落在任意位置的场景偏向小页。
第三个是驱逐水位与缓存预算。给树留的显存预算越大,能囤的历史前缀越多,长尾前缀的命中率越高;但预算是从 KV cache 推理显存 总盘子里切出来的,留给树的多了,运行中请求能用的就少了,吞吐上限下降。调法是先定运行峰值所需的刚需显存,再把剩余空间尽量留给树,观察命中率曲线找边际收益拐点。
第四个是流量侧的前缀规范化。这超出了引擎本身但收益巨大:把 prompt 中稳定的部分(system prompt、工具定义、few-shot 示例)统一放到开头,易变部分(时间戳、用户 ID)挪到末尾。前缀规范化做得好的业务,system prompt 段命中率接近 100%;做得差的,开头塞了个随机 request ID,整棵树形同虚设。
| 调优手段 | 作用机制 | 代价 | 典型收益场景 |
|---|---|---|---|
| 缓存感知调度 | 前缀相近请求扎堆执行,趁热复用 | 公平性略损,需限幅防饿死 | 多租户共享 system prompt |
| 减小页大小 | 匹配/分裂对齐浪费减少 | 页表与分配开销上升 | 多轮对话、匹配点位置随机 |
| 扩大树显存预算 | 长尾前缀存活更久 | 运行中请求可用显存减少 | 历史前缀复访率高的流量 |
| 前缀规范化 | 稳定内容上移,易变内容下沉 | 需业务侧改造 prompt 模板 | 所有场景的打底手段 |
四个手段的落地顺序建议是:先做前缀规范化(零引擎改动、收益打底),再开缓存感知调度,页大小和水位放最后压测微调。监控上盯三个指标:全集群的平均命中前缀比例(命中长度除以总 prompt 长度)、树的大小与驱逐速率(驱逐速率突然升高说明水位偏紧或流量分布变了)、以及 TTFT 的 P50/P99——命中率的收益最终都要体现在 TTFT 上才算数,指标体系的搭法可以参考 LLM 推理可观测性栈。
这一篇在知识体系里的位置
本篇是「KV cache 复用」知识线上偏工程实现的一环:概念上游是 prefix caching 提示词复用(为什么复用前缀能省 prefill 的收益分析);存储底座是 PagedAttention 与 vLLM serving(KV 页分配器,RadixAttention 的树就长在它上面)和 KV cache 推理显存(树预算与运行刚需争抢的那个显存总盘子);调度侧同层对照 continuous batching 调度器(树操作嵌入的调度循环)和 LLM serving 的 TTFT/TPOT SLO(命中率收益最终兑现的指标);下游延伸是 disaggregated serving 集群(prefill 与 decode 分池后,前缀树在 prefill 池里的集群级扩展)。
落地顺序建议:先确认业务流量里前缀共享的真实占比(抓一批线上 prompt 算两两最长公共前缀分布),占比低说明该先改 prompt 模板而不是调引擎;占比高再上 SGLang,按第五节的顺序逐项调优,用 TTFT 验收。
总结
SGLang RadixAttention 把全体请求的 KV cache 前缀组织成一棵基数树——边上挂着实打实的 KV 页引用,新请求贪心匹配拿走已缓存前缀只算后缀,请求结束把新 KV 插回树上(落点边的中间就零拷贝分裂节点),显存吃紧时按 LRU 只驱逐无引用的叶子(内部热点节点靠树结构天然受保护);命中率调优的抓手是缓存感知调度让亲缘请求扎堆、小页减少对齐浪费、显存预算给足长尾、以及业务侧把稳定内容挪到 prompt 开头的前缀规范化,最终所有收益都要在 TTFT 曲线上验收。