集群回归:LSF/Grid 回归调度的并发控制、资源约束与结果回收
更新时间:2026-10-02。一个中等规模的 SoC 验证项目,一次全量回归动辄三五千条用例、每例几分钟到几小时,单机跑要一个月——这就是为什么所有团队的 nightly regression 都架在 LSF(Load Sharing Facility)或同类网格调度器(SGE、Slurm)上。站内的 回归管理与分诊 讲了回归策略与失败分级,覆盖率合并与排除流程 讲了回归产出物怎么收口;这一篇聚焦中间最容易被轻视的一环:集群回归的调度工程。用例列表到回归报告之间隔着三层问题——并发开多大、资源约束怎么写、跑完的几千条结果怎么回收,任何一层掉链子,第二天早上看到的就不是回归报告而是集群告警。
本文要回答的问题
- 集群回归的并发额度由什么决定,为什么「有多少 slot 开多少」是错的?
- bsub 的资源约束(内存、license、队列)怎么写才既不缺资源崩溃、又不虚报占坑?
- license 这种集群外的共享资源怎么纳入调度,避免「作业起来才发现没 license」?
- 几千条作业的结果回收与失败重跑怎么自动化,而不是靠人盯终端?
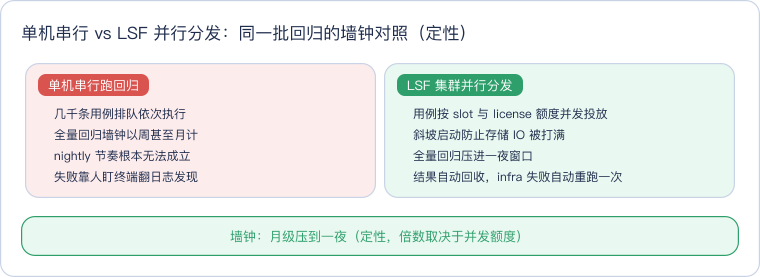
在展开调度细节之前,先用一张对照卡把「为什么非上集群不可」钉住——左右两边的差别不只是快,而是 nightly 这个研发节奏本身能否成立。注意这里只给定性结论:具体快多少倍取决于你的并发额度,而额度怎么定正是第一节的主题。
一、并发额度:真实瓶颈往往不在 CPU
新手跑集群回归的第一个错觉是「集群有 500 个核,我就 bsub 500 个作业」。实际跑起来会发现吞吐远到不了 500 并发,因为回归的瓶颈通常不在 CPU 槽位,而在三个隐藏资源上。
第一个是仿真 license。仿真器(VCS、Xcelium、Questa)的 license 是浮动授权,全公司共享一个池子,常常只有几十到一两百个 seat。500 个作业同时起来,前 100 个拿到 license 开始算,后 400 个卡在 checkout 阶段排队——更糟的是有些作业拿不到 license 直接报错失败,把回归失败率从 2% 冲到 40%,分诊人第二天白忙一场。并发额度的第一约束式是:回归并发 ≤ 可用 license seat 数 × 安全系数(取 0.8 左右,给同事的交互式调试留余量)。
第二个是存储 IO。每个仿真作业都要读设计的编译产物(几个 GB 的 simv 和库文件)、写波形和日志。500 个作业同时冷启动,NFS/Lustre 的元数据服务器瞬间被打满,表现为所有作业都变慢、个别超时挂死。对策有两个:编译和仿真分离,编译产物只做一次并预热到存储缓存;回归启动做斜坡(ramp-up),每分钟放几十个作业而不是一次性全放。
第三个是 license 之外的软件锁:UVM RAL 的某些共享文件、coverage 数据库的合并锁、回归管理器的作业表锁。这些不会体现在调度器的资源视图里,但会以「作业莫名挂起」的形式出现。
上图是集群回归的真实拓扑:调度器只管 CPU 和内存的可见资源,license、存储、软件锁是闸门外的暗资源,并发额度必须按暗资源里最紧的那个来定。工程上建议把额度做成配置项而不是脚本里的魔法数字——license 池扩容了改一处,全团队的回归跟着放量。
二、资源约束写法:内存和 license 都要显式声明
LSF 调度只看你在 bsub 里声明的资源,不声明的部分它当零处理。两个最常见的声明失误是内存低估和 license 漏报。
内存用 -R "rusage[mem=8000]" 声明(单位 MB),配合 -M 8000 设置硬上限(超过即被杀)。怎么估值?跑一次代表性用例,用 bjobs -l 看 MAX MEM,再乘 1.3 的安全系数。估值偏低的结果是作业跑到一半被 LSF 杀掉(exit code 130/137 类),且杀点随机——昨天挂在这条用例、今天挂在另一条,分诊时以为是设计 bug。估值偏高也坏事:一个声明 32GB 实际用 4GB 的作业会独占大内存节点,集群有效吞吐腰斩。带 gate level 波形 dump 的用例和普通 RTL 用例内存差一个数量级,必须分开声明,站内 门级仿真 SDF 与 X 传播 那类重量级作业建议单独走大内存队列。
license 的纳管方式是把它声明成 LSF 的共享资源(elim 采集或静态配置),bsub 里写 -R "rusage[vcs_lic=1:duration=5]"。duration 参数是 license 的预订提前量,让调度器在作业真正 checkout 之前就锁住额度——没有这一句,调度器按「当前空闲 license」放行作业,作业起来后 checkout 撞上别人抢先用掉,又回到排队或失败的老路。如果调度器不支持 license 资源,退而求其次的做法是在提交脚本里先 lmstat 查池子余量,不够就 sleep 重试,但这只是把调度问题搬回了脚本层,优先级不如正经的 rusage 方案。
队列(queue)划分是资源约束的第三根支柱。一个健康的回归集群至少分四个队列:编译队列(大内存、少数作业、长时限)、短回归队列(smoke 用例,时限 30 分钟,抢占优先级高)、长回归队列(nightly 主战场,时限 8 小时)、交互队列(工程师调试,数量封顶)。队列之间用优先级和抢占(preemption)隔离,避免 nightly 大军把同事的调试作业饿死一整天。
这张图回答「bsub 参数为什么这么写」:每一条 -q、-R、-M 都是在向调度器声明一件事,调度器的全部智能建立在声明的真实性上。声明失真,调度就是瞎排。
三、结果回收:作业结束只是回归的一半
作业跑完不等于回归完成。几千条作业的结果回收要解决三件事:状态判读、失败重跑、产物归集。
状态判读的坑在于「作业退出码 ≠ 用例通过」。作业退出码为 0 只代表仿真器正常退出,用例挂没挂要看日志里的 UVM_ERROR/UVM_FATAL 计数和测试 PASS/FAIL 标记;反过来退出码非 0 也可能是基础设施问题(被 LSF 杀、NFS 抖动、license 断线)而不是设计 bug。回收脚本必须三层判读:先看 LSF 退出状态区分「跑完了」与「被杀」,再扫日志提取仿真器的 UVM 汇总行,最后对「被杀」和「日志残缺」的作业打 infra_fail 标签单独成桶——infra 桶不进 bug 统计,只进重跑队列。这一步与 回归管理与分诊 的分级口径衔接:真失败按模块分派,infra 失败按资源类归拢。
失败重跑要自动化但要有节制。规则建议:infra_fail 自动重跑一次,换不同节点(排除节点坏);重跑仍 infra_fail 则报警给人,不再自动循环——自动无限重跑会把一个 NFS 故障放大成几万次作业风暴。真失败(UVM_ERROR 超标)不重跑,直接带 seed 进分诊列表,注意保留原 seed 和完整命令行,保证分诊工程师能逐字复现。
产物归集决定后续覆盖率流程顺不顺。每条 PASS 用例的 coverage 数据库(ucdb/vdb)要按「回归批次 ID + 用例名 + seed」三级路径归档,日志压缩保留、波形默认不存档(只在失败用例上按需保留 48 小时)。覆盖率数据库的合并交给 覆盖率合并与排除流程 的流水线,回归侧只要保证归档命名规范、不重不丢。最后生成回归摘要:总例数、通过率、infra 失败率、新失败 vs 存量失败对比,邮件或看板推送——infra 失败率超过 5% 时摘要要标红,因为那说明集群健康出了问题,不是设计出了问题。
上图是结果回收的决策树。注意它不是一个分叉就结束的:infra 桶的作业重跑后要重新回到判读环节,最终所有分支都要汇进同一份回归摘要,覆盖率数据才能按批次完整进合并流水线。
这一篇在知识体系里的位置
本篇位于 chip-design/verification 目录的回归工程线上,把「用例」与「报告」之间的集群调度环节补齐。向上承接 回归管理与分诊 的回归策略:那边定「跑什么、怎么分级」,本文定「怎么在 LSF 上跑得不翻车」。向下衔接 覆盖率合并与排除流程:回归归档的 ucdb 是合并流水线的输入。横向与 代码与功能覆盖率 的度量口径互补——覆盖率数字的可信度,最终取决于底层这些集群回归作业跑得干不干净。
总结
集群回归的精髓是承认瓶颈不在 CPU:并发额度按 license、存储 IO、软件锁里最紧的暗资源来定并斜坡投放;bsub 资源约束要显式声明内存估值(实测乘安全系数)和 license rusage(带 duration 预订),队列按编译、短回归、长回归、交互四类隔离;结果回收走「LSF 状态、UVM 汇总、日志完整性」三层判读,infra 失败换节点自动重跑一次封顶,真失败带 seed 进分诊,PASS 用例的覆盖率库按批次、用例、seed 三级归档——调度声明真实、回收判读分层,第二天早上的回归报告才值得信任。