UVM sequence library:uvm_sequence_library 注册机制、RAND/RANDC/ITEM 选择模式与可配置随机场景生成
更新时间:2026-10-03。UVM 环境里生成随机激励的主流做法有两条路线:一条是写一个 virtual sequence,在里面用 `uvm_do 宏把各个子 sequence 按你编排的顺序和随机权重发出去;另一条是让 sequence 自己注册进一个「库」,把挑哪个、挑几次、按什么顺序挑的决策权交给库本身。后一条路线的主角就是 uvm_sequence_library——它本身是一个 sequence,但内部维护了一张已注册 sequence 类型的清单,body 里根据配置随机地从清单里选 sequence 启动。站内的 UVM sequence driver scoreboard 讲了激励链路的基本骨架,UVM virtual sequence start 讲了手写编排路线,sv-randc 动态数组随机 讲了 RANDC 语义的语言基础。这一篇把 uvm_sequence_library 这条「轻量路线」讲透:注册宏展开后干了什么、RAND/RANDC/ITEM/RANDC_USER 四种选择模式的语义差别、cfg 配置对象怎么调,以及什么时候它足以替代 virtual sequence、什么时候必须退回手写编排。
本文要回答的问题
- uvm_sequence_library 到底是什么,`uvm_add_to_seq_lib 宏注册时发生了什么?
- RAND、RANDC、ITEM、RANDC_USER 四种选择模式各自什么语义,选错会出什么现象?
- uvm_sequence_library_cfg 配置对象的几个字段怎么影响生成的场景?
- sequence library 与手写 virtual sequence 的取舍边界在哪,什么场景下它不够用?
- 用库生成可配置随机场景有哪些工程纪律(可复现、可审计、可收敛)?
一、uvm_sequence_library 的本质:一个内嵌类型清单的 sequence
先把角色钉死。uvm_sequence_library 本身继承自 uvm_sequence,是一个可以直接 start 到 sequencer 上的 sequence。它和普�通 sequence 的唯一区别是:内部维护了一个静态的 sequence 类型队列 sequences_type_queue,凡是带 `uvm_add_to_seq_lib 宏的 sequence 类,在编译期就把自己的类型句柄登记进了这个队列。库启动后,它的 body 不自己造事务,而是从队列里挑一个 sequence 类型、用工厂造出实例、start 到同一个 sequencer 上,循环往复直到达到配置的执行次数。
class apb_write_seq extends uvm_sequence #(apb_txn);
  `uvm_object_utils(apb_write_seq)
  `uvm_add_to_seq_lib(apb_write_seq, apb_seq_lib)
  function new(string name=""); super.new(name); endfunction
  task body();
    apb_txn tr;
    `uvm_do_with(tr, { write == 1; })
  endtask
endclass

class apb_seq_lib extends uvm_sequence_library #(apb_txn);
  `uvm_object_utils(apb_seq_lib)
  `uvm_sequence_library_utils(apb_seq_lib)
  function new(string name=""); super.new(name); endfunction
endclass两个宏各有分工。uvm_sequence_library_utils 放在库类里,展开后声明了类型队列和一些管理函数;uvm_add_to_seq_lib(seq_type, lib_type) 放在每个候选 sequence 里,展开后是一段静态初始化代码——把 seq_type 的类型包装器 push 进 lib_type 的队列。关键点有两个:第一,注册是编译期静态的,不依赖任何对象被构造,只要这两个类被编译进仿真、被 elaboration 触及,注册就发生;第二,注册是按库分开的,同一个 sequence 可以注册进多个库,多个库之间互不干扰。
这种「静态注册」带来一个隐蔽的坑:如果某个 sequence 类只在一个没被 import 的 package 里、或者编译单元没被链接进仿真,它的注册就静默不发生,库里压根没有它——没有任何报错,回归跑完你发现某类场景从来没被覆盖到。站内的 UVM factory override 审计 讲过类似的「工厂没生效」排查思路,这里的对应动作是:库启动后打印一遍类型队列内容(库里提供了打印函数),确认期望的 sequence 都在册。
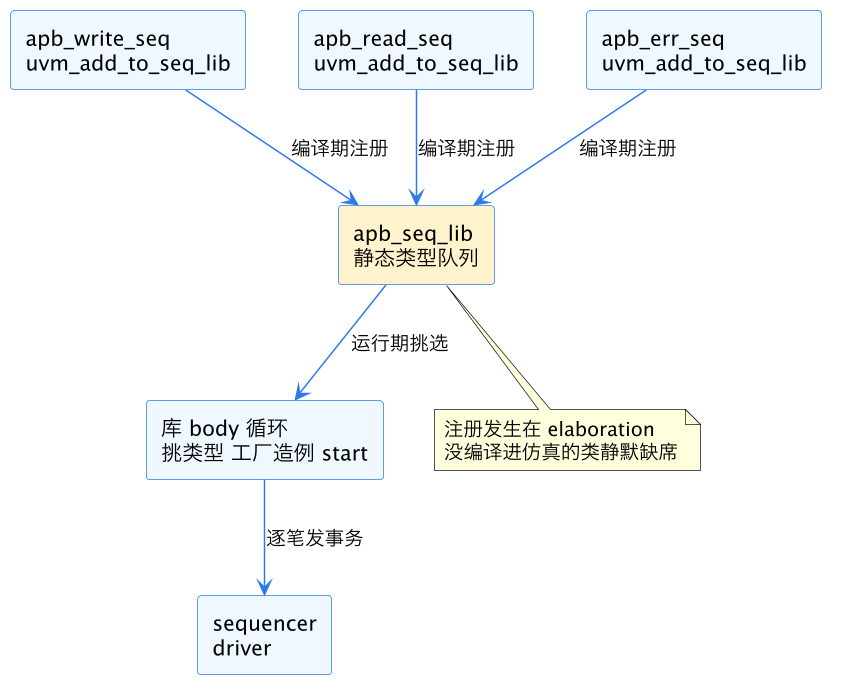
上图是库的全部结构:左侧三个候选 sequence 在编译期把自己注册进中间的静态队列,右侧运行时库 body 从队列里挑类型、工厂造实例、start 到 sequencer。理解了这个「编译期注册、运行期挑选」的两段式,后面的选择模式就只是在「挑选」这一环上做文章。
二、四种选择模式:RAND、RANDC、ITEM、RANDC_USER
库从队列里挑下一个 sequence 的策略由 uvm_sequence_lib_mode 枚举决定,四个取值的语义差别必须记牢,因为选错模式的现场症状非常典型。
- RAND:每次完全随机地从队列里挑一个类型,每个类型被选中的概率均等,允许重复。跑 N 次可能某个 sequence 被挑了三次、另一个一次没挑到。这是默认模式,适合「我只是想要一锅随机激励大杂烩」的场景。
- RANDC:循环随机——队列里每个类型都被挑过一遍之前,不会有类型被挑第二次。相当于把队列洗牌后挨个发,发完一轮再重新洗牌。N 大于队列长度时保证每个类型至少出现 floor(N/len) 次。适合「我想确认每类场景都跑到」的冒烟回归。
- ITEM:不随机,严格按照队列里注册的先后顺序挨个挑,挑完一轮从头再来。这模式常被忽略,但它有个独特价值:调试期确定性——出 bug 时把模式切到 ITEM,激励序列立刻变成完全确定的顺序,复现路径最短。
- RANDC_USER:用户自定义的循环随机。库提供了一个 `select_sequence 钩子函数,你在子类里重写它、返回想要挑的队列下标,库按你的返回值挑,并在每轮结束后通知你。这是逃生舱口:当三种内建模式都不满足时(比如要带权重的随机、要排除某些组合),重写这个函数自己实现挑选逻辑,而不必放弃整个库机制。
class weighted_seq_lib extends uvm_sequence_library #(apb_txn);
  `uvm_object_utils(weighted_seq_lib)
  `uvm_sequence_library_utils(weighted_seq_lib)
  int weights[$] = '{5, 3, 1}; // 写多读次错误少

  function int unsigned select_sequence(int unsigned max);
    int total = 0; int pick;
    foreach (weights[i]) total += weights[i];
    pick = $urandom_range(total-1, 0);
    foreach (weights[i]) begin
      if (pick < weights[i]) return i;
      pick -= weights[i];
    end
    return 0;
  endfunction
endclass
这段代码演示了 RANDC_USER 的典型用法:按权重挑下标。注意 select_sequence 的入参 max 是队列长度,返回值必须在 [0, max) 内,越界的行为未定义——有些仿真器会静默 wrap,有些直接 fatal,写钩子时自己把边界守住。
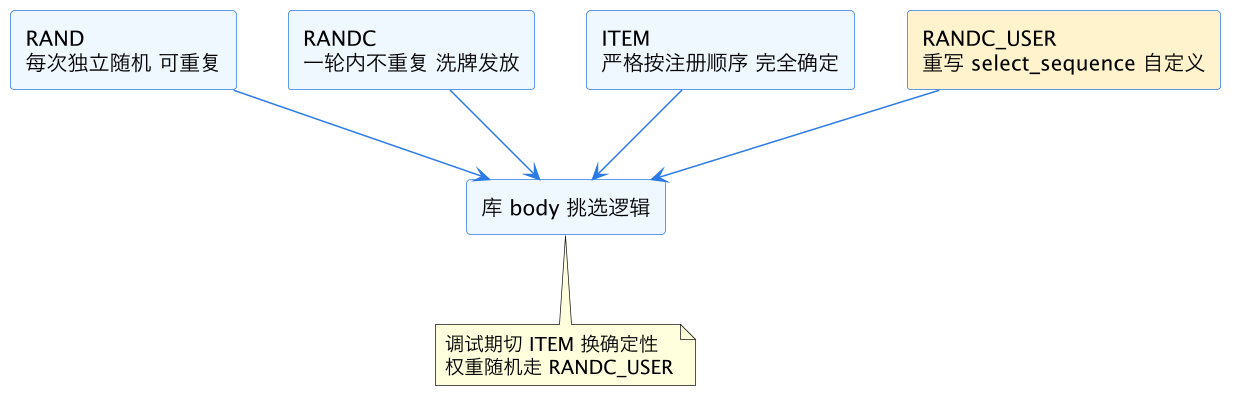
这张图把四种模式并列画出来供对照:前三种是内建策略,挑的是「随机性与确定性」的不同折中;第四种把决策权交还给你。一个常被问到的问题是「RAND 模式下某个 sequence 会不会一直不被挑到」——数学上 N 足够大时概率趋近于零,但 20 次执行漏掉一个类型的概率并不小,所以「每类场景必须出现」的需求不要用 RAND 加祈祷,直接上 RANDC。
| 模式 | 重复 | 顺序确定 | 典型用途 |
|---|---|---|---|
| RAND | 允许 | 否 | 大杂烩随机回归 |
| RANDC | 一轮内不允许 | 否 | 冒烟、类别全覆盖 |
| ITEM | 按序循环 | 是 | 调试复现 |
| RANDC_USER | 取决于实现 | 取决于实现 | 带权重、带约束的定制挑选 |
三、cfg 配置对象:控制生成多少、怎么开始
库的执行行为由 uvm_sequence_library_cfg 对象控制,四个字段决定了一切:
- selection_mode:上一节的四种模式。
- min_random_count / max_random_count:库 body 循环执行 sequence 的次数在这两个值之间随机。注意计数单位是「sequence 启动次数」,不是事务笔数——一个 sequence 内部发多少笔事务由它自己的 body 决定。
- sequences_randomize:布尔位,为 1 时被挑中的 sequence 会先整体 randomize 再 start(配合 sequence 里的 rand 成员做参数随机);为 0 则直接 start,sequence 内部自己管自己的随机。
task test_lib::run_phase(uvm_phase phase);
  apb_seq_lib lib = apb_seq_lib::type_id::create("lib");
  uvm_sequence_library_cfg cfg =
      new("cfg", UVM_SEQ_LIB_RANDC, 10, 20, 1);
  phase.raise_objection(this);
  lib.init_sequence_library(cfg);
  lib.start(env.agent.sqr);
  phase.drop_objection(this);
endtask
用法是流水线式的:test 里 new 一个 cfg、填好四个字段、调 init_sequence_library 灌进库、然后像普通 sequence 一样 start。两个工程细节值得说。第一,cfg 可以在两次 start 之间重新 init——同一个库对象先按 RANDC 跑 10 次做类别覆盖、再切 RAND 跑 200 次做长时间随机轰炸,一个 test 内两段激励策略,这在手写 virtual sequence 里要拆两个任务。第二,count 的随机用的是全局线程的 $urandom,种子由仿真命令行 +ntb_random_seed 控制,所以「同一个种子跑出同一份场景」的可复现性是天然成立的——前提是你没在 select_sequence 钩子里引入系统时间这类外部熵源,那就把可复现性亲手毁了。关于随机稳定性的系统性讨论,sv-random-stability-seeding 有完整展开。
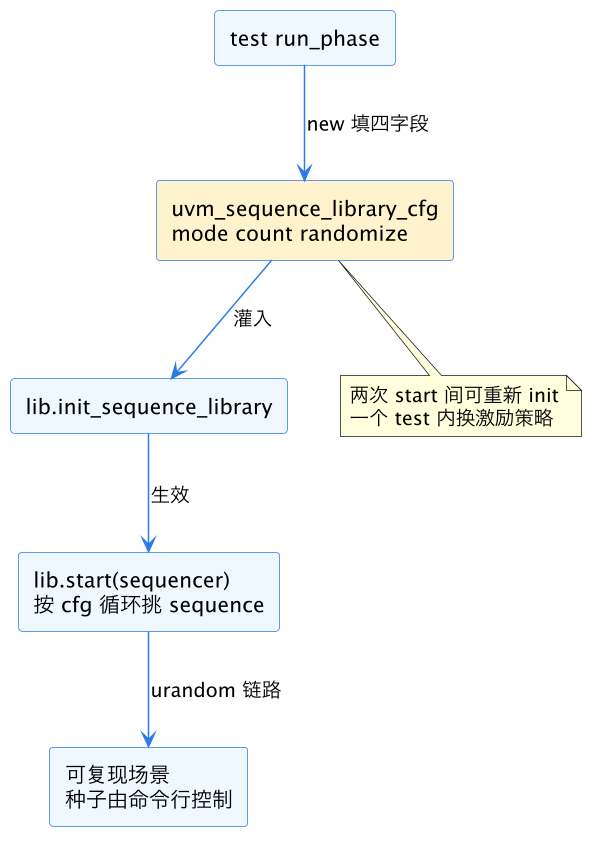
上图是配置流的四步:填 cfg、灌库、start、可复现。整张链路没有一行是 hand-write 的编排逻辑——这正是 sequence library 的价值主张:把「发什么、发多少、按什么顺序发」从过程式代码变成了声明式配置。
四、与手写 virtual sequence 的取舍边界
「既然库能随机挑 sequence 发,为什么还要写 virtual sequence?」这是每个团队迟早要回答的问题。两者的能力边界画清楚,选型就不纠结。
库擅长的是单层、无依赖、同 sequencer 的场景混合:所有候选 sequence 都发在同一个 sequencer 上(库本身 start 到哪个 sequencer,挑出来的子 sequence 就 start 到哪个),彼此无先后依赖、无共享状态,决策只是「下一个挑谁」。典型的 fit 场景是接口级随机回归——APB 口上写、读、错误注入、back-to-back 四类 sequence 随便混着发,发一万次看 DUT 会不会挂。
库做不到的事有三类。第一类,跨 sequencer 编排:场景里要「先在配置口写寄存器、等中断、再在高速口发数据」,涉及多个 agent 的 sequencer 协同,库只有一个 sequencer 概念,做不了——这是 virtual sequence 的本职,UVM virtual sequence start 讲的正是这套。第二类,有依赖的顺序:「reset sequence 必须先跑、init 之后才能跑业务 sequence」,库的选择模式里没有「前置依赖」的表达力,RAND 随时可能把业务 sequence 挑到 reset 前面。第三类,共享状态传递:sequence B 要用 sequence A 读回来的值决定发什么,库里每个 sequence 都是独立造、独立 start 的,没有状态传递通道,只能靠全局变量 hack——那已经是设计坏味道了。站内的 uvm-sequence-sequencer-arbitration 讲了多 sequence 在单 sequencer 上的仲裁语义,和库混用时值得对照;uvm-sequencer-lock-grab-exclusive 讲的 lock 机制则是库里某类 sequence 需要独占通道时的配套手段。
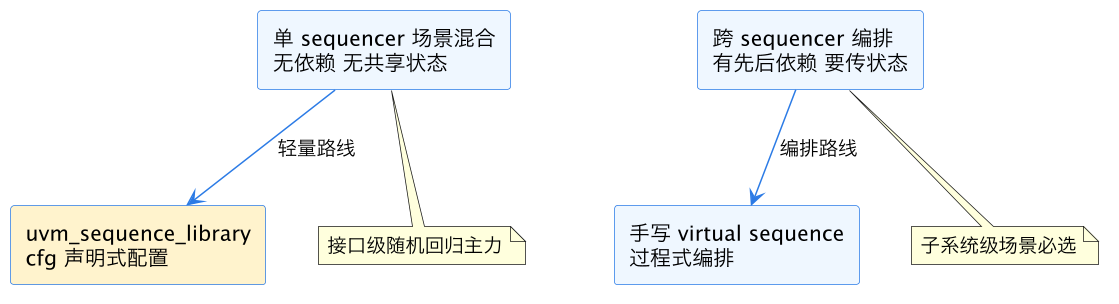
这张图就是选型判据的图示:左边需求进库,右边需求进 virtual sequence。工程上的真实答案常常是混用:virtual sequence 负责跨 agent 的大场景骨架,其中「高速口随机轰炸」那一段用 sequence library 实现——库当作一个 sequence start 进 virtual sequence 的编排里,两层各司其职。
五、可配置随机场景的工程纪律
把库用进正规回归,还有四条纪律要立。
第一条,库内容物要可审计。前面说过注册是静态静默的,所以每次回归开始时把库里注册的类型清单打进 log,回归报告里附上——三个月后追查「某类场景覆盖率为什么为零」时,第一眼看的就是这份清单。第二条,场景与种子绑定存档。cfg 四字段加随机种子就是这份激励的完整指纹,回归系统把五元组(mode, min, max, randomize, seed)存进数据库,任何 fail 都能原样重放。第三条,count 与仿真时长对齐预算。min/max 拍脑袋定的后果是 regression 时长失控——count 的取值要从事务速率和仿真时间预算反推,长事务协议(DMA 大块传输)上一个 sequence 可能跑几百微秒,max 写 200 就是自爆。UVM phase objection 结束机制 讲的 objection 收尾也要配合:库 start 返回前要确保最后一笔在途事务被收净。第四条,类别覆盖走 RANDC 加覆盖率反馈。RANDC 保证每类出现,但「出现」不等于「覆盖到」——某类 sequence 内部的参数空间可能很大,这时要用功能覆盖率闭环:回归合并后看哪类 sequence 的内部覆盖没打满,针对性加 min/max 或拆细 sequence。这套「场景分类随机加覆盖率收敛」的分层思想,sv-scenario-randomization-layers 有更系统的展开,覆盖率驱动测试分诊 讲的是拿到覆盖数据后怎么分诊补场景。
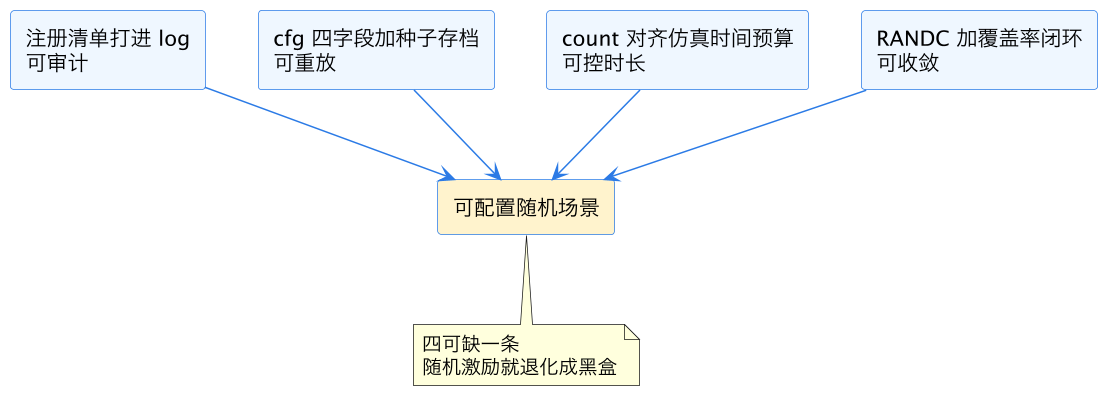
四可——可审计、可重放、可控时长、可收敛——是 sequence library 从「能跑」到「能上回归」的分水岭。随机激励的价值不在于随机本身,而在于每一次随机都可被解释、被复现、被收敛成覆盖率数字。落地时还有一个小习惯值得养成:把库的封装再往上抽一层,给项目封一个 my_proj_seq_lib 基类,统一预置 select_sequence 的权重表结构和打印清单的函数,各接口的库只填权重数字——这样四可纪律里的「可审计」和「带权重挑选」就变成了基础设施,而不是每个验证工程师各自重抄一遍的样板。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM 激励生成线的一篇标准深文,主关键词 UVM sequence library。向上承接 UVM sequence driver scoreboard 的激励链路和 约束随机验证 的方法论总览,把「随机挑 sequence」这一轻量机制补齐。横向与 UVM virtual sequence start(重量编排路线)、uvm-sequence-sequencer-arbitration(多 sequence 仲裁)、uvm-sequencer-lock-grab-exclusive(通道独占)互为配套;随机语义的地基在 sv-randc 动态数组随机 与 sv-random-stability-seeding,分层场景思想在 sv-scenario-randomization-layers。向下,库生成的场景汇入功能覆盖率闭环,接 覆盖率驱动测试分诊 完成收敛。寄存器场景另有一条专用库路线,见 uvm-reg-sequence-library-built-in。
总结
uvm_sequence_library 是一个内嵌静态类型清单的 sequence:候选 sequence 用 `uvm_add_to_seq_lib 宏在编译期注册进库,库 body 按 cfg 配置的 RAND(独立随机)、RANDC(一轮不重复)、ITEM(按注册顺序,调试用)、RANDC_USER(重写 select_sequence 自定义权重)四种模式挑选并 start 到同一个 sequencer 上,count 在 min/max 间随机决定执行次数。它适合单层、无依赖、同 sequencer 的接口级随机场景混合,是手写 virtual sequence 的轻量替代;跨 sequencer 编排、有先后依赖、要传状态的场景必须退回 virtual sequence,工程中两者常混用——virtual sequence 搭骨架、库填随机段。上正规回归要立四可纪律:注册清单打 log 可审计、cfg 加种子存档可重放、count 对齐时间预算可控时长、RANDC 配覆盖率闭环可收敛,缺一条随机激励就退化成无法解释的黑盒。