详细布线 DRC:rip-up reroute 修复迭代、违例分类与收敛判断的工程方法
更新时间:2026-10-02。布局布线流程走到详细布线(detailed routing)这一步,前面的全局布线已经给每条 net 规划好了大致走廊,但真正把一根根金属线、一个个通孔落到 track 上,是详细布线器干的活——而它干的每一步都可能撞上制造工艺的几何规则,也就是 DRC(Design Rule Check,设计规则检查)。本站 布线拥塞、DRC 与串扰 从拥塞视角讲过布线质量的三座大山,LEF/DEF 数据格式 讲过布线结果落在什么数据结构里,CTS 到布线的数据流 给过阶段全景。这一篇聚焦一个具体问题:详细布线 DRC 修复迭代是怎么工作的——违例怎么分类、rip-up reroute(拆掉重绕)引擎按什么策略一轮轮清扫、以及怎么判断「收工了」还是「这条路根本走不通,得回上游」。
本文要回答的问题
- 详细布线阶段会冒出哪几类 DRC 违例,各自的根源和修复难度差在哪?
- 现代布线器为什么是「允许违规先连通、再迭代清违例」的架构,而不是一次就布干净?
- rip-up reroute 的一轮迭代里,引擎按什么顺序挑违例、拆多大的网、重绕时怎么避免按下葫芦浮起瓢?
- 判断 DRC 收敛看哪些指标,违例数曲线怎么读,什么叫「收敛平台期」?
- 最后清不掉的顽固违例有哪些后手:ECO 手段、waiver、还是回 floorplan/place 重做?
一、先看清对手:详细布线 DRC 违例的分类学
详细布线器面对的设计规则,本质上是 foundry 用几十个参数描述的「光刻机和刻蚀机能不能把这张版图造出来」的约束。落到日常报告里,违例大致可以分成五类,修复难度完全不同。
第一类是间距类(spacing):两条平行金属线中心距或边到边距离小于规则值。这是最量大面广的一类,先进工艺下同层间距规则还分「平行跑多长要加宽多少」的表格化规则(parallel run length dependent),一根线旁边并行多根邻居时,违例会像串糖葫芦一样成片出现。
第二类是宽度与面积类(min width / min area / enclosed area):线段太细、一小块金属面积不够、或者凹槽(notch)太窄。这类违例常常不是「线布错了」而是「形状凑出来的」——绕线绕出一个细脖子或一个小耳朵,单纯挪线就能修掉。
第三类是通孔类(via enclosure / via spacing):通孔上下层金属的包边不够、通孔之间距离太近。先进工艺大量采用单通孔加规则 enclosure 的设计,via 违例和 spacing 违例经常纠缠在一起,修一个可能带出另一个。
第四类是短路/开路类(short / open):两条不同 net 的金属直接碰上,或者自己 net 没连通。短路与开路在迭代早期是常态(引擎故意先不管),到了收尾阶段必须清零——这两类是唯一「不可 waiver」的硬违例。
第五类是先进工艺的特殊规则:双倍图形(double patterning)的染色冲突、定向金属(preferred direction 之外的 jog 长度限制)、via pillar、EOL(end-of-line)间距等。DPT 染色分解 讲的染色问题在布线阶段体现为「同一层的两条线颜色分不开」,修复手段已经超出挪线本身。
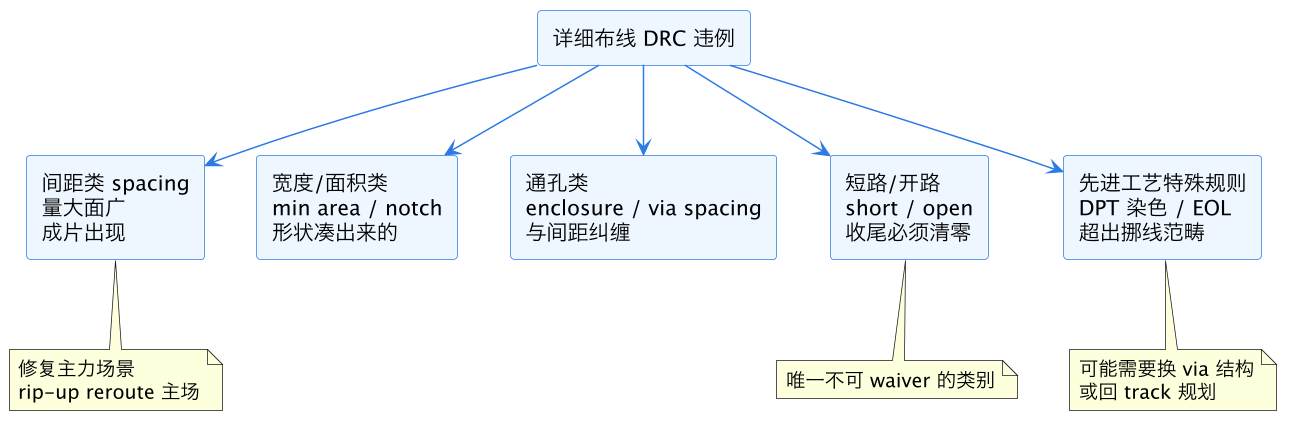
这张分类图值得贴在工位上,因为后续的修复策略完全按类别分叉:间距和通孔类交给迭代引擎批量清扫,宽度面积类顺手带过,短路开路是迭代收敛的底线指标,而先进工艺特殊规则一旦成片出现,往往说明问题不在布线器而在上游——NDR 设置、标准单元 track 高度选择 或者 PG 网格规划,PG mesh 与 strap 设计 占了过多 routing resource 时就是典型场景。
二、为什么是迭代架构:先连通、再清违例
很多新人第一次看详细布线的迭代日志会困惑:为什么布线器不直接布出一条不违规的线,而要允许违例先存在、再一轮轮修?答案是数学上的不得已。
详细布线要同时满足两组目标:连通性(每条 net 按拓扑连上)和规则满足(不违反任何 DRC),外加时序、串扰、天线等软约束。这是一个超大规模的组合优化问题,几百万条 net 挤在有限 track 上,互相争抢资源。如果要求「每放一根线都保证零违例」,引擎每走一步都要检查海量规则并且大量路径根本走不通,运行时间会爆炸到不可接受。业界验证过的可行架构是分阶段:先做 track assignment(把全局布线的走廊分配到具体 track,允许局部违规),再做 detailed routing 主体(用 maze routing 逐 net 连通,允许 spacing 等软违例存在),最后进入 DRC 修复迭代——把违例当作「欠下的债」,一轮轮清。
这个架构的思想其实和静态时序分析里「先跑出违例路径再修」一脉相通:把一个不可解的同时优化问题,拆成「可行解 + 迭代改进」的框架。代价是要设计一套机制保证迭代真的收敛而不是原地打转,这正是下一节 rip-up reroute 策略要解决的问题。
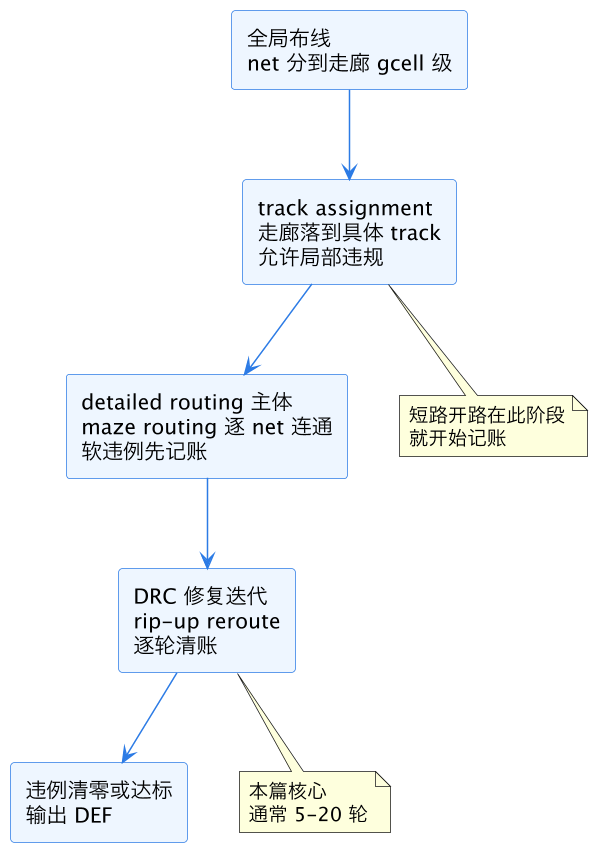
读这张流程图时留意各阶段「允许什么违例存在」的差别:track assignment 阶段允许的是间距类软违例,short 在主体 maze 阶段也暂时容忍,但进入修复迭代后,每一轮的账本上违例只该减少不该增加——这个单调性假设是判断引擎健康度的关键,也是收敛判断的前提。布线的上下文在 Innovus P&R 流程 里有端到端视角,本篇只放大其中「修复迭代」这一格。
三、rip-up reroute 一轮迭代里发生了什么
rip-up reroute 的字面意思是「拆掉重绕」:选中一批和违例相关的 net,把它们现有走线拆掉(rip-up),在避开其他 net 占用资源的前提下重新布线(reroute),期望新走线绕开原来的违例点。听起来简单,工程上一轮迭代里有四个关键决策。
第一个决策:修哪些。引擎不是见违例就修,而是按优先级排序——短路开路永远排最前,其次是 spacing 和 via 类,最后是 min area 这类「顺手修」的。同一轮里通常按违例密度分块(把芯片划成若干窗口),优先清违例最密集的热点区域。这个排序的直觉是:短路不除,其他违例的位置信息都不可靠,因为两根线碰在一起时它们周围的间距测量本身就是失真的。
第二个决策:拆多大。拆掉违例点上的一根线往往不够,因为重绕时它还是会被同样的局部拥塞挤回老位置。所以引擎会拆「违例点周围一个窗口内的若干 net」,叫 rip-up 半径或波及范围。半径太小修不动,太大则拆掉的净数量暴涨,重绕失败概率和运行时间一起上升,还可能把原本干净的线拆出新违例——这就是「按下葫芦浮起瓢」的来源。
第三个决策:重绕的代价函数。重绕不是简单 maze 最短路径,代价函数里除了线长,还有「离其他 net 金属多远」(间距裕量)、「换层次数」(via 数量)、「是否压到已固定的时钟线/NDR net」。时钟线和带 NDR(非默认规则)的 net 通常被保护起来不参与 rip-up,NDR 屏蔽与时钟规则 讲的那套双倍间距屏蔽线,在修复迭代里是「只许绕开、不许拆动」的硬资产。
第四个决策:历史惩罚(history cost)。为了防止两个违例点之间来回震荡——这轮修 A 点产生 B 点违例,下轮修 B 点又把 A 点撞回来——引擎给「历史上出过违例的位置」加递增惩罚,让重绕倾向于彻底绕开事故多发地段。历史惩罚是收敛性的数学保证:它让重走老路的代价单调上升,最终迫使引擎要么找到真解,要么把违例钉在一个不再恶化的位置。
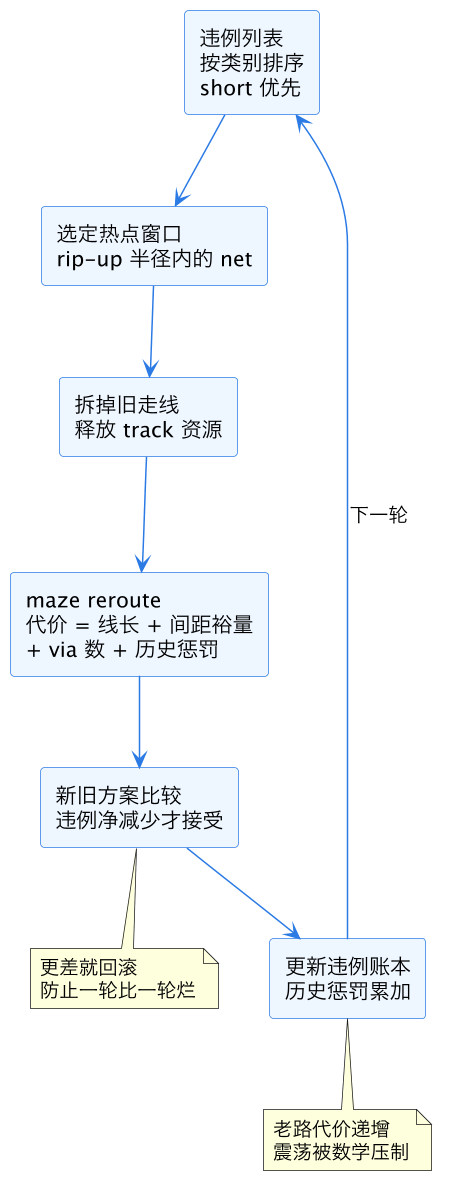
这张图是一轮迭代的完整闭环。两个注记是工程灵魂:「更差就回滚」保证每轮账本单调改善,「老路代价递增」保证不震荡。实际工具(Innovus 的 NanoRoute、ICC2 的 route_opt 体系)在这套骨架上还叠了多线程窗口划分、时序驱动 reroute(绕线时兼顾 slack 恶化)等机制,但核心四决策不变。天线违例(antenna)在修复迭代里往往同步处理,见 天线二极管修复流程,它和 DRC 修复共用 rip-up 基础设施。
四、收敛判断:看什么数、读什么曲线
详细布线 DRC 迭代跑起来后,工程师面对的日常问题是:还要跑几轮?是正常收敛还是卡住了?判断依据是一张违例数随轮次的曲线加几个结构指标。
健康的收敛曲线长这样:第 0 轮(主体布线刚结束)违例数从几千到几万不等(取决于设计规模和工艺节点),前 3 到 5 轮快速下降,每轮砍掉一半甚至更多;之后进入缓降期,每轮降 10% 到 30%;最后进入平台期,违例数在几十到几百之间小幅波动。平台期的违例构成会发生质变——剩下的不再是成片 spacing,而是孤立的「钉子户」:某个局部拥塞热点里的几根线,怎么绕都要碰一根邻居。
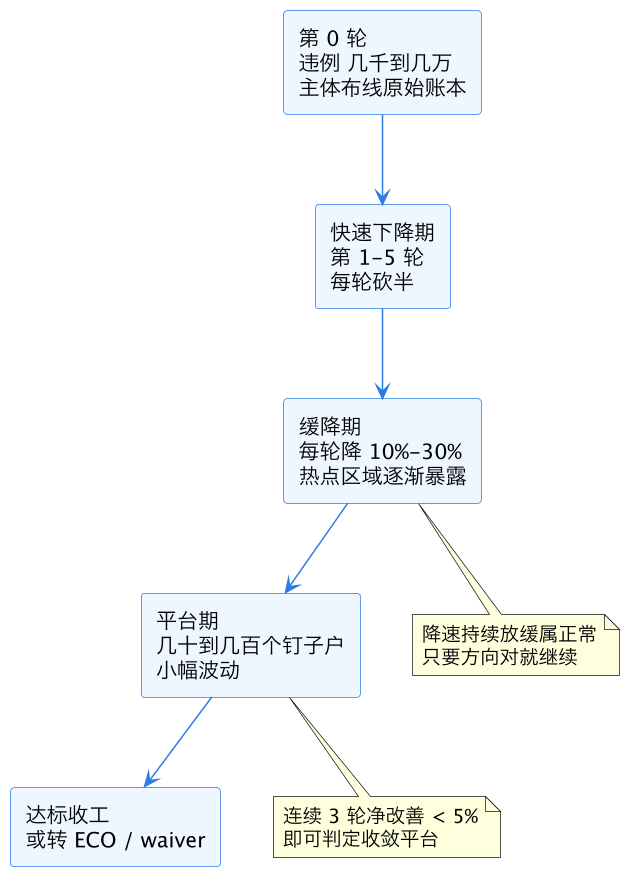
这张阶段图对应的定量判据可以落成三条经验规则。其一,看总量方向:连续两轮违例数不降反升,说明 rip-up 半径或代价函数配置有问题,先查参数再盲目续跑。其二,看结构变化:违例 markers 在版图上的分布从「遍地开花」收缩到「几个热点」,是健康信号;如果始终是均匀散布,大概率是全局拥塞超标,布线器再努力也没用,得回 布局拥塞与 cell padding 那条线。其三,看类别清零顺序:short/open 必须先归零,spacing/via 可以留到平台期,min area 类往往在最后一两轮由专门的 filler/notch fill 步骤顺手清掉,filler cell 与密度规则 和 metal fill 与 CMP dummy 讲的是收尾阶段的密度类处理。
收工标准要预先定义清楚,不能凭感觉。常见口径是:short/open 为零;DRC 违例总数低于项目阈值(很多项目定的是「全部清零」,先进工艺大设计也接受「个位数且全部人工评审过」);所有残余违例都落在可 waiver 的类别里。这里有个容易踩的坑:布线器内部检查的 DRC 集合和签核 DRC(Calibre 跑 foundry rule deck)不完全等同——布线器的规则模型是简化版,签核 deck 才是法律文本。所以布线器报零违例不等于 tape-out 干净,Calibre 物理验证 那关还要再过一遍,两者的规则映射关系在 LEF/DEF 数据格式 的技术 LEF 部分有对应。
五、钉子户怎么处理:ECO、waiver 与回炉重造
平台期剩下的违例,逐个分析通常能归进三个篮子,对应三种后手。
第一个篮子:局部资源枯竭。典型画面是几条 net 在一个窄通道里谁也不让谁,通道两侧是 macro 或 PG strap 挡路。布线器层面的后手是加大 rip-up 半径、允许更多层绕行、或者把邻近非关键 net 整体搬走;如果这些都不行,说明物理上这个通道就是塞不下,得用 ECO 手段腾资源——挪动挡路的 cell、调整 macro 间距(如果还在可动阶段)、或者削减该区域的逻辑密度。这类问题的根治在上游,布线阶段只是症状暴露点。
第二个篮子:可 waiver 的规则冲突。有些违例是「规则保守余量内、工艺上实际可制造」的,典型是某些 min area 或特殊 enclosure 场景。处理路径是走正式的 waiver 流程:提交 foundry 或内部质量团队评审,留下书面记录。waiver 的治理纪律见 DRC waiver 管理——waiver 是法律豁免不是遮羞布,每一条都要能追溯到评审结论,且绝不适用于 short/open。
第三个篮子:布线器能力边界。少数违例靠自动 reroute 就是修不掉,比如某些 DPT 染色死结、via 阵列的结构冲突。业界惯例是导出到交互式版图编辑器做手工修复(custom editing),人工画几根线补上。手工修复量必须控制——一个 signoff 级设计手工修几十处可以接受,修几百处说明流程哪里出了系统性问题,而且手工改动在后续任何 ECO 重布线时都可能被冲掉,要在 signoff closure ECO 流程里登记保护。
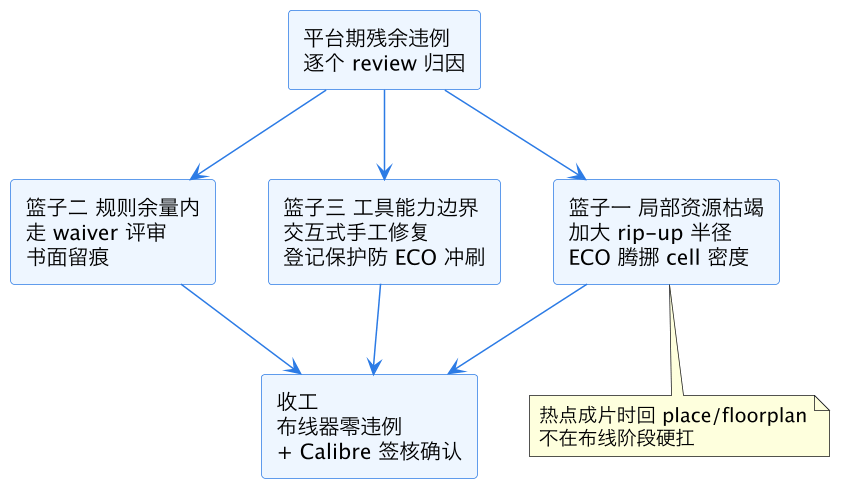
这张分流图是项目收尾阶段的作战地图。三个篮子的占比本身也是流程健康度指标:篮子一占比高说明拥塞规划失败,下轮迭代(或下次流片)要修 floorplan;篮子二占比高说明规则模型或 NDR 配置过激;篮子三占比高说明工具设置或库的 routing 友好度有问题。还有一点纪律:金属层 ECO 阶段(改版只动金属),修复迭代的约束更苛刻——只能动 mask 允许的层,metal-only ECO 与 spare 单元 讲的流程里,rip-up 的自由度被大幅压缩,残余违例处理更依赖预布的 spare 资源。
六、把收敛变成可复制的工程
把前面五节揉成一套可执行的日常方法,是四句话。第一,迭代参数手册化:rip-up 半径、每轮修复窗口数、历史惩罚系数、时序驱动开关,这些参数在项目早期用一个小模块调出一套基线,固化进流程脚本,全项目复用,不随手感改。第二,每轮出标准化报告:违例总数曲线、按类别分解、热点分布图,三件套贴进每日回归看板,收敛平台期靠数据判定而不是靠「感觉差不多了」,数据流之 QoR 仪表盘 有看板组织方式。第三,残余违例的 review 会议化:平台期每天花二十分钟,设计、PD、foundry 接口三方过一遍钉子户清单,当场分篮子定后手,避免违例在流程里「挂账」挂到 tape-out 前夜。第四,硅后反馈闭环:waiver 过的规则、手工修过的位置,在硅后良率数据回来时对照检查,用真实硅验证布线器规则模型的松紧度,反哺下一项目的迭代参数——硅反馈数据流 讲的是这套回路的组织。
详细布线 DRC 修得好不好,最终不体现在违例清零那一刻,而体现在整个项目为它花了多少人力周。收敛快的项目,靠的不是更强的布线器,而是更早暴露热点、更果断地把烂摊子推回上游。
这一篇在知识体系里的位置
本篇是 eda/ 目录物理实现线的一篇标准深文,向上承接 CTS 到布线的数据流 与 Innovus P&R 流程 的阶段叙事,横向与 布线拥塞、DRC 与串扰(质量三指标)、NDR 屏蔽与时钟规则(受保护资产)、天线二极管修复流程(共用 rip-up 设施)互为补充;向下接签核侧——Calibre 物理验证 的法律级 DRC、DRC waiver 管理 的豁免治理、signoff closure ECO 与 metal-only ECO 与 spare 单元 的改版约束。规则模型侧可延伸到 LEF/DEF 数据格式 与 DPT 染色分解;上游根源问题回到 布局拥塞与 cell padding 和 PG mesh 与 strap 设计。
总结
详细布线 DRC 的本质是「先连通、再清账」的迭代优化:布线器用 track assignment 和 maze routing 把 net 连通时允许软违例记账,随后靠 rip-up reroute 一轮轮清账——按 short 优先的类别排序选热点窗口、拆掉半径内的 net、用带间距裕量和历史惩罚的代价函数重绕、更差就回滚,让违例数沿「快速下降、缓降、平台」三段曲线收敛;收敛判断看总量方向、热点收缩和类别清零顺序三件事,平台期钉子户分「资源枯竭回上游 ECO、规则余量内走 waiver、工具边界手工修复」三个篮子处理,而布线器零违例只是中场哨,终局以 Calibre 签核 deck 的清零结论为准。