FPGA 专家 11:Zynq UltraScale+ 与 Versal——异构平台演进
一、三代平台对比
| Zynq-7000 | UltraScale+ MPSoC | Versal ACAP | |
|---|---|---|---|
| 应用 CPU | 双核 A9(32b) | 四核 A53(64b) | 双核 A72 |
| 实时核 | — | 双 R5(可锁步) | R5 |
| PL 架构 | 28nm 7 系 | UltraScale(DSP48E2/URAM) | Adaptable Engine |
| 互联 | AXI crossbar 手工连 | NIC + HP/HPC | NoC 片上网络 |
| 向量加速 | PL RTL/DSP | PL DSP | AI Engine 阵列 |
| 收发器 | 7 系 GTP/GTX | GTH/GTY 16~28G、PS-GTR | GTY 58G/PAM4 |
| 内存 | DDR3 | DDR4 | DDR4/LPDDR |
| 管理/启动 | FSBL | PMU fw + ATF/安全启动 | PLM + XRT |
二、MPSoC 三域分工
三、Versal 关键转变
- NoC:声明"主口访问 DDR/带宽 QoS",路由/仲裁/跨时钟域/时序由 NoC 硬件保证,告别手工 crossbar;
- AI Engine:C/C++ 编程的 VLIW/SIMD 向量核阵列,擅规则向量密集计算(5G/ML/滤波器),与 PL 经 stream、与 DDR 经 NoC 协同;
- XRT/PLM:统一运行时和平台管理,Vitis 做加速 kernel。
四、迁移要点
- DDR3→DDR4,MIG/引脚重新生成;
- 32 位→64 位(工具链/设备树/驱动适配);
- 实时任务评估剥离到 R5;
- 启动链增加 PMU firmware/ATF(MPSoC)、PLM/XRT(Versal);
- Versal:互联思维转 NoC、向量算法评估 AI Engine、Vitis 统一流程;
- RTL 逻辑大多可移植,重在 IP 重参数化与系统架构。
五、MPSoC 三域协同:A53、R5 与 PL 的职责工程
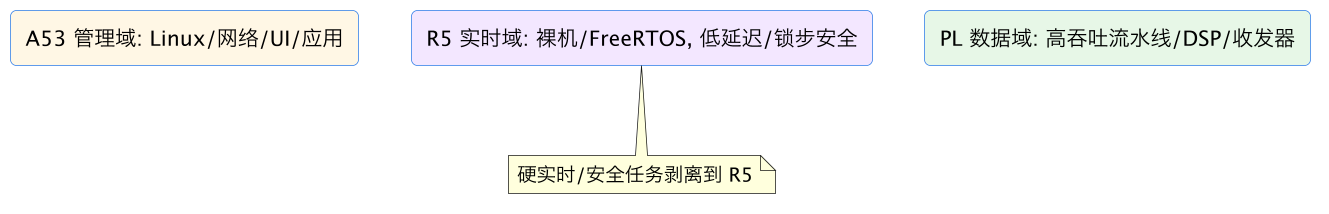
UltraScale+ MPSoC 相对 7000 最大的架构红利是出现了三个特性明确的执行域,用好它们的关键不是“核多了”,而是按确定性和信任级别分配职责。A53 应用域:64 位 ARMv8、虚存、完整 Linux、丰富生态,承担人机界面、网络协议、数据管理、算法的非实时部分;其调度抖动是微秒到毫秒级,任何需要硬截止期的逻辑都不能默认放这里。R5 实时域:双核 R5F,带紧耦合存储器 TCM、紧耦合中断控制器、低延迟访问外设,可运行裸机/FreeRTOS,关缓存或精控缓存时中断响应可达亚微秒到数微秒;适合实时总线主站、运动控制、安全监控、上电早期任务、对 A53/PL 的看门狗。R5 双核可分核(独立处理两路实时任务)或锁步(两核执行同一指令流、硬件比对输出,任一偏差触发异常),锁步是面向 ISO 26262/IEC 61508 功能安全的配置,代价是一半算力和更严格的诊断覆盖,不要为了“看起来可靠”默认锁步。PL 数据域承担微秒以下确定性、线速和大规模并行。
三域协同要设计通信与生命期。通信通道包括:基于共享内存的消息(OpenAMP/RPMsg,配合硬件信号邮箱和缓存维护)、PS-PL 中断、AXI 端口(R5 也可直接访问 PL/部分 PS 资源,延迟低于经 Linux 的路径)。设计原则:安全/保护链路由 R5 或 PL 独立持有,A53 文件系统损坏或重启不影响保护动作;Linux 作为可重启的“应用容器”,R5/PL 在其崩溃时进入安全态并记录事件;启动顺序上 R5 可先于 A53 运行(FSBL 加载 R5 固件),满足“上电即监控”。软件组织上建议 PMUFW(平台电源/复位服务)、R5 固件、ATF、Linux 镜像分别版本化,并定义 ABI(消息格式、共享内存布局、版本握手),否则现场升级任一组件都可能破坏核间通信。还要避免常见浪费:把 R5 当“第二个慢 A53”跑复杂网络栈,或把硬实时仍留在 Linux 用户态靠提升优先级硬撑——前者浪费了实时能力,后者在压力下必然失效。三域模型的本质是把“功能正确、实时正确、安全正确”三种正确性分配到最适合证明它们的执行环境。
六、MPSoC 电源、复位与启动:PMU、电源域和启动镜像
MPSoC 的电源和启动复杂度相对 7000 上了一个台阶,理解电源域划分是可靠设计的前提。芯片分为 PS(含 A53/R5/PS GTR 等多个子域)与 PL 电源,PMU(Platform Management Unit,一个微Blaze 运行 PMUFW)是电源/复位/时钟的仲裁中心:所有上电、域上下电、复位、挂起/唤醒请求都经 PMU 固件的 API/电源节点处理;PL 可以独立断电(PL 断电后 PS 继续运行),这为低功耗和现场重配置提供了基础,但也意味着 PL 电源的时序、监控和 PG 信号必须按器件 PCB 设计指南实现,电源违规时 PMU 会拒绝启动或触发错误停机。硬件设计要给 PL 配置和 PS 启动留足电源裕量,MPSoC 的电流需求高、瞬变大,PS/PL 去耦和电源排序不可照搬 7000。
启动链为 BootROM→PMUFW(初始化电源管理与安全服务)→FSBL(时钟/DDR/互连,加载各分区)→ATF(BL31,安全监控,提供 SMC 服务)→u-boot→Linux;R5 固件可由 FSBL 作为独立分区加载并立即运行。BOOT.BIN 是容器,BIF 文件声明各成分(pmu_fw、fsbl、bitstream、u-boot、应用 elf、R5 固件)的加载地址、权限、目标 CPU、签名/加密属性。安全启动(RSA/SHA、AES 加密、PPK 熔断 eFUSE)在 BootROM 阶段建立根信任,之后逐级验签;调试端口可被 eFUSE 永久关闭,量产板应明确策略。工程建议:用统一脚本生成 BIF/镜像并纳入 CI(专家 46);测量每个启动阶段耗时并预算;实现 A/B 双分区 + u-boot 失败回滚 + PL 比特流独立回滚;保留安全的恢复模式(未签名调试只允许工厂模式)。PL 比特流既可作为启动分区由 FSBL 加载,也可在 Linux 运行时经 FPGA Manager 在 PMU 协调下重配(配合部分重配置见 专题 03)。把“谁在什么时候复位谁、谁先活、谁可以死”画成时序图,是 MPSoC 系统设计必须交付的一页。
七、Versal NoC 深论:声明式互联的模型、带宽与约束
Versal 最根本的变化是把系统互联从可综合的 AXI 开关变成硬化的片上网络,理解其模型才能用对它。NoC 由若干 NMU(NoC 用户接口/主入口,AXI 入端口)、NSU(从出口,接 DDR 控制器等)和内部路由组成,工具按用户声明的连接关系、时钟域、带宽/QoS 参数在硬化网络上实例化通路;DDR 控制器(PMC 管理的硬控制器)、MCDMA、PL 主口、PS 都挂到网络上。相比手工 crossbar,它消除了大量 LUT/BRAM 和时序不收敛的互联逻辑,跨时钟域在网络内部完成,延迟和带宽有可分析的结构(QoS 类、VC)。但这不是“无限带宽总线”:每条路由仍受通道速率、入口数量、DDR 端汇聚能力限制,多个主设备打同一 DDR 口时,约束仍是 DDR 保证带宽(专家 06);QoS 设置影响仲裁顺序和延迟上界,需要按业务配置而不是默认值。
使用方法学从“连线”改为“建模与约束”:在工具中声明 NMU 的 AXI 参数(位宽、ID、时钟)、目标映射、每路业务的带宽(Mbytes/s)与读/写比例、延迟要求;工具做可行性检查并报告布线/争用,不满足时要调整入口宽度、拆分通路或改变业务假设。设计 NoC 时应把它当作网络而不是开关:估算每跳延迟(数据手册给典型值,配置后以工具报告为准)、为实时流预留带宽类、避免一个超大 NMU 汇聚所有源(多个入口更利于并行和 QoS)、把控制流量与数据流量分到不同入口。调试上 NoC 提供内部性能/错误监控(速率、占用、译码错误、毒数据),应像 AXI 计数器一样纳入遥测(专家 45)。迁移团队常见的不适应包括:地址映射在 NoC 上下文中定义而非互联地址编辑器;旧的“register slice 打拍提频”手段不再适用(网络自身流水化);某些 AXI 信号行为(如原子操作、用户信号)受 NoC 支持范围限制,需要查兼容矩阵。把系统架构图从“方框加 AXI 线”重画为“入口—网络 QoS—出口—DDR”的流图,是从 MPSoC 思维转向 Versal 思维的标志。
八、AI Engine 编程模型:kernel、stream、内存与协同设计
AI Engine(AIE)是 Versal 区别于一切前代 FPGA 的执行单元:一列(或多列)编译型 VLIW/SIMD 处理器阵列,每核含向量运算单元、标量单元、私有程序存储器和小容量数据存储,核间用 stream(流)互连,列边缘与 PL 经 stream FIFO/锁存器连接,对 DDR 的大块数据访问经 NoC。开发用 C/C++ 写 kernel(带数据流和窗口 API),编译器做指令调度、内存分配和阵列映射,仿真用专用的编译器/模拟器和波形接口;它不是“在 FPGA 里放了个 ARM”,也不是 HLS 生成 LUT 电路,而是空间分布的软件可编程处理器阵列。适用问题有共同形状:高吞吐、规则、向量密集、流式、数据局部性好——多相信道处理、FFT/滤波/矩阵运算、某些推理算子。控制分支密集、稀疏、位级协议处理仍属于 PL 或 A72。
协同设计的核心是存储层级与数据流。AIE 的性能不取决于单核算力峰值,而取决于喂数:核内存储小,数据应经流在核间逐级处理形成流水线(一个 kernel 的输出直接是下一个 kernel 的输入),避免反复往返 DDR;与 PL 的边界按 stream 连接(PL 里的 RTL/AXI-Stream 产生/消费数据),与内存的大块交换经 NoC/DMA 按块(window/buffer)进行。典型分区:前端采样/协议和位操作在 PL,规整向量处理在 AIE 阵列,调度、参数、网络与结果管理在 A72,DMA/NoC 做数据编排。工程上要掌握的新概念包括:graph(kernel 与连接的静态描述)、tile(阵列单元)、内存库冲突(多口访问同一存储体会串行化,是常见性能杀手)、调度与同步(锁/事件/DMA 描述符)、确定性时序(阵列以确定时钟执行,适合实时信号链,但与 DDR/PS 的交互仍需缓冲和 QoS)。验证分层:kernel 级用编译器仿真,graph 级用事务级模型,系统级用 PL+AIE 协同仿真再上板;调试可见性弱于纯软件,需要在设计期规划性能计数器和状态导出。评估是否采用 AIE 的务实路径:先在 CPU 上量化算法的向量运算占比和数据复用率,复用率低、每字节都要往返 DDR 的工作负载在 AIE 上常常达不到预期;适合时再投入掌握新工具链——这是架构赌注,不应在项目中途无验证地引入。
九、平台迁移工程:7000→MPSoC→Versal 的检查单
三代平台迁移不是换器件型号,而是三类不同的工程动作,应分开评估。7000→MPSoC 的迁移项:处理器从 32 位 A9 变 64 位 A53(指针宽度、汇编、内核和驱动、设备树均要 64 位化),新增 R5(实时任务重新分配,见第五节);DDR3→DDR4(控制器、PHY、板级、校准全面重做,专家 06);HP 口配置、缓存一致性(CCI/HPC)、PS GTR(USB3/SATA/PCIe/DP 复用的硬核收发器,引脚和协议规划完全不同);启动链增加 PMUFW/ATF、安全启动能力;电源树按多电源域重设计。PL 侧 RTL 多可综合移植,但时钟资源、原语(MMCM/URAM/DSP48E2)和时序约束要重签,时序收敛不能沿用旧报告结论。MPSoC→Versal 的迁移项:思维模型增加 NoC(第七节)和 AIE(第八节);传统 PL 继续存在(Adaptable Engine),DSP/BRAM/URAM 和收发器(GTY 更高速率、PAM4 选项)演进,高速设计重做裕量;管理固件变为 PLM(Platform Management Controller)+ 运行时栈(XRT 等),开发流转向 Vitis 平台/扩展(Vivado 仍是 PL 硬件工具);时钟、电源、配置接口按 Versal PCB/架构指南重新设计。
跨代通用纪律:建立“复用—重参数化—重写”三栏清单(业务 RTL 多在复用栏,互联/内存/启动在重参数化或重写栏);接口抽象层(寄存器规范、DMA 客户端 API、时序控制)在原平台就解耦干净,迁移成本主要由架构解耦程度决定而非代码行数;不要试图在新平台复刻旧平台的手工时序优化(新结构的最优实现不同);先做垂直切片(最小数据通路打通:DDR→NoC/互联→处理→主机)再全面移植;安全、启动、热、电源要在架构阶段而不是收尾阶段介入。团队技能同样需要迁移计划:软件侧从“裸机/Linux 驱动”扩展到多核生命周期/TrustZone/OpenAMP,硬件侧从“AXI 连线”扩展到 NoC QoS,算法侧需要能驾驭 AIE 数据局部性的人。把迁移当项目而不是当升级,是避免周期失控的关键。
十、选型决策与异构架构建议
最后给出平台选择的决策框架。继续选 Zynq-7000 的条件:控制+中等数据量、成本敏感、7 系 PL 资源足够(少量 1080p 视频、百兆/千兆网络、低速采集与运动控制)、生态成熟、团队已有资产;它在大量工业产品中仍是性价比最优解。选 UltraScale+ MPSoC 的条件:需要 64 位 Linux 与强应用性能、需要硬实时/安全域(R5、锁步)、多路 10G 级接口、DDR4、更大 PL;典型为高端工业控制、车载/轨交、医疗、边缘网关、多路视频。选 Versal 的条件:存在大规模规则向量/信号处理负载(无线、雷达、高密度 ML 推理前端)、需要高速 SerDes/硬 NoC 带来的集成度收益、团队有能力投入新工具链和架构模型;若只是传统控制+数据采集,Versal 的复杂度和成本不会自动转化为收益。无论哪一代,都应先用端到端带宽/延迟预算(传感器→PL→内存→主机/显示,逐段扣减)和任务—执行域映射表验证架构,再选器件;反向流程(先定“用最新芯片”再找负载)几乎必然造成资源闲置或关键路径错配。
异构架构的通用建议有四条:第一,每个功能按频率/复杂度/确定性三维落位到最合适的域,跨域只传递控制消息和成块数据;第二,安全与实时底线放在最确定、生命周期最长的域(PL/R5),Linux 负责可重启的复杂面;第三,接口一次设计到位(寄存器规范、DMA 描述符、核间 ABI、版本握手),这些抽象的寿命应长于任何单个处理器代际;第四,可观测性内建(各域时间戳对齐、跨域事件日志、性能与错误计数器),异构系统的集成成本主要花在跨域故障定位上。把这四条与各平台的启动/内存/一致性细节结合,就能把“器件选型”变成可论证的系统工程决策,而不是营销资料驱动的赌博。
十一、核间通信与多处理器数据共享:OpenAMP 模型与手工方案
MPSoC 上 A53、R5 与 PL 并存后,核间通信(IPC)成为新的设计面。标准方案是 OpenAMP:Remoteproc 负责远端处理器(通常是 R5)固件的生命周期(加载、启动、停止),RPMsg 在共享内存上提供基于 virtqueue 的消息通道(带门铃中断),Linux 侧表现为 rpmsg 字符设备/驱动,R5 侧跑 OpenAMP 库。它适合小消息、命令、异步事件,不适合直接搬大流量数据——virtqueue 的缓冲拷贝和中断节奏决定了它是控制通道。大数据应采用“共享内存+所有权交接”:在保留内存(carveout,设备树声明、对各核可见、缓存属性明确)中放数据池和描述符环,RPMsg 只传“第 N 块就绪”的短通知;这与 DMA 环形描述符是同一种模式。设计要点:carveout 内存属性在各核页表中必须一致规划(non-cacheable 最简单;用缓存则两端都要做 clean/invalidate 并注意 R5 与 A53 缓存维护指令/服务的差异);门铃用硬件中断而非轮询;消息格式带版本号和长度字段,为固件独立升级留余地。
资源管理要避免“两个主人”:某外设/中断/内存区在任一时刻只能有一个核拥有,通过 rsc-table、设备树和一张“资源所有权表”集中声明(PL 复位控制器、看门狗、安全 GPIO 等尤其敏感)。启动模式(A53 引导 R5,还是 FSBL 直接启动 R5)决定故障模型:安全监控类功能应让 R5 由 FSBL 直接启动且不依赖 Linux 存活。没有 OpenAMP 需求或想完全控制时,可以手工实现“共享内存环形队列+硬件信号量/邮箱中断”,本质相同但要自己解决缓存同步、启动握手和超时恢复。无论哪种方案,都要做压测:双向小消息风暴、大块数据通知与消息混合、Linux 重启(remoteproc stop/start)期间 R5 的行为、共享区越界检测。IPC 层的稳定性往往比功能本身更决定多处理器系统的现场口碑。
十二、实时路径设计:从 A53 到 R5/PL 的延迟分解
“实时”不是单一指标,设计前必须把需求拆成周期、截止期、抖动、可用性四要素,再为每段路径分配预算。一个典型控制环:传感器接口(PL,亚微秒级时间戳与捕获)→PL 预处理/判决(确定周期)→R5 控制计算(数微秒到数十微秒,FreeRTOS 高优先级任务或裸机中断)→执行器输出(PL/R5 外设)。Linux/A53 完全在环路之外,只负责参数下发、日志和界面。若误把控制计算放 A53 用户态,延迟链会包括:中断响应到内核、唤醒调度、用户态抢占、cache miss,p99 抖动可能从微秒放大到毫秒,PREEMPT_RT 能改善中位数但难以承诺硬截止。R5 实时性的获得也有条件:关键代码和数据放 TCM 或写回缓存且避免 DMA/总线争用导致的不可预测停顿;中断优先级分组、把高优先级 ISR 与普通处理分开;关闭不必要的诊断窗口(扫描、调试端口)对执行时间的干扰;用锁步时还要接受比较器带来的配置约束。
PL 与 R5 的接口应尽量短:可用窄 AXI 从口/快速链路传控制结构,数据流用流式或双口内存,避免经 DDR 绕一圈。测量方法论同样关键:用一个 GPIO 在事件进入和输出时翻转,示波器测端到端延迟分布(百万次以上,给出 p50/p99/p999),而不是只看软件时间戳;在 CPU 高负载、网络流量、DDR 拥塞的最坏组合下复测。安全相关路径还要考虑故障检测时间:R5 看门狗、PL 独立超时、A53 心跳三者分工,任何一个环节死掉都能在规定时间进入安全态(与功能安全 专家 24 衔接)。最终交付的是一张“信号→各执行段→执行器”的延迟预算表和实测直方图;没有这张表,“系统是实时的”只是一句口号。
十三、迁移与选型清单:异构平台的一页纸决策
把 7000/MPSoC/Versal 的选型与设计落成可勾选项。需求澄清:是否需要 Linux 与 64 位生态;硬实时任务数量、周期与 ASIL/认证要求;数据面端到端带宽与延迟;是否需要 R5 独立于 Linux 的安全底线;向量处理占比(决定 AIE);功耗与供电散热预算;供货周期与成本红线。架构输出:任务—执行域映射表(A53/R5/PL/AIE);跨域数据流与带宽矩阵(套用 专家 11 方法,Versal 用 NoC QoS 表达);端口选择(GP/HP/HPC/ACP/NoC NMU);内存分区与缓存属性表;中断聚合与 IPC 方案;启动链、安全启动与 A/B 升级图;电源域与唤醒链;调试/日志时间基。软件输出:设备树来源与生成流程、驱动分层、固件组件版本矩阵(PMUFW/FSBL/ATF/u-boot/kernel/R5/bitstream)、OpenAMP 资源表、产线自检模式。验证:垂直切片先行(上电到数据流);72 小时混合负载;Linux 重启/崩溃注入;升级回滚;温压角性能;安全启动篡改测试。
一条贯穿建议:先做垂直切片再扩功能。异构项目最危险的路径是各域并行开发数月、集成时才发现带宽模型、缓存一致性或启动顺序假设错误;在项目前几周用最朴素的 PL kernel+R5 心跳+Linux 驱动打通“启动→控制→数据流→中断→回收”全链,能以极低成本暴露 80% 的架构问题。Zynq 系列的真正难点从来不是某个 IP 怎么例化,而是跨处理器、跨内存模型、跨生命周期的系统纪律;掌握这些,平台从 7000 换到 MPSoC/Versal 都只是同一张决策表上的参数更新。
十四、异构平台的可观测性、调试与现场升级
三域系统(A53/R5/PL,Versal 再加 AIE/NoC)的调试复杂度是非线性增长的,必须在架构期投入可观测性,不能等出问题再拉 JTAG。启动可观测:PMUFW/FSBL/ATF/u-boot 各阶段日志通过独立 UART 或共享内存缓冲区输出,记录每阶段耗时和返回码;启动失败时能精确定位到分区验签、DDR 训练还是比特流配置。运行时分层日志:Linux 侧 syslog/结构化日志,R5 侧轻量环形 trace(带周期计数),PL 侧事件 FIFO(专家 45),AIE 侧性能/状态计数器;三路日志用硬件全局时间戳相关,PS 定期收集到统一快照。NoC 提供的速率/占用/错误寄存器要接入同一遥测,Versal 上“数据慢了”首先看 NoC 统计而不是猜。崩溃现场:A53 kernel panic、R5 异常、PL 检测到的致命事件都触发一次“现场冻结”——各域把核心寄存器、关键 FIFO 水位、NoC 计数器写入保留 RAM/持久存储,复位后由恢复软件导出,这是现场问题唯一可靠的尸检材料。
现场升级要覆盖全部组件且保证可恢复:镜像按 A/B 双分区组织(FSBL 先尝试新槽位、健康检查失败自动回滚旧槽位),PMUFW/FSBL/ATF 作为受信任链组件需要整体兼容验证;比特流可在 Linux 运行时经 FPGA Manager 更新,PL 重配置前业务先静默(停 DMA、排空 FIFO、通知对端),配置后重新握手;R5 固件升级通过 remoteproc 重启完成,但安全 IO 由 PL 保持的设计要先验证安全态。Versal 上 PLM/XRT 与外壳(shell)、内核(partition/kernel)分离的部署模型值得借鉴:稳定的平台管理部分少动,业务部分快速迭代(部署模型见 20 比特流烧录与四方版本一致 manifest/门禁)。安全调试口:JTAG/跟踪端口在量产熔断策略与工厂调试需求之间要有明确方案(认证解锁或一次性失效),防止现场设备被任意挂调试器。最终检验标准很朴素:设备在客户现场出现任何故障时,工程师不拆机、不挂 JTAG,仅凭导出的快照就能把问题归到某个域的某个模块——做到这一点,异构平台的复杂度才算真正被工程化管理,而不是在每个项目里重新交一遍学费。这也是从“会用某颗 Zynq 芯片”到“掌握一类异构 SoC 架构方法”的真正分界;前者依赖工具向导和参考设计,后者能在没有现成模板的新平台上依然做出可验证、可交付、可维护的系统决策。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 把实时任务塞 A53+Linux | 调度抖动不可控 | 硬实时放 R5 或 PL |
| Versal 还想手搭大 crossbar | 违背平台设计 | 用 NoC 声明带宽 |
| 向量算法全用 RTL 堆 DSP | 功耗/开发量大 | 规则向量密集用 AIE |
| 64 位沿用 32 位假设 | 指针/驱动出错 | 工具链/驱动按 64 位 |
| 忽略 PMU/PLM 启动链 | 板子起不来 | 按新启动流程构建镜像 |
| R5 锁步当普通双核 | 资源/配置错 | 安全需求才锁步 |
相关与延伸
基础:Zynq 入门、HLS。 数据通路:AXI 互联、Zynq 数据交互、DMA 架构。 AI 加速见专家层《FPGA AI 推理加速》。
一句话总结
从 Zynq-7000 到 UltraScale+ MPSoC,PS 升级为四核 64 位 A53(Linux 管理域)+ 双 R5 实时核(裸机/FreeRTOS,低延迟确定、可锁步做功能安全),PL 升级到 UltraScale(DSP48E2/URAM、GTH/GTY、DDR4),系统分成管理/实时/数据三域——把硬实时和安全任务从 A53 或 PL 剥离到 R5。Versal ACAP 则是范式转变:用 NoC 片上网络替代手工 AXI crossbar(声明带宽/QoS,路由仲裁跨时钟域时序全由硬件保证),新增 AI Engine 向量处理器阵列(C/C++ 编程的 VLIW/SIMD 核,擅 5G/ML 等规则向量密集计算,单位功耗向量密度高于通用 PL,与 PL 经 stream、与 DDR 经 NoC 协同),管理走 PLM/XRT、开发统一到 Vitis。迁移工程上:DDR3→DDR4、32→64 位工具链驱动适配、实时任务用 R5、启动链增加 PMU firmware/ATF/PLM,RTL 本身大多可移植,重在 IP 重参数化和架构思维更新(互联靠 NoC、向量靠 AIE)。