数据库的复兴:为什么新数据库又层出不穷
最后更新:2026-09-16
本文是产业观察的一篇。数据库被认为是最成熟、最"铁板一块"的基础软件,关系型数据库统治了几十年;可最近十余年,NoSQL、NewSQL、云原生数据库、HTAP、时序库、图数据库、向量数据库、Lakehouse 轮番登场,新公司和新产品层出不穷。一个如此成熟的领域为什么会"复兴"?本文的答案是:不是旧数据库突然不好用了,而是负载形态和底层资源(云、对象存储、AI)发生了根本变化,新数据库是按新负载重新切分市场的结果。 技术细节见数据库目录、MySQL 索引,云的底层逻辑见云原生目录,开源/商业化的纠缠见开源怎么赚钱。
先说结论
- 每一波新数据库,都是被一种"旧库不擅长的新负载"逼出来的。 NoSQL 对应互联网海量水平扩展与灵活 schema;NewSQL/分布式 SQL 想同时要扩展性和事务;时序库对应监控/IoT 的写入与压缩;HTAP 想打通交易与分析;向量库对应大模型的语义检索(RAG)。新负载而非新理论,是复兴的主引擎。
- 云改变了数据库的"物理形态":存算分离 + Serverless 成为默认。 传统数据库假设计算与存储绑定、单机纵向扩展;云上把存储放到弹性/共享层、计算节点无状态化,实现独立扩缩容、按用量计费、秒级弹性,多租户 SaaS 也成为原生形态。这是一次架构范式而非简单搬家。
- 对象存储 + 开放表格式正在重写分析市场(Lakehouse)。 把数据湖的廉价海量存储与数据仓库的事务、Schema、性能结合,用开放格式(Parquet/Delta/Iceberg/Hudi)避免厂商锁定,重新切分了 BI、数仓和大数据的版图。
- AI 是最新、也最被炒作的一波:向量检索从冷门插件变成独立品类。 大模型让"语义相似度检索(embedding + 向量索引)"成为 RAG 的刚需,带火向量数据库;但向量能力也正被传统库(PostgreSQL 扩展)和 OLAP/湖仓吸收,独立向量库能否长期成立仍有争议。
- 对工程师:选型应从负载和数据特征出发,警惕"每波新名词都迁移一次"。 大多数团队的大多数负载,一个成熟关系库(含其扩展)仍然够用;新数据库解决特定问题的同时,也带来新的运维、一致性、生态和人才成本。
一句话:数据库的复兴是"负载分化 + 云资源重构 + AI 新需求"三股力量共同撕开的市场再细分;新物种没有推翻关系模型,而是在它不擅长的扩展性、实时分析、海量半结构化和语义检索方向上各建专长——赢家不是概念最新的那个,而是最贴合你真实负载、且总拥有成本和生态可持续的那个。
一、为什么是现在:三股驱动力
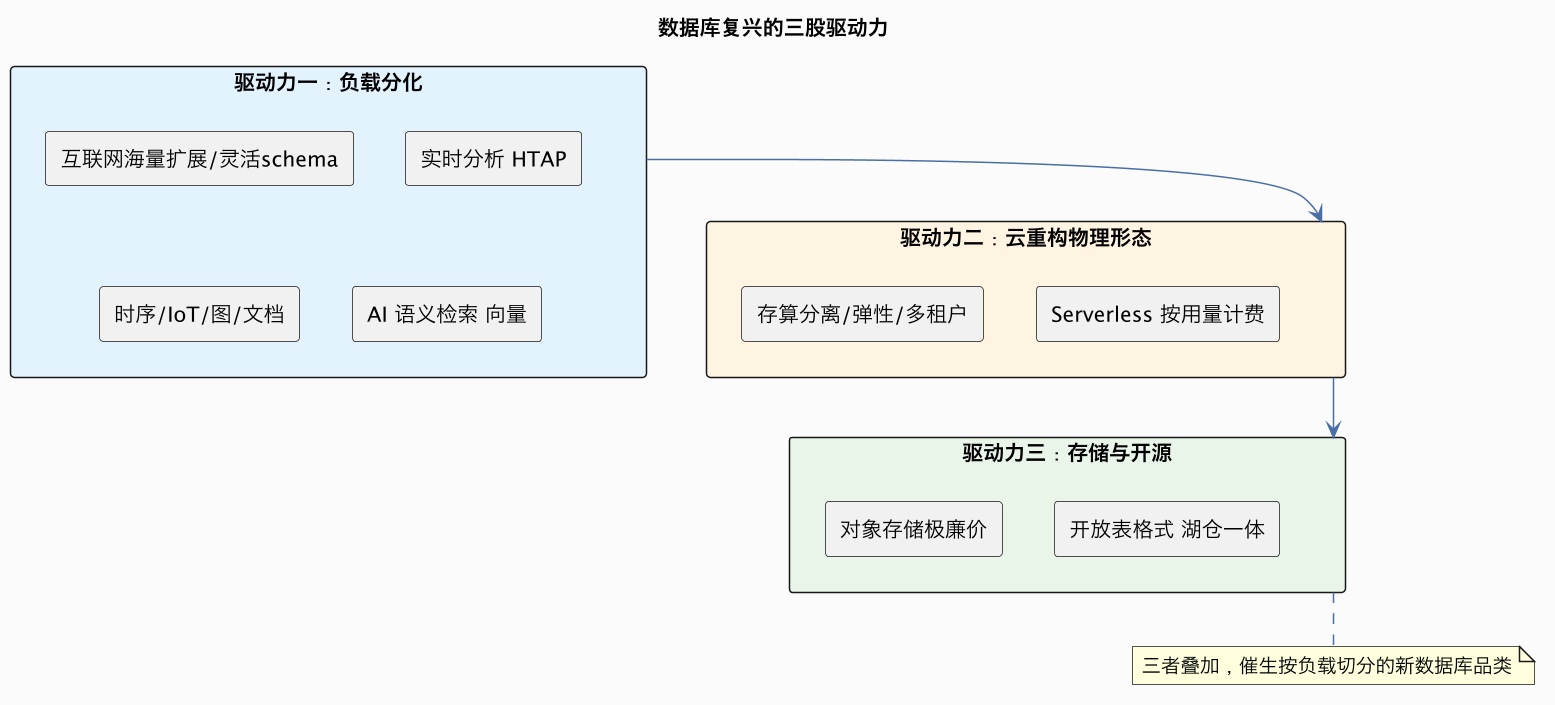
- 负载分化:从"一个关系库走天下",变成交易、分析、时序、文档、图、宽表、键值、向量等差异极大的负载,单一引擎难以在所有维度最优。
- 云重构:弹性资源、网络存储、容器、Serverless 让"按需付费、无限弹性、免运维"成为客户预期,数据库被重新设计为云原生形态(与从卖盒子到卖 Token 的效用化同源)。
- 存储与开源:S3 式对象存储把每 GB 成本压到极低,开放列式格式与开源引擎让"在廉价存储上做高性能分析"可行,开源协作又降低了新引擎的推广门槛(开源商业化见开源怎么赚钱)。
二、几条主线,各自解决旧库的哪道墙
2.1 NoSQL → NewSQL:扩展性与事务的再平衡
这是一场经典钟摆:早期关系库强一致、强 schema,但在互联网海量数据下难以水平扩展;NoSQL(键值、文档、宽表、图)牺牲部分事务和一致性换取扩展性与灵活模型;随后 NewSQL/分布式 SQL 又试图把"水平扩展 + ACID 事务 + SQL"三者都拿回来。工程上分布式事务、一致性的代价见分布式一致性。
教训:"用不上的一致性"是成本,"用得上却没有的一致性"是事故。 很多团队在并不需要极致扩展时引入 NoSQL,事后又补事务、补 join、补强一致,等于重新实现一个更差的关系库。
2.2 HTAP:推倒交易与分析之间的墙
传统上 OLTP(交易,行存、点查、高并发短事务)和 OLAP(分析,列存、大扫描、聚合)是两套系统,靠 ETL 在夜间把数据从交易库搬到数仓,结果是分析永远滞后于业务。HTAP(混合事务/分析)用行列双存、副本隔离等手段在一套系统里同时支撑实时交易和实时分析,服务风控、实时推荐、实时看板。代价是引擎复杂度和资源隔离难度上升。
2.3 云原生与 Serverless:存算分离改变弹性模型
| 维度 | 传统数据库 | 云原生数据库 |
|---|---|---|
| 架构 | 计算存储绑定、主从复制 | 存算分离、共享/分布式存储、无状态计算 |
| 扩展 | 纵向为主,扩容要停机/复杂 | 计算/存储独立弹性,分钟级/秒级 |
| 计费 | 买 license/服务器(CapEx) | 按规格/用量(OpEx),Serverless 可缩到零 |
| 多租户 | 各自部署 | 原生共享底座、隔离与运维自动化 |
| 高可用 | DBA 手工搭建 | 多副本、跨 AZ 内建 |
这让数据库从"装机的软件"变成"拧开即用的服务",也是云厂商最赚钱、绑定最深的品类之一。
2.4 Lakehouse:在廉价对象存储上重建数据仓库
数据湖(便宜、存原始数据、格式杂)和数据仓库(贵、结构化、分析快)长期割裂。Lakehouse 用对象存储上的**开放表格式(Apache Iceberg、Delta Lake、Apache Hudi)+ 列式文件(Parquet)**给数据湖加上 ACID 事务、Schema 治理、时间旅行和接近数仓的查询性能:
- 用开放格式对抗专有数仓的锁定(数据在你自己的对象存储里);
- 一份数据同时支撑 BI、数据科学、流式入库和(新增的)AI;
- 与对象存储/云的弹性计费天然契合。
它重新分配了 ETL、数仓、BI 工具厂商的价值,也是近年数据库/大数据圈竞争最激烈的方向。
四、复兴背后的钟摆与收敛
热闹背后有一条清晰的规律:行业每隔几年就把"专"与"统"重新摆一次。
- 专用化:出现一种新负载,专用引擎凭借极致优化快速崛起(图、时序、向量、流式 OLAP)。
- 统一化回摆:当专用引擎太多、数据孤岛和运维负担变重,平台型产品开始把这些能力收编进一个更大的系统(PostgreSQL 用扩展兼容几乎一切;OLAP/湖仓加向量;关系库加 JSON/时序;云厂商卖"全家桶")。
- 再分化:统一带来妥协,当某个负载大到值得为它单独优化,新的专用引擎又出现。
PostgreSQL 是"统一化"的典型:凭借可扩展架构,它在关系内核上长出 JSON/文档、时序、地理空间、全文、向量等能力,常被称为"一个人就是一个数据库生态"。这与开源生态的商业化相互成就(扩展/托管/企业版变现,见开源怎么赚钱)。
对从业者的含义是:新品类会不断出现,但只有那些对应足够大、足够持久、且通用引擎确实做不好的负载的,才会沉淀下来;其余会被平台吞并或回到小众。 判断一个"新概念数据库"值不值得押注,就看它解决的负载是不是真的又大又独特。
五、容易踩的坑
- 简历驱动 / 名词驱动选型:为用新技术而用,忽视真实负载,导致在不需要扩展时背上分布式运维。
- 低估一致性与迁移成本:从关系库迁出后,在应用层重造事务、join、外键、唯一约束;数据搬迁和双写一致性长期还不上。
- 忽视运维与人才:新数据库的调优、备份恢复、版本升级、故障排查人才稀缺,社区和托管成熟度差异巨大。
- 供应商锁定:云原生/Serverless 数据库很省心,但专有格式和深度托管可能让迁出代价极高,需要在早期评估开放格式与可移植性。
- 向量库过度投资:RAG 还在快速演化,向量能力正被通用数据栈快速吸收,过早重度绑定单一专用方案有被整合的风险。
- 湖仓/实时的复杂度:数据契约、血缘、质量治理、批流一体的工程难度,常被"一个平台解决所有"的宣传低估。
六、对工程师的启示
- 把"负载建模"作为第一技能:能说清读写特征、一致性要求、数据规模增速和查询模式,比记住更多产品名更重要。
- 吃透关系模型这门"常青基本功":NoSQL/NewSQL/HTAP 的兴衰说明,事务、索引、查询优化、范式与反范式这些原理(如MySQL 索引)跨越产品周期长期保值。
- 理解云原生数据栈:存算分离、Serverless、多租户、对象存储与开放表格式,是数据平台岗位的新通用语(见云原生目录)。
- 保持架构中立的可移植意识:优先开放格式与标准接口,给数据和应用留出在引擎/云之间迁移的后路。
- 职业判断:分布式数据库内核、查询优化、实时/流式处理、湖仓与数据工程、向量检索/RAG 工程,是被负载趋势持续拉动的方向。
相关与延伸
- 关系库基本功:MySQL 索引、数据库目录
- 拆分系统后的一致性代价:分布式一致性
- 云与 Serverless 的效用化:云原生目录、从卖盒子到卖 Token
- 开源数据库为何频繁改协议:开源是怎么赚钱的
- AI 催生的向量检索与 RAG:数据与 AI、AI 编程工具
一句话总结:数据库的复兴不是旧技术被推翻,而是"负载分化、云重构物理形态、对象存储与 AI 创造新需求"三股力量逼出的市场再细分——NoSQL/NewSQL、HTAP、云原生、Lakehouse、向量库各自去啃关系库不擅长的那道墙,又在规模起来后被平台型引擎收编;工程师的正确姿势是先用负载建模选最小够用的成熟方案、守住关系模型这门常青基本功,而不是在每一波新名词里迁移一次。
2.5 向量数据库:AI 一夜捧红的新品类
大模型有两个短板:知识截止、私有/最新数据不知道。RAG(检索增强生成)的解法是:先把文档切块转成 embedding 向量,按"语义相似度"检索出最相关片段,再喂给模型。支撑这种高维近似最近邻(ANN)检索的就是向量数据库/向量索引。
- 为什么需要专门结构:亿级高维向量上的精确最近邻太慢,要靠 HNSW、IVF 等近似索引在召回率和延迟间折中。
- 会不会长期独立成"库"有争议:PostgreSQL 的向量扩展、OLAP 引擎、湖仓、甚至专用检索服务都在把向量能力收编;纯向量库需要在规模、混合检索(向量 + 标量过滤 + 全文)、运维和与数据栈集成上证明不可替代性。这是典型的"新品类被平台吞并"风险,和框架/中间件史上反复发生的整合一致。
三、一张选型认知表:按负载对号入座
| 你的主要负载 | 更匹配的形态 | 不要先考虑 |
|---|---|---|
| 高并发短事务、强一致、关系完整 | 关系型 / 分布式 SQL | 仅为"听说过时"上 NoSQL |
| 读多写少、文档结构多变 | 文档库 | 强行三范式 |
| 海量监控/事件高频写入、按时间查 | 时序库 | 用通用 OLTP 硬扛 |
| 复杂关系网络、多跳查询 | 图数据库 | 用大量 join 模拟 |
| 实时交易 + 实时分析一体 | HTAP | 靠夜间 ETL 勉强支撑 |
| 海量结构化分析、BI、数据科学 | 列存 OLAP / Lakehouse | 在交易库上跑全表大聚合 |
| 大模型语义检索 / RAG | 向量索引(专用库或库扩展) | 用 LIKE/关键词全文模拟语义 |
| 流量波动大、想免运维 | 云原生 / Serverless 数据库 | 为峰值长期自购重资产 |
基本原则:先刻画负载(读写比、事务边界、一致性要求、数据规模与增速、查询模式、延迟/吞吐 SLA、团队能力),再选最小够用、生态最成熟、总拥有成本最低的那一个。