Chiplet 是先进封装的救命稻草吗:die-to-die、UCIe 与封装成本真相
最后更新:2026-09-16
本文是产业观察的一篇。当"把晶体管做小"越来越贵、越来越难,业界把希望寄托在另一条路上:与其在一块硅上做一颗巨大的芯片,不如把它拆成几颗小芯片(die / chiplet),再用高密度先进封装像乐高一样拼回去。这套思路被 AMD、苹果、英伟达和一众国产 AI 芯片公司采用,也被写进了很多"绕开先进制程"的叙事。本文不重复《HBM 与先进封装》里的产能与国产化分析,而是回答三个更工程的问题:Chiplet 在数学上到底省不省钱、die-to-die 互联和封装新增了什么成本、什么芯片才真正适合拆。 良率与成本的基本原理见《一颗芯片值多少钱》,制造分工见《Fabless 与 Foundry》。
先说结论
- Chiplet 的第一性原理是良率,不是情怀。 晶圆制造的随机缺陷决定了:die 面积越大,摊上致命缺陷的概率越高、良率越低、成本随面积超线性上涨。把一颗巨型 die 拆成几颗小 die,每颗小 die 良率都很高,再通过"已知良好裸片(KGD)+ 先进封装"组装,可以在成本和良率上跑赢单颗大 die——这是 AMD 早年用多 die 拆分对抗单颗大 GPU/CPU 的核心逻辑。
- 但拆分不是免费的,它把成本从"晶圆"搬到了"封装 + 互联 + 设计 + 测试"。 die-to-die 需要超高速、超低功耗的 PHY 和大量凸点/硅通孔(TSV),需要硅中介层(2.5D)或 3D 堆叠,这些封装工艺(CoWoS、EMIB、Foveros)本身贵且产能紧;多 die 还要做 KGD 测试、跨 die 时序与热设计,NRE 显著上升。小芯片、量不大的产品用 Chiplet 反而更贵。
- UCIe 在解决"能不能混搭"的生态问题,但标准统一≠壁垒消失。 die-to-die 过去各家私有协议,chiplet 无法跨厂商拼装;UCIe 想做"芯片界的 USB-C",定义统一的 PHY 和协议层。但真正把多家不同工艺、不同厂商的 die 可靠地封进同一封装,还涉及封装基板、D2D 一致性、可测试性和责任划分,落地仍在早期。
- "Chiplet 绕开先进制程"是被夸大的叙事。 它确实让"用成熟制程做部分 die、只把关键 die 上先进节点"成为可能,也能缓解单颗大 die 良率与光罩尺寸(reticle limit)限制;但高端 AI 芯片的计算 die 仍然要最先进制程,先进封装(CoWoS、HBM)反而是新的、更紧的瓶颈(见HBM 与先进封装)。Chiplet 是架构选择,不是制程落后的万能补丁。
一句话:Chiplet 是用"先进封装和互联的钱"去换"大 die 良率和混合工艺的钱"——在量大、die 够大、需要混搭工艺/IP 的高端芯片上这笔交易划算,在小芯片和小批量上它是负收益;它缓解了但没有消除对先进制程的依赖,真正的护城河正从"谁能做最小晶体管"部分转移到"谁能把复杂系统又快又便宜又可靠地封在一起"。
一、为什么要拆:先算良率这笔账
理解 Chiplet,必须从一个反直觉的事实开始:芯片成本对 die 面积极度敏感。晶圆上的随机缺陷(尘埃、工艺瑕疵)服从概率分布,经典的 Poisson 良率模型给出近似关系:
单 die 良率  Y = e^( -D0 × A )
  D0 = 单位面积缺陷密度,A = die 面积
每颗良品 die 的有效成本 ∝ A / Y = A / e^(-D0·A)
含义是:die 面积 A 增大时,良率指数下降,单颗良品成本超线性上涨。而且单片晶圆能切出的 die 数 ∝ 1/A,本来就随面积线性减少——两头夹击,让"把一颗芯片做得特别大"在经济上急剧恶化。相关直觉见《一颗芯片值多少钱》。
把一颗面积为 4A 的大 die,拆成 4 颗面积为 A 的小 die,对比:
| 方案 | 单 die 良率(示意 D0·A=0.2) | 得到一套完整良品的概率 | 直观结果 |
|---|---|---|---|
| 单颗大 die(4A) | e^(−0.8) ≈ 0.45 | ≈0.45 | 一半以上的大芯片因缺陷报废,极贵 |
| 4 颗小 die(各 A) | e^(−0.2) ≈ 0.82 | 0.82⁴ ≈ 0.45(朴素) | 看似接近,但可用"冗余/择优+高 KGD"显著挽回 |
注:上表为帮助理解的简化模型,真实良率还要考虑缺陷聚集(负二项模型)、冗余核屏蔽(CPU/GCP 常屏蔽坏核当低规格卖)等。关键不是精确数值,而是小 die 的良率优势让"挑出好 die 再组装"在统计上可行。
Chiplet 的做法是:每颗小 die 先做已知良好裸片(Known Good Die, KGD)测试,只把通过测试的 die 拿去封装。配合冗余与分级(binning),可以把"任何一个缺陷导致整颗巨型芯片报废"的风险,转化为"只损失一颗便宜小 die"。当芯片大到逼近**光罩极限(reticle limit,约 800+ mm²)**时,单 die 物理上都做不出来,拆分更是唯一选择——高端 AI 加速器普遍撞上这堵墙。
二、拆完怎么连:die-to-die 互联与三种封装形态
拆开之后,原本在同一块硅上走线就能完成的通信,现在要跨 die,而且必须又宽、又快、又省电,否则"拆"带来的延迟和功耗会吃掉收益。这就是 die-to-die(D2D)互联和先进封装要解决的问题。
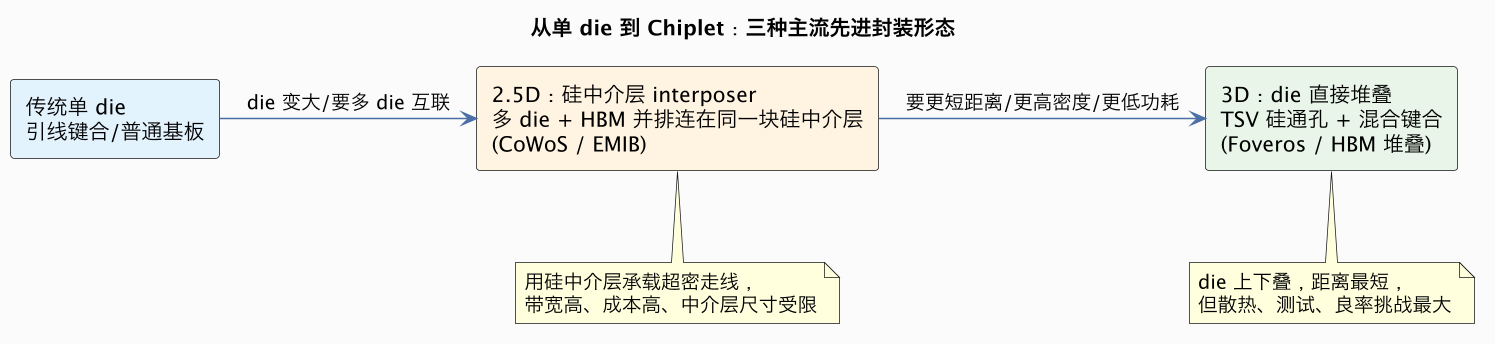
- 2.5D(CoWoS、EMIB):多颗 chiplet 和 HBM 并排放在一块硅中介层(interposer)或嵌入式桥接硅片上,中介层里做极细密的连线,提供超高互连带宽。这是当前高端 AI GPU 的主流形态,缺点是贵、产能紧(详见HBM 与先进封装)。
- 3D(Foveros、混合键合、HBM TSV 堆叠):die 直接上下堆叠,用 TSV 和微凸点/混合键合连接,距离最短、带宽密度最高、最省电,但散热(顶部 die 盖住底部)、KGD 测试和堆叠良率最难。
- D2D PHY:无论哪种形态,die 之间都要有专门的高速接口电路(PHY)和协议。它要占用 die 面积和功耗,是 Chiplet 的"过路费"。
三、UCIe:想做"chiplet 界的 USB-C"
早期 Chiplet(AMD Infinity Fabric、Intel、各家自研)的 D2D 协议都是私有的,意味着 A 家的 die 没法直接和 B 家的 die 拼,Chiplet 更像"一家公司内部的模块化"。**UCIe(Universal Chiplet Interconnect Express)**联盟想统一这件事:
- 定义从物理层(PHY,封装/基板两种实现)到协议层(兼容 PCIe/CXL 语义)的完整栈,目标是让不同厂商、不同工艺的 chiplet 像标准件一样互连。
- 价值类似 USB 之于外设:降低生态门槛、让第三方 chiplet 市场(I/O die、内存 die、加速器 die)成为可能。
- 但标准统一只解决"协议能不能通",没解决"封装可制造性、跨厂 D2D 时序收敛、KGD 测试责任、良率分摊"这些硬工程与商业问题。真正多供应商混封的量产案例仍有限,标准也还在快速迭代。
所以对"UCIe 一出,随便拼芯片"的说法要保留判断:标准是必要条件,不是充分条件。
四、成本真相:把钱从晶圆搬到了封装、互联、测试
Chiplet 节省的是"大 die 良率损失",但它新增了四类成本,这是判断它到底划不划算的关键:
| 成本项 | 单颗大 die | Chiplet 方案 | 说明 |
|---|---|---|---|
| 晶圆良率损失 | 高(面积大、报废贵) | 低(小 die 良率高、可用冗余) | Chiplet 的主要收益 |
| 先进封装 | 普通封装 | CoWoS/EMIB/3D,单颗数十到数百美元级 | 最大新增成本,且产能紧 |
| D2D PHY/互联 | 片上走线,近零 | PHY IP + 凸点 + TSV,占面积/功耗 | 每颗 die 都要带接口 |
| KGD 与测试 | 封装后测一次 | 每个裸片先测、组装后再测(堆叠后更难测) | 测试复杂度与成本大增 |
| 设计 NRE | 一套 | 多 die + 封装协同 + D2D 验证 | 前期投入高,需大量摊薄 |
由此得到一条清晰的经济规律:Chiplet 的 NRE 很高,只有当出货量足够大、能把固定成本摊薄,或者芯片大到单 die 撞光罩极限/良率不可接受时,它才划算。 它本质是高端、大量产品的游戏(服务器 CPU、AI GPU、高端交换芯片)。对一颗出货几万颗、die 不大的中小芯片,老老实实单 die、甚至用成熟一点的制程,总成本反而更低。
此外还有两个容易被忽略的收益:
- 混合工艺(异质集成):不同 die 可以用最合适的节点——计算 die 上最先进逻辑工艺,I/O die 用成熟工艺,SRAM/模拟 die 用其最划算的节点,3D 还可把缓存 die 与逻辑 die 各自优化。避免"为了一小块先进逻辑,逼整颗芯片都上最贵节点"。
- 模块化复用与分级(binning):同一批计算 die 可搭配不同数量缓存/I/O die 组成产品矩阵;屏蔽坏核、按体质分级也更灵活,摊薄平台研发成本。
五、"Chiplet 绕开先进制程"哪些是真、哪些是夸大
这是中文舆论里最常见的误读,需要把事实和判断分开:
成立的部分(事实):
- Chiplet + 成熟制程确实能在一定程度上扩大有效芯片规模、缓解单 die 良率和光罩极限,让"多颗成熟节点 die 拼出较大算力系统"在工程上可行。
- I/O、模拟、缓存等非核心 die 用成熟制程,可减少对最先进节点产能的依赖。
- 先进封装/HBM 是中国离前沿较近、封测(长电、通富等)处于第一梯队的环节,存在从封装侧先突破的现实机会(见HBM 与先进封装的中国位置)。
被夸大的部分(判断):
- 计算 die 本身的晶体管密度、速度、功耗仍然取决于逻辑工艺。 用成熟制程做的计算 die,在每瓦性能和单位成本算力上依然落后;拆成再多颗也改变不了单管的物理特性。
- 先进封装和 HBM 本身成了新瓶颈:CoWoS 产能、HBM 供给在 AI 周期里比晶圆代工更紧,"绕开一道墙、撞上另一道墙"。
- 多 die 互联的功耗与时序开销在数据搬运密集的 AI 负载里不容小视,不是无代价拼积木。
所以更准确的表述是:Chiplet 给了系统厂一个"优化成本结构、混搭工艺、扩大规模上限"的架构杠杆,但它不是制程落后的免费补丁;高端竞争里,先进逻辑工艺和先进封装两道门槛要同时过。
六、谁在用、往哪走
- AMD:最早把 chiplet 商业化做透的玩家之一,计算 die(CCD)+ I/O die 分离,按核心数灵活组装,良率与产品矩阵双收益。
- Intel/英伟达/苹果/Marvell 等:分别用 EMIB/Foveros、CoWoS+HBM 等形态在 CPU/GPU/交换芯片上推进。
- AI 加速器与国产芯片:受光罩极限、HBM 集成与供应约束,大量采用多 die + 先进封装;这也是国产高端芯片在受限条件下争取系统规模的重要路径,和国产 AI 芯片的训练/推理两本账直接相关。
- 趋势:D2D 速率与密度继续提高、3D 混合键合从 HBM 走向逻辑堆叠、UCIe 生态缓慢成形、封装与芯片设计的边界进一步融合("封装即架构")。
七、对工程师的启示
- 前端/架构:理解系统被"切分到不同 die"会如何改变延迟、带宽、功耗模型;D2D 的带宽/延迟要纳入架构预算,而不是事后补。
- 物理/封装协同(SiP/co-design):先进封装让芯片设计与封装基板、中介层、热设计高度耦合,跨 die 时序、电源完整性、热耦合是新增核心技能。
- DFT/测试:KGD、可测试性设计、堆叠后测试与冗余修复是 Chiplet 良率和成本的命门,DFT 价值进一步上升。
- 接口/IP:掌握 UCIe/D2D PHY、CXL/PCIe over die-to-die 等协议栈的工程师会更稀缺。
- 职业判断:先进封装、异质集成是被产业趋势和地缘约束双重放大的确定性方向,和先进封装/3DIC 工具纵深、标准单元库与 PDK等设计基础设施一起,构成新的能力高地。
相关与延伸
- 封装产能、HBM 与中国位置:HBM 与先进封装
- 良率/成本怎么算:一颗芯片值多少钱
- 制造与设计分工:Fabless 与 Foundry
- 先进封装/3DIC 工具链:先进封装与 3DIC 设计
- AI 芯片为何堆封装/HBM:国产 AI 芯片与算力管制
一句话总结:Chiplet 不是情怀也不是免费午餐,它是用"先进封装 + die-to-die + 测试设计"的新增成本,去换"大 die 良率、光罩极限和混合工艺"的收益——只有高端、大量、需要混搭的芯片才划算;它能缓解但绕不开先进制程,反而把一部分竞争焦点从"做小晶体管"推向"把复杂系统又快又便宜又可靠地封在一起"。