cache 替换策略验证:LRU/pseudo-LRU/random 的参考模型对拍、断言写法与覆盖率点设计
更新时间:2026-10-01。在验证专题的版图里,cache 替换策略验证是一个「小而深」的切口:DUT 的逻辑规模不大,但状态空间巨大、错误极其隐蔽——换错一路 cache,功能结果往往还是对的(数据还在别的路里或被 refill),性能却会悄悄劣化,等到硅后跑 benchmark 才发现为时已晚。本站已有不少可复用的弹药:SV scoreboard 队列实现 和 sv-scoreboard-predictor 模型 讲对拍骨架,cache 场景下的 memory 后门对拍 解决了「怎么偷看 cache 内部」,SVA 断言完整指南 给断言语法打底,covergroup 采样时机 和 cross 与 binsof 表达式 管覆盖率写法。这一篇把它们拧成一条针对替换策略的完整验证链:参考模型怎么建、LRU 类断言分几层、覆盖率点挖多深、随机激励往哪个方向偏。
本文要回答的问题
- 为什么 cache 替换策略的 bug 这么难抓,验证目标到底该定成什么?
- LRU、pseudo-LRU、random 三种策略的参考模型各怎么写,对拍粒度选「数据」还是「选中哪一路」?
- LRU 类策略的断言怎么分层——精确断言和弱不变量各自的适用边界在哪?
- 替换策略的覆盖率点该怎么设计,才算「替换状态机真的走全了」?
- 定向用例和随机激励怎么配合,才能高效踩到替换决策的角落?
一、为什么替换策略的 bug 是「沉默的劣化」
先认清对手。一个 N 路组相联 cache 的替换逻辑,输入是「这一组(set)当前的占用情况 + 访问命中了哪一路 + 各路的年龄/有效位状态」,输出是「refill 时踢掉哪一路(victim way)」。功能正确性上它有一层天然掩体:只要换出去的路不是马上要用的,读写数据全对,scoreboard 一片绿。错误的表现形式是「该留的被踢了」——之后访问 miss 率上升、总线流量变大、延迟变长。
这意味着三件事。第一,纯数据对拍抓不住替换 bug,必须显式建模「victim 选择」这个动作。第二,验证目标要分两层:正确性(victim 选择符合策略定义)和性能保真(miss 率不劣化于参考)。第三,激励必须把单个 set 打满——只有 set 内 N 路全 valid 时替换才真正发生,随机地址糊一大片很难集中打透一个 set,这是激励设计的核心约束。
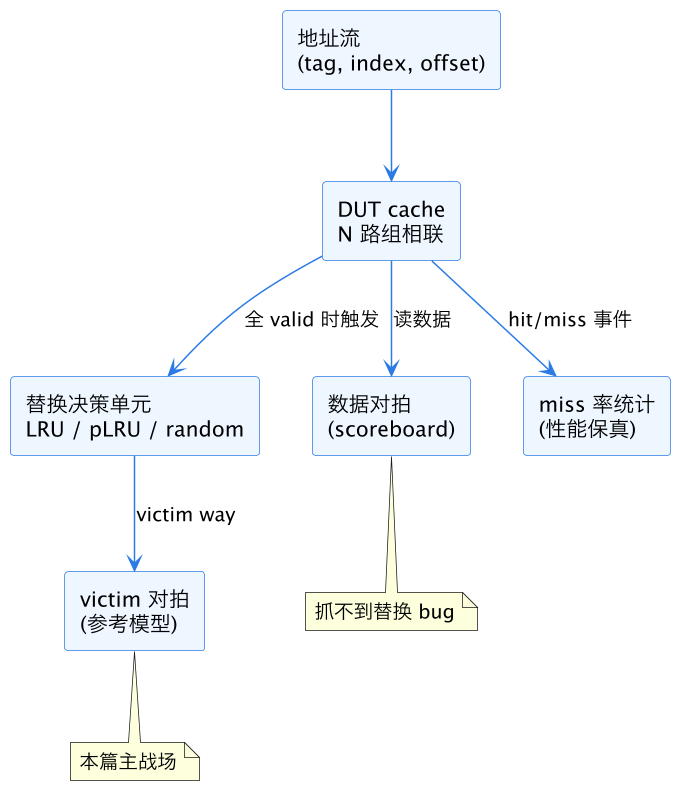
上图把三类检查的关系画清楚了:数据对拍是必要的但不是充分的,victim 对拍才是替换策略验证的主战场,miss 率统计兜底「断言没建模到的策略偏差」。后文三节分别展开这三条线的实现。
二、参考模型:三种策略的精确建模与对拍粒度
参考模型的职责是「给定同样的访问历史,独立算出每一步该踢哪一路」。三种策略的建模难度差别很大。
LRU(最近最少使用)最精确也最贵:每个 set 维护一个年龄栈,每次访问把命中路提到最新,victim 永远是最旧的那一路。SystemVerilog 里用队列或数组就能写,核心操作是「找到命中路在栈里的位置,删除后压栈顶」:
function int lru_victim(int set, int hit_way, bit is_hit);
  int q[$] = age_stack[set];
  if (is_hit) begin
    int pos[$] = q.find_first_index(w) with (w == hit_way);
    q.delete(pos[0]);
    q.push_front(hit_way);           // MRU 端
  end
  age_stack[set] = q;
  return q[$];                        // 队尾 = LRU victim
endfunction
pseudo-LRU(树形 LRU)用一个二叉树位数组近似 LRU:每次访问把从根到命中路路径上的指针全部拨向「另一边」,victim 则沿指针一路走到叶子。建模代码同样几十行,但有一个关键细节——pLRU 的状态是「位数组」而不是「年龄序」,参考模型必须按位数组语义更新,不能用真 LRU 队列近似,否则两者在 N 路大于 2 时会出现合法分歧:pLRU 本来就允许和真 LRU 不同的 victim 选择,那是算法特性不是 bug。
random 策略没法逐拍对拍 victim(它本来就是随机的),建模思路换成统计断言:同一状态下多次 refill 的 victim 分布应当接近均匀;以及「不该发生的确定性错误」仍然可查——比如选中了 invalid 路之外的固定偏好、set 未满时却触发了替换。这部分与 sv-random-stability 种子稳定性 里讲的随机可复现纪律相通:DUT 内部随机源不可控时,就用分布检验代替逐点比较。
对拍粒度上有一个工程取舍:直接对 victim way 编号,要求参考模型和 DUT 的「初始状态、访问序列、invalid 优先规则」完全同步,任何一个 tie-break 规则没对齐(比如多路同时 invalid 时选最小编号还是最大编号)就会刷出一堆假 mismatch。落地顺序建议:先对「refill 时 invalid 路优先」这条铁律,再对 LRU 栈序,最后才对 victim 编号逐拍精确对拍。对拍信号从哪来?monitor 从 refill 总线事务反推 victim,或者用 verify-memory-backdoor-scoreboard 里的后门路径直接读 tag array 前后快照对比——refill 前哪一路是旧的、refill 后哪一路换上了新 tag,两次快照一 diff,victim 不言自明,连专门的 victim 观测端口都不用加。
还有一个同步细节常被忽略:模型什么时候「吃掉」一次访问。写命中、写 allocate、写 no-allocate、cache maintenance 指令(clean/invalidate)对年龄栈的影响各不相同——invalidate 会把一路打回 invalid,等价于把年龄栈里对应项弹出。建模时把「一次访问对年龄栈的作用」封装成独立函数,由 monitor 上报的访问类型驱动,比散落的 if-else 好维护得多。写 no-allocate 的 miss 不进 cache,模型就不能更新年龄栈;这类「进不进 cache」的策略开关,建议和 DUT 共用同一份配置对象,由 uvm-config-object-resource-db 的机制下发,避免两边各写一份常量悄悄漂移。
三、LRU 类断言:精确断言与弱不变量两层写法
断言是参考模型之外的第二条腿,它的价值在于「不依赖模型同步、常驻回归、fail 即现场」。LRU 类策略的断言分两层。
第一层是精确断言,断言策略定义本身。以 2 路组相联(此时 pLRU 退化为真 LRU)为例:「刚被访问过的路,下一拍 refill 绝不选它做 victim」可以写成:
property p_hit_way_not_victim;
  @(posedge clk) disable iff (!rst_n)
  (hit_valid, w = hit_way) ##1 (refill_valid && same_set)
    |-> (victim_way != w);
endproperty
assert property (p_hit_way_not_victim);
4 路 pLRU 的精确断言要复杂些,本质是把「位数组语义」翻译成 temporal 语言:访问 way0/way1 后根指针拨向 1,则下一个 victim 必在 way2/way3 子树里。这类断言写起来繁琐,建议一个 set 内路数固定后用宏或 generate 批量生成,写法可参考 sva-checker-library-reuse 的可复用 checker 思路。
第二层是弱不变量,不断言「选了谁」,只断言「选择必须满足的必要条件」:
- victim 必须是 valid 路(除非 set 内全 invalid——但那不该触发替换);
- set 内存在 invalid 路时,victim 必须是 invalid 路之一;
- 被 lock 的路永不成为 victim;
- 连续 K 次对同一 set 的 refill,victim 不得重复选中同一路超过上限(LRU 语义下 K 次内每路最多被选一次)。
弱不变量的价值是「策略无关」——换 pLRU 还是 random,这批断言原样成立,是回归里的长青资产。精确断言则跟着策略走,策略改断言跟着改。断言的复位屏蔽细节(refill 期间复位、partial reset)按 sva-disable-iff-reset 的纪律处理,复位窗口没屏蔽是这类断言假失败的头号根因。
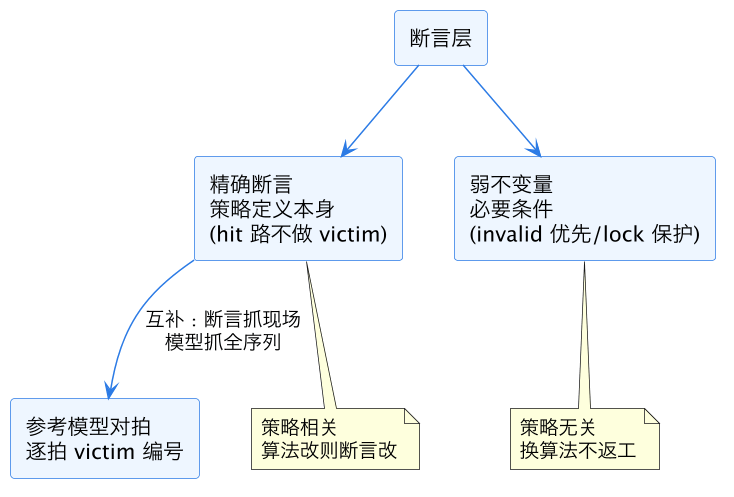
两条腿的关系如上:断言在 fail 瞬间冻结现场(配自动 dump 就是案发录像),模型对拍则保证整条访问序列的每一步决策都被检查过,覆盖断言没写到的策略细节。只靠断言容易漏「两个 bug 互相抵消」的场景;只靠模型则一个同步错位全盘假红。
四、覆盖率点设计:证明替换状态机真的走全了
替换逻辑的功能覆盖率要回答一个问题:「每个 set 的替换状态空间被遍历到什么程度」。直接对「年龄栈全排列」打 cover 在 4 路时就是 24 个 bin、8 路 40320 个,不可行也不必要。工程上的分解维度:
| 覆盖维度 | bin 设计 | 说明 |
|---|---|---|
| victim 路编号 | 每路一个 bin | 最基本,证明每路都被踢过 |
| 命中路 → 下一 victim 转移 | cross(hit_way, next_victim) | LRU 语义的核心转移图 |
| set 占用度 | 0/1/…/N-1 invalid 时 refill | invalid 优先路径是否走到 |
| refill 间隔 | 背靠背 / 短间隔 / 长间隔 | 年龄更新的时序角落 |
| 同 set 连续 refill 序列 | 长度为 N 的 victim 序列模式 | 一轮完整轮换是否发生 |
| lock 与 victim 组合 | lock 每路时的 victim 分布 | lock 保护被真实触发 |
其中第二行「命中路 → 下一 victim 转移」是 LRU 验证的灵魂:LRU 定义下,命中 way i 之后它成为最新,下一次 refill 的 victim 必不是 i——这个 cross 的非法 bin(illegal_bins)就是策略定义的直接表达。cross 的写法与非法 bin 处理见 covergroup-cross-illegal-bins 和 covergroup-coverpoint-bins。采样时机要小心:必须在 refill 决策生效后的同一拍采样 victim,在命中拍采样 hit_way,两个事件跨拍时用局部变量或 covergroup-sample-timing 里讲的事件触发采样对齐,采错一拍 bin 全歪。
random 策略的覆盖率退化为「victim 路分布的均匀性检验」:每路 bin 的命中计数在足够样本后应落在统计容差带内,这可以用 covergroup 的 option.at_least 配合脚本后检实现。
五、定向用例与随机激励的配合
激励侧的核心矛盾:替换只在「同 set 满员」时发生,而均匀随机地址把流量摊到所有 set 上,单个 set 被打满的概率随 set 数指数下降。对策是「索引聚焦」——约束随机地址的 index 字段集中到少数几个 set,tag 充分随机:
constraint c_focus {
  addr[13:6] inside {[8'h10:8'h13]};  // 只打 4 个 set
  addr[31:14] inside {[0:255]};        // tag 大开大合
}
定向用例则负责「确定性场景」,三条最经典:
- 轮换体检:对同一 set 依次灌 N+1 个不同 tag,验证第 N+1 个踢掉第 1 个(LRU 下第一笔最旧);再访问第 2 个 tag 使其刷新,灌第 N+2 个,验证踢掉第 3 个。这条用例能抓「年龄栈更新漏一拍」这类最高频实现 bug。
- 刷新保活:按固定顺序周期性访问 N-1 个 tag,中间穿插新 tag 灌入,验证被保活的 N-1 路永不成为 victim——抓「命中时年龄没更新」。
- invalid 边界:复位后只写 1 路就强制读 miss 触发 refill,验证选 invalid 路而不是踢掉唯一 valid 路;配合部分复位、invalidate 指令把 valid 位打回非满状态再触发替换。
随机侧用 sv-dist-weight-verification 的权重思想做「热度偏斜」:80% 流量打热点 set 组、20% 全地址空间游荡,既保证替换高频触发,又不丢掉跨 set 干扰(比如共享 refill buffer 时的相互影响)。场景层叠的思路与 sv-scenario-randomization-layers 一致:先地址分布层,再操作类型层(读写比例、invalidate 混入),最后异常层(替换中途复位、refill 被 backpressure 打断)。
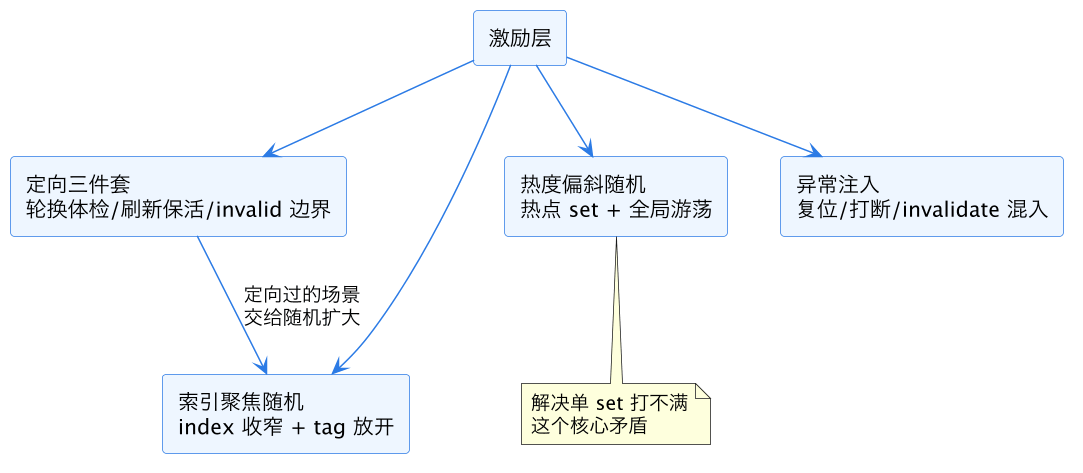
四层激励的推进顺序就是上图:定向先把策略定义的「教科书场景」钉死,索引聚焦随机把单 set 的状态空间刷厚,热度偏斜补上真实访问形态,异常注入专打状态机被中断的角落。覆盖率反馈驱动迭代——哪一格 cross 还空着,就回过头加对应偏斜的约束,这正是 coverage-driven-test-triage 的标准闭环。
六、常见 bug 模式:替换策略验证抓到的都是什么
最后给一份「猎物清单」,都是从真实项目回归里捞出来的高频 bug 模式,写断言和用例时对着这份清单自查,命中率会高很多。
| bug 模式 | 典型根因 | 哪条线抓到 |
|---|---|---|
| 命中不更新年龄 | 命中路径漏了年龄栈写使能,或更新被 stall 信号错误屏蔽 | 刷新保活定向用例、模型对拍 |
| refill 更新顺序错 | 年龄栈先更新后选 victim(或反之),新装填的路立刻成最旧 | 轮换体检用例 |
| invalid 优先失效 | valid 位更新与替换决策跨拍,决策时看到的是旧 valid | invalid 边界用例、弱不变量断言 |
| lock 位被旁路 | lock 检查只在部分路径(如命中 refill)做了,miss refill 路径漏掉 | lock 与 victim 组合覆盖 |
| pLRU 位数组更新错 | 只更新了根指针没更新子树指针,或方向拨反 | 精确断言、模型对拍 |
| 跨 set 串扰 | 年龄栈用一维数组实现,index 高位拼错导致写错 set 的状态 | 热度偏斜随机、多 set 并发用例 |
| random 源退化 | 随机数种子固定或 LFSR 未初始化,victim 永远是同一路 | victim 分布均匀性检验 |
这份清单也回答了「为什么三种检查手段缺一不可」:命中不更新年龄这种 bug,断言很难直接写(它是个「没发生的动作」),靠定向用例和模型对拍;跨 set 串扰则相反,定向用例想不到,只有多 set 交织的随机激励加逐拍对拍才钓得出来。把 bug 模式、检测手段、覆盖目标的映射登记进验证计划,走 testplan-coverage-mapping 的条目化管理,review 时一眼能看出哪类 bug 目前没有任何一条线兜底。
再补一条收尾建议:替换策略验证的用例往往是「跑得很快、状态很深」的类型,特别适合进短回归 nightly 跑。把定向三件套和几组不同聚焦参数的随机种子固定下来做成 smoke 套件,配合 regression-management-triage 的失败分诊流程,策略 RTL 的任何一次改动都能在当晚得到「victim 决策有没有变」的明确答案,而不是等一周后性能回归发现 miss 率涨了才回头刨。
这一篇在知识体系里的位置
本篇属于 chip-design/verification 目录下「verify-* 专项 DUT 验证」系列,与 verify-async-fifo-cdc、verify-round-robin-arbiter、verify-credit-flow-backpressure 同族——都是「一个具体微架构机制 × 一套完整验证链」。方法论地基来自 SV scoreboard predictor 模型 与 UVM scoreboard trace 对齐;断言侧承接 SVA 断言完整指南 和 sva-bind-assertion-module;覆盖率侧依赖 functional-coverage-complete-guide 与 testplan-coverage-mapping。替换策略引起的 miss 率劣化若要到性能层面定量评估,接 performance-verification。
总结
cache 替换策略验证的关键是绕开「数据对所以全对」的掩体:为 LRU/pseudo-LRU/random 各建一套精确或统计型参考模型逐拍对拍 victim,断言分「精确策略断言 + 策略无关弱不变量」两层常驻回归,覆盖率以「命中路到下一 victim 的转移 cross」为核心把替换状态机走全,激励用索引聚焦加热度偏斜解决单 set 打不满的核心矛盾——四线合一,换错一路这种沉默的劣化才会在硅前现形。