亚稳态 MTBF:FIFO 指针两级打拍的失效率量级与三级判据
专题导航:异步FIFO设计全景。前置要求:已读格雷码跨时钟域原理与满空语义与保守延迟,知道跨域指针走格雷码、满空标志在目的域用两级触发器采样。 上一篇:满空语义与保守延迟 | 下一篇:指针绕回与扩展位。 配套实验在工程包 derekzhuo/async-fifo-mini 的
tb/tb_metastability_mtbf.v,本文全部输出可一条命令复现。
本文要回答的问题
- 触发器进了亚稳态之后到底发生了什么,「分辨时间常数」描述的是哪段物理过程?
- MTBF 公式
MTBF=1/(fclk1·fclk2·T0·e^(−tr/τ))里每个因子从哪来,怎么用它做设计预算? - 格雷码已经保证每次只变一位,为什么打拍还是省不掉?
- 两级同步器的失效率比单级低多少,这笔账能不能算出数量级?
- FIFO 指针路径为什么两级就够,而有些使能、控制信号要上三级?
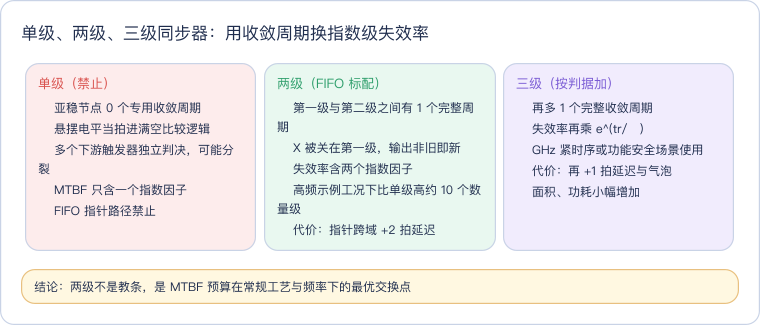
这张对照卡是全文的预算表:同步器每加一级,买进的是一整个周期的电平收敛时间,在指数上压低失效率;付出的是一级寄存器的延迟。FIFO 满空语义篇里那「三拍欠账」中的两拍,买的就是这张卡第二栏的可靠性。支柱页异步FIFO设计全景给出了打两拍的结构,本篇回答「为什么恰好是两级」。
一、亚稳态的物理图像:违例沿之后发生了什么
触发器能在时钟沿把 D 判决成 0 或 1,前提是 D 在沿前后一段窗口内保持稳定,这段窗口就是建立时间与保持时间。跨时钟域信号不做任何承诺——格雷码指针的一个 bit 完全可能在目的沿前 0.5ns 翻转,正好落进窗口。此时触发器内部两个反相器互相咬住的节点来不及翻到位,输出悬在接近阈值的中间电平,随后以指数方式爬向 0 或 1。爬向哪一端、爬多久都是概率性的。

读这张图抓住一条时间线:蓝色是触发事件,红色两步是亚稳态本身——违例窗决定「进不进」,指数衰减决定「出不出得来」;紫色的 tr 是设计真正能控制的量,橙色判决点是账到期的时刻。衰减规律写成 P(未收敛) ∝ e^(−tr/τ):留给电平收敛的时间每多一个时间常数 τ,仍未收敛的概率就再除以 e(约 2.72)。注意这里是指数关系,这是后面所有数量级差距的来源。
两个时间参数必须分清。τ(分辨时间常数)由工艺与触发器单元决定,典型几十到几百皮秒;违例窗 T0(也记作 t0,几到几十皮秒)随工艺缩小,二者都要以库单元的 MTBF 报告为准。tr 是留给收敛的实际预算:tr = Tclk − tco − 布线延迟 − tsu − 时钟偏斜裕量,频率越高、路径越长,tr 越短,指数上越吃亏——亚稳态问题因此在 GHz 设计里远比百兆设计尖锐。
二、MTBF 公式逐因子拆解:失效率这笔账怎么算
单个同步器的平均无故障时间用经典 MTBF 公式估算:
            1                    e^(tr/τ)
MTBF₁ = ───────────── = ─────────────────────────
f_clk·f_data·T0·e^(−tr/τ) f_clk·f_data·T0| 因子 | 含义 | 在 FIFO 指针路径上的取值口径 |
|---|---|---|
| f_clk | 目的时钟频率(采样沿速率) | 读/写目的域时钟,如 200MHz |
| f_data | 跨域输入的平均翻转率 | 指针单根 bit 的翻转率,远低于 f_clk;做最坏预算时可取源时钟频率 |
| T0 | 亚稳态孔径参数 | 工艺/单元相关,几十皮秒量级,查单元库 MTBF 报告 |
| τ | 分辨时间常数 | 同上,几十皮秒量级,随工艺角、电压、温度恶化 |
| tr | 可用分辨时间 | 周期减 tco、布线、建立时间与裕量;两级之间通常接近一整个周期 |
| e^(−tr/τ) | 一次违例后 tr 内仍未收敛的概率 | 真正的主导项:tr 是 τ 的 20 倍还是 200 倍,结论天差地别 |
两级同步器为什么是指数级改善:第二级出故障,需要「第一级违例且一个周期后仍未收敛」并且「第二级在又一个周期后仍未收敛」,两个独立的指数因子相乘,工程上常用级联近似:
MTBF₂ ≈ e^(2tr/τ) / (f_clk²·f_data·T0²)用两组教科书常见参数做设计取值示例(数字只用于建立量级直觉,真实项目必须代本工艺库的 MTBF 报告值,不能照抄):
| 预算项 | 工况 A:高频紧时序 | 工况 B:FIFO 常见中速 |
|---|---|---|
| 参数 | τ=30ps,T0=20ps,f_clk=1GHz,f_data=100MHz,tr=0.6ns(=20τ) | τ=20ps,T0=10ps,f_clk=200MHz,f_data=20MHz,tr=4ns(=200τ) |
| 单级失效率 λ1 | 4.1×10⁻³ /s | 5.5×10⁻⁸³ /s |
| 单级 MTBF1 | 约 240 秒(4 分钟) | 约 6×10⁷⁴ 年 |
| 两级失效率 λ2 | 1.7×10⁻¹³ /s | 1.5×10⁻¹⁷² /s |
| 两级 MTBF2 | 约 1.9×10⁵ 年(19 万年) | 约 2×10¹⁶⁴ 年 |
| 两级/单级倍数 | 约 2.4×10¹⁰(10 个数量级) | 更大,已无工程意义 |
注意这不是「单级每四分钟必坏」,而是一个同步器连续工作的期望时间;换成产品队列:100 万颗芯片、每颗 20 个跨域 bit、服役 10 年,总暴露时间约 6.3×10¹⁵ 同步器·秒。工况 A 下单级必然批量失效;两级的 λ2 乘上去仍可能出现上千起期望失效,所以高频、紧时序、车规功能安全的设计会上三级,把失效率再乘以 e^(tr/τ)(工况 A 下再降约 5×10⁸ 倍)。工况 B 才是绝大多数 FIFO 的真实处境:单根指针 bit 翻转率低、周期宽裕,两级之后的预算大到没有讨论意义——这就是「FIFO 指针两级足够」的量化含义,它不是信仰,是代入参数后的结论。
同一公式还顺手解释了两个工程纪律:两级触发器必须放得尽量近(ASIC 布局约束、FPGA 的 ASYNC_REG 属性),为的是别让布线延迟偷走 tr;两级之间不许插任何组合逻辑,插一个缓冲器就把一整个周期的收敛预算割掉一块。可综合的模板照抄两级触发器同步器 Verilog 模板。
三、注错仿真:X 在哪一级被拦住
行为级仿真器没有模拟分辨率,无法复现中间电平,但可用 4 态逻辑的 X 做数字注错:跨域 bit 刻意在目的沿前 0.5ns 翻转,第一级强制采到 X,X 在周期中途分辨为确定值;10 次注错中 9 次一个周期收敛、1 次两个周期。单级路径让 X 当拍扇出给组合逻辑(对应满空比较器),两级、三级分别多看一个完整周期。
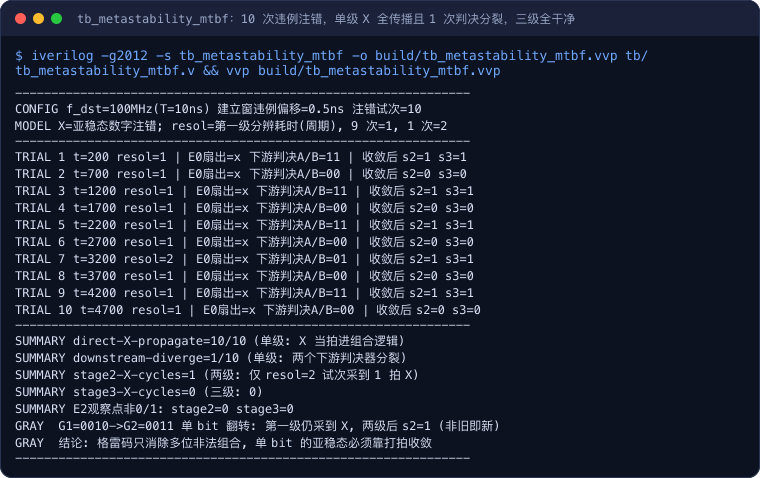
终端卡里三行统计分别对应三种失效模式。direct-X-propagate=10/10:只要只有一级,违例当拍 X 就进了组合逻辑,FIFO 场景下意味着满空比较结果当拍变成 X,满空标志整条链被污染。downstream-diverge=1/10:单级节点高扇出时,两个下游触发器在第 7 次注错(分辨耗时两拍)里对同一个悬摆电平独立判决,一个判 0 一个判 1——同一块芯片的两部分对「FIFO 满不满」得出相反结论,这是比 X 更危险的失效,因为 X 在下游还可能被复位逻辑拦住,分裂成干净的 0/1 后系统毫无察觉。两级路径只在同一次注错里采到一拍 X(stage2-X-cycles=1),且下一个周期自身分辨完毕;三级路径恒为 0,所有观察点稳定后非 0 即 1,没有出现过第三种值。
违例沿的波形把这个过程画出来:跨域输入在第一个目的沿前不久翻转,第一级输出立刻进入未知段,一个周期后分辨完成;第二级在沿 1 采到稳定的 1,第三级在沿 2 跟进。
读这张波形只看未知段的边界:X 被压缩在第一级的第一个周期里,没有越过第二级的采样沿。翻转提前沿 0.5ns 是注错模型里唯一的「模拟」成分,分辨耗时按试次给定而非电压驱动,所以本实验只证明结构性质;失效率数字一个都不来自仿真,全部来自第二节的公式代入。单同步器的入门实测见两级同步器 MTBF 实测,那篇讲怎么验证一个同步器,本篇立的是 FIFO 指针路径的可靠性预算。
四、为什么格雷码替代不了打拍
这是评审里最常混淆的一点。格雷码解决「多位同时翻转时采到谁也没发送过的组合」:011→100 偏斜窗口里可能采出 000、110,满空比较直接指向不存在的指针位置。格雷码把每次变化限制成一根 bit,目的域采到的便永远非旧即新,格雷码跨时钟域原理的采样实验实测二进制 8 次 4 非法、格雷码 8 次全合法。
但「只翻一根 bit」不等于「这根 bit 不违例」。违例是单根线与目的沿之间的时序关系,和编码方式毫无关系:格雷指针 0010→0011 只翻 bit0,bit0 照样可能在目的沿前 0.5ns 翻转,第一级照样进亚稳态。终端卡最后两行就是这件事的注错演示:单位翻转的格雷码 bit 第一级仍采到 X,两级之后才干净。
两者的分工因此是串联而不是二选一:
| 机制 | 防御对象 | 失效时的表现 | 缺了它会怎样 |
|---|---|---|---|
| 格雷码 | 多位翻转的偏斜窗口 | 采到非法指针值(如 000/110) | 满空比较指向不存在的状态,误差方向不可控 |
| 两级打拍 | 单 bit 的亚稳态 | X 传播或下游判决分裂 | 即使值合法,系统也可能对同一个电平判决不一致 |
| 保守方向 | 同步延迟本身 | 虚报满/空,产生气泡 | 见满空语义与保守延迟 |
一句话:格雷码保证「跨过去的每一根线都是独立的」,打拍保证「每一根独立的线都能安全跨过去」。多 bit 为什么不能各位分别打拍了事,见多位信号为什么不能直接打拍——那正是格雷码存在的理由的另一半。
五、设计判据:FIFO 指针为什么两级足够,什么时候要三级
回到 FIFO 指针路径做预算。深度 16 的工程里,跨域的是两个方向各 ADDR_WIDTH+1 位格雷指针,单根 bit 的翻转率随位权指数下降(最高位一个绕回周期才翻一次),远低于工况 B 所取的 20MHz;目的时钟在一二百兆、tr 是 τ 的上百倍时,两级 MTBF 超出设备寿命几十个数量级。再加级买到的可靠性没有物理对象能消费,代价却是实的:满空撤销滞后每加一级多一拍,满空语义与保守延迟实测的三拍欠账变四拍,气泡税线性增加,almost 阈值也要重算。两级因此是常规 FIFO 的最优点,不是保守值。
三级(或更多)只在预算算不过来时加,典型触发条件有四类:
- 频率高到
tr/τ小于约 20:千兆赫、紧时序工况,第二节工况 A 显示产品队列尺度下两级仍可能有可观测失效率; - 单元库 MTBF 报告在目标工艺角(高温、低压、慢片)明确不达标:注意必须按最坏角算,常温典型值没有意义;
- 功能安全要求:车规、工业锁步系统把同步器失效列入安全目标,要求定量失效率低于 ASIL 等级阈值;
- 物理上无法保证两级紧邻:跨 die、跨电压域或布线拥塞迫使两级之间有显著延迟,
tr被偷走,等效于工况恶化。
另一个常被当成「更可靠」的备选是握手(toggle-ack)。连续变化的指针不适合握手——每次跨域往返四个沿,带宽崩塌;但稀疏的使能、模式切换、中断类信号,握手用「请求翻转—两级同步—应答翻转—两级同步」换取零丢事件,亚稳态收敛天然包含在往返周期里,代价是延迟与翻转功耗。选型判据是事件稀疏度和「丢一个会不会死」:指针走格雷码加两级,控制面选握手或三级。冗余翻转(双链表决)面积翻倍而收益不单调,主流设计极少使用。
顺带一笔同类问题:异步复位的释放和跨域采样共享同一个物理根源。复位撤除沿若不服从任何时钟的恢复时间,所有触发器会像看到违例沿一样各自判决,同一片设计一部分离开复位、一部分还在复位,状态机从非法态启动。标准打法是复位可异步断言、同步撤防(reset synchronizer),每个时钟域本地同步释放,细节见时钟与复位概念,FIFO 工程包里的 tb_reset_skew.v 也演示了复位偏斜。
代码获取:实验平台在独立仓库 derekzhuo/async-fifo-mini 的 tb 目录,克隆后执行 iverilog -g2012 -s tb_metastability_mtbf -o build/x.vvp tb/tb_metastability_mtbf.v && vvp build/x.vvp 即可复现本文全部输出;该 testbench 自包含、不依赖 RTL 目录,本机需安装 Icarus Verilog。
实验环境
- 机器/系统:Mac(Intel)/ macOS,本机原生执行(未使用容器)
- 工具版本:Icarus Verilog 13.0(stable)
- 日期:2026-11-03
- 完整命令:
iverilog -g2012 -s tb_metastability_mtbf -o build/tb_metastability_mtbf.vvp tb/tb_metastability_mtbf.v && vvp build/tb_metastability_mtbf.vvp - 原始记录:本文终端卡内嵌的 23 行输出即完整原始记录;MTBF 数字为教科书工艺参数代入公式的设计取值示例,非仿真产物,实验源码见上述工程包
这一篇在知识体系里的位置
本篇是异步FIFO 专题原理段第三篇:格雷码跨时钟域原理解决「值合不合法」,满空语义与保守延迟解决「误差往哪偏」,本篇解决「为什么打拍、打几级」,三者合起来才是跨域指针设计的完整论证。单同步器的模板与实测见两级触发器同步器 Verilog 模板与两级同步器 MTBF 实测,一般 CDC 分类见跨时钟域 CDC 基础。下一篇指针绕回与扩展位回答满空时指针都相等,额外一位如何分开两种状态。
总结
亚稳态是跨域 bit 落进建立保持窗后触发器输出的指数衰减过程,失效率由 MTBF 公式主导,每多给一个 τ 就再改善一个 e:教科书参数下高频紧时序工况单级 MTBF 约 4 分钟、两级约 19 万年,相差 10 个数量级,而 FIFO 常见的中速低翻转率工况两级预算大到无意义。格雷码只消除多位非法组合、不豁免单 bit 亚稳态,与打拍串联;注错仿真 10 次违例中单级 X 全部当拍进组合逻辑且出现一次下游 0/1 判决分裂,两级仅一拍 X、三级恒干净。设计判据是按工艺库参数做产品队列尺度的预算:指针两级最优,三级留给高频紧时序、最坏角不达标、功能安全、物理远离四类场景,稀疏控制信号优先握手。