XDC 时序约束实测:同一份 RTL 在 100MHz 与 500MHz 约束下的实现对照
更新时间:2026-10-27。本文是「FPGA 进阶层(intermediate)」的一篇实验文。入门篇 XDC 约束入门:从引脚到时钟 讲清了 XDC 是什么、基本语法长什么样;STA 静态时序分析 讲了建立/保持时间的检查原理;进阶篇 XDC 时序约束命令大全 则覆盖 generated clock、IO delay、clock_groups 这些复杂命令。本篇填中间那块实证空白:先不碰复杂命令,只看
create_clock一行——把同一份 RTL 分别按 100MHz 和 500MHz 约束各跑一趟完整实现,直观看约束周期如何决定 WNS/TNS,以及「约束写多紧合适」的工程判据。
本文要回答的问题
create_clock的周期值对布局布线器意味着什么——是「建议」还是「基准」?- 同一份 RTL,约束从 10ns 收紧到 2ns,WNS/TNS 会怎样变化?
- XDC 常用命令(create_clock / set_input_delay / set_output_delay / set_false_path / set_multicycle_path)的最小可用写法是什么?
- 工程上「约束写多紧」的判断标准是什么?过紧和过松各自有什么代价?
先给结论卡,四个数字全部来自后文两趟 Vivado 2017.4 真实实现的时序报告:
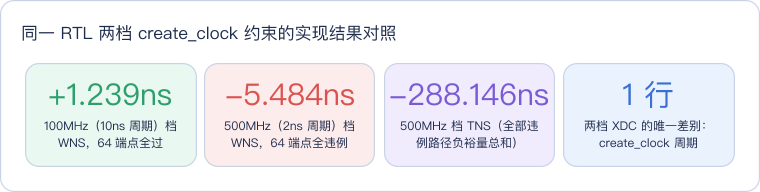
读这张卡抓一个反差:两份约束文件只有 create_clock 的周期不同(10.000ns 对 2.000ns),其余完全一样;同一份 Verilog、同一颗器件(xc7a35tcsg324-1)、同一套工具流程,结果一个余出 1.24ns 裕量轻松收敛,另一个差 5.48ns、64 个时序端点无一幸免。这组对照就是本篇要讲的全部道理:约束不是写给工具的建议,是时序收敛的唯一基准——布线器的一切努力都朝着满足你写的周期值,写多紧它就往多紧推,推不动就留下满篇红色违例。
一、实验设计:一份 RTL、两档约束、其余全相同
为了让「约束周期」成为唯一变量,实验刻意把其他所有条件钉死:
- DUT(被测设计):
wide_lut_chain——64 位输入先寄存一拍,经过 2 轮 rotate-xor-add 纯组合混合(综合后落在 LUT 加法器进位链上,实测关键路径约 8.7ns),再寄存输出。单时钟,无 IO 约束以外的任何时序例外。 - 两档约束:loose.xdc 写
create_clock -period 10.000(100MHz),tight.xdc 写create_clock -period 2.000(500MHz),除此之外逐字节相同。 - 流程:Vivado 2017.4 非工程模式批量跑
read_verilog → read_xdc → synth_design → opt/place/route → report_timing_summary → write_checkpoint,两趟完全同一个 Tcl 脚本,只是入参不同。
两档约束到底长什么样,直接对照看:
| 档位 | create_clock 行 | 目标频率 | 寄存器间预算 |
|---|---|---|---|
| loose | create_clock -name clk100 -period 10.000 [get_ports clk] | 100MHz | 10ns(路径实测约 8.7ns,余 1.3ns 量级) |
| tight | create_clock -name clk500 -period 2.000 [get_ports clk] | 500MHz | 2ns(同样 8.7ns 的路径,差 6.7ns 起步) |
这张表就是全文的「唯一变量声明」:之后看到的一切结果差异,只能归因于周期值从 10ns 变成 2ns——路径本身一个 LUT 都没变。为什么选这个 DUT?因为它的关键路径长度(约 8.7ns)刚好卡在 10ns 能过、2ns 必挂的中间地带,是一个天然的「约束灵敏度试纸」:同样的代码换一颗更快的器件、或者把组合级数砍掉一半,结论数字会变,但「约束周期决定收敛结果」的机制不变。
流程上选非工程模式(vivado -mode batch -source run_pass.tcl)而不是 GUI 工程,也是刻意的:批量模式下综合、布局、布线每一步的命令和选项都白纸黑字写在 Tcl 里,两趟跑的是逐字符相同的脚本,不存在「GUI 里某次多勾了一个优化选项」这种暗箱变量。做对照实验时这是基本要求——变量唯一、流程可复现,结论才站得住。日常开发用 GUI 工程没问题,但验证「约束对结果的影响」这类因果命题时,建议都把流程固化成脚本再跑。
先把三个贯穿全文的指标定义清楚,后面读报告才不费劲。**WNS(Worst Negative Slack,最差负裕量)**是所有时序端点里最小的那个建立时间裕量:正值表示最差的路径都还富余多少,负值表示最差的路径差多少没赶上。**TNS(Total Negative Slack,总负裕量)**是所有违例端点负裕量的总和,衡量违例的「面积」——WNS 告诉你最深的坑有多深,TNS 告诉你一共有多少坑。**WHS(Worst Hold Slack)**是保持时间的最差裕量,检查的是「数据别变得太快」,和周期长短基本无关。这三行数字是每个 report_timing_summary 报告的头部,看懂它们就看懂了 Vivado 时序报告的八成。
二、两趟实现实录:WNS 从 +1.239 到 -5.484
两趟实现用同一个 run.bat 驱动,Vivado 各跑一遍完整流程,最后都打出 PASS_DONE(表示流程本身跑完,时序是否收敛看报告)。全程实录节选如下:
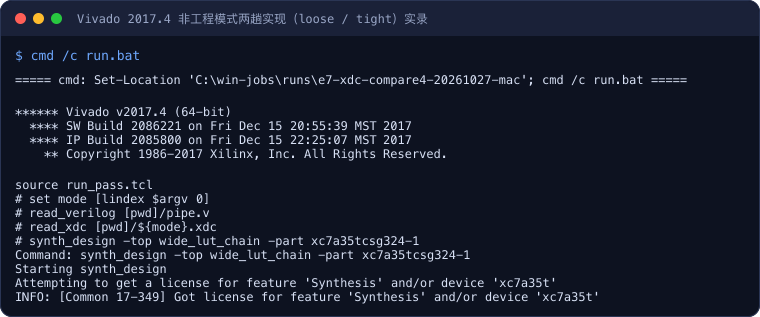
读这份实录抓两头:第 1 行是驱动命令本身——run.bat 里对 loose 和 tight 各调一次 Vivado 批量模式;后面是工具启动横幅和 source run_pass.tcl 的回显,确认两趟走的是同一份脚本。流程上没有任何「手调参数」的空间,变量仍然只有 XDC 那一行。
布线阶段的日志更能看到布线器「推约束」的过程。tight 档中间轮次的时序摘要原样摘录一段:
INFO: [Route 35-416] Intermediate Timing Summary | WNS=-5.524 | TNS=-290.768| WHS=0.026  | THS=0.000  |
INFO: [Route 35-416] Intermediate Timing Summary | WNS=-5.580 | TNS=-294.479| WHS=N/A    | THS=N/A    |
INFO: [Route 35-416] Intermediate Timing Summary | WNS=-5.580 | TNS=-294.479| WHS=N/A    | THS=N/A    |
INFO: [Route 35-416] Intermediate Timing Summary | WNS=-5.501 | TNS=-289.408| WHS=N/A    | THS=N/A    |
INFO: [Route 35-416] Intermediate Timing Summary | WNS=-5.486 | TNS=-288.326| WHS=0.416  | THS=0.000  |
读这段摘录抓一个「收敛不动了」的形状:布线器一轮一轮优化,WNS 从 -5.524 慢慢磨到 -5.486,每轮只改善零点零几个纳秒,最后停在 -5.486 再也推不动——这不是工具不努力,而是路径物理延迟约 8.7ns、预算只有 2ns,再聪明的布线也变不出 6.7ns。对照 loose 档同阶段的日志,WNS 从 1.340 一路优化到 1.233 稳定为正,布线器早早收工。同一个算法、同一份网表,差别只在目标值:一个是踮踮脚够得着的目标,一个是物理上够不着的目标。
两趟最终的 report_timing_summary 报告把结果钉死:
| 指标 | loose(10ns / 100MHz) | tight(2ns / 500MHz) |
|---|---|---|
| WNS(最差负裕量) | +1.239ns | -5.484ns |
| TNS(总负裕量) | 0.000ns | -288.146ns |
| 违例端点数 | 0 / 64 | 64 / 64 全红 |
| WHS(保持时间裕量) | +0.228ns | +0.416ns(保持反而过) |
| Pulse Width 检查 | 通过 | WPWS -0.155ns 违例 |
这张表值得逐项看。TNS -288.146ns 是 64 条违例路径负裕量的总和,说明违例不是一两条边角的意外,而是全部寄存器间路径系统性超标。更有意思的是最后一行:tight 档连脉冲宽度检查(Pulse Width)都挂了——2ns 周期对应的高低电平各 1ns,已经逼近这颗 Artix-7 器件触发器时钟脉宽本身的物理下限,就算组合逻辑能魔术般变快,时钟波形本身也不合法。而 WHS 一栏 tight 档反而更好,是因为保持时间检查与周期长短几乎无关,布线器还顺手做了些保持修复——这个细节正好说明「约束收紧只影响建立时间这一头」。
三、约束是怎么「指挥」布线器的
到这里可以把机制画清楚了。XDC 约束在实现流程里的位置,以及它如何决定结果走向:
读这张图抓颜色分工:蓝色是宽松的输入约束、红色是收紧后不可达的输入约束,橙色是实现引擎,绿色和红色分别是两种结局。核心机制一句话:布局布线器是一个「目标驱动」的优化器,create_clock 的周期值就是它的优化目标。周期给 10ns,它把关键路径推到 8.76ns 就满意收工(loose 档 WNS 正是 10 - 8.761 = 1.239);周期给 2ns,它把所有已知手段(逻辑复制、布局靠拢、布线走捷径)全用上,最后也只能停在 7.48ns 左右,剩下 5.48ns 的差距如实写进报告。工具不会替你质疑「2ns 是不是写错了」——它默认你写的约束就是设计真实要跑的速度。
打开 tight 档布线完成后的 checkpoint,Device 视图里可以看到已布局的逻辑单元,底部 Timing 页签带着红色违例角标:
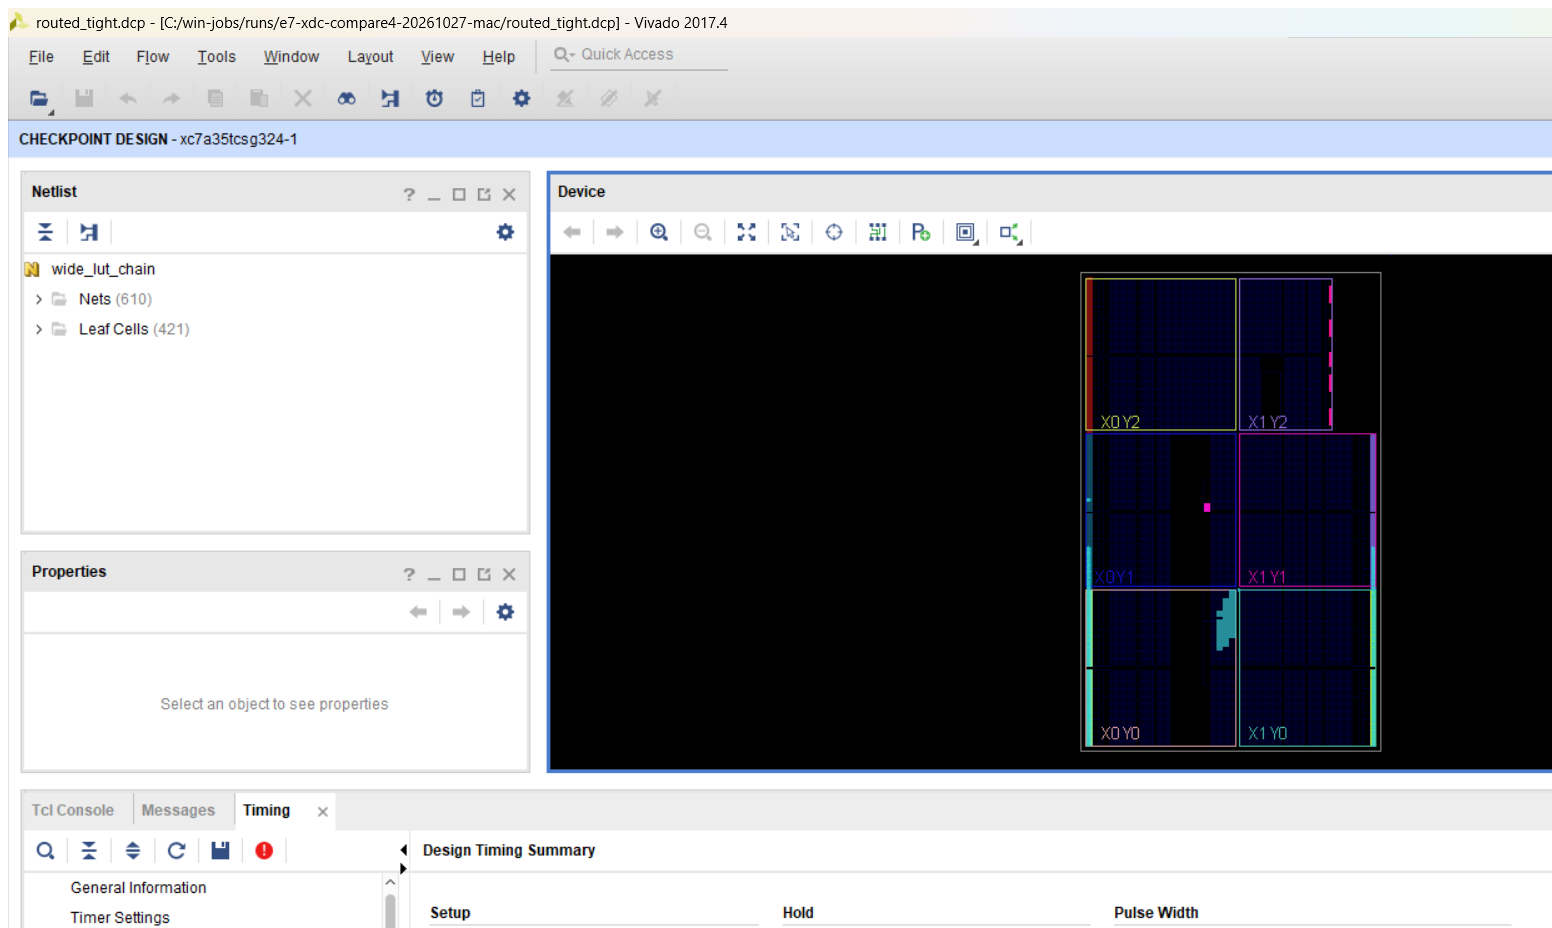
读这张图注意两处:标题栏 routed_tight.dcp 确认这是 500MHz 档布线完成的检查点;底部 Timing 页签上的红色角标是 Vivado 对「存在时序违例」的固定提示——工程实践中看到这个角标,就不能把比特流往板上烧了。这 64 条红色路径在 GUI 里可以逐条点开看延迟分解(逻辑延迟 vs 布线延迟各占多少),那是 时序收敛方法论 一篇展开的内容,本篇只要建立直觉:红色角标的根因往往不在布线器,而在约束与 RTL 的匹配度。
四、XDC 常用命令最小可用模板
create_clock 吃透之后,实际工程里一个外设齐全的 XDC 至少还要写四类命令。下面这张表给出每条的最小可用写法(可直接抄进自己的工程再改参数),更深的语法(generated clock、clock_groups 等)交给 XDC 时序约束命令大全:
| 命令 | 最小可用写法 | 什么时候必须写 |
|---|---|---|
| 主时钟 | create_clock -name sys_clk -period 10.000 [get_ports clk] | 每个外部时钟输入引脚,一条都不能漏 |
| 输入延迟 | set_input_delay -clock sys_clk -max 2.0 [get_ports {din[*]}] | 上游器件数据/控制信号进 FPGA 的引脚 |
| 输出延迟 | set_output_delay -clock sys_clk -max 1.5 [get_ports {dout[*]}] | FPGA 送往下游器件的引脚 |
| 伪路径 | set_false_path -from [get_ports rst_n] | 异步复位、跨时钟域已做同步器的路径 |
| 多周期路径 | set_multicycle_path 2 -setup -from [get_cells slow_reg*] | 两拍才用一次的慢速逻辑(极少用,慎用) |
三条使用纪律比语法本身更重要。第一,时钟引脚漏写 create_clock 是最常见也最隐蔽的错误——Vivado 对没有时钟约束的寄存器间路径默认不检查,报告里干干净净,上板后故障随机出现;写完 XDC 后跑一句 check_timing,它会列出所有未被约束的时钟端点,这个习惯能挡掉一大半「仿真好好的、上板就抽风」的怪问题。第二,set_input_delay / set_output_delay 的数值必须来自上游/下游器件数据手册的建立保持参数加板级走线延迟,拍脑袋填 0 等于没约束,引脚时序的完整写法见 XDC 引脚与时序约束实战。第三,set_false_path 和 set_multicycle_path 是「时序例外」命令,本质是告诉工具「这条路你别管」——写之前必须能用一句话说清为什么这条路不需要检查(异步信号已同步、数据两拍才消费),说不清就不许写,例外命令是收敛报告变漂亮的捷径,也是放真实违例过关的后门。
五、约束写多紧合适:过紧与过松的代价
本次实验的 tight 档演示了「过紧」的极端,工程实践中两头的代价都要算清楚:
- 过松(约束周期大于实际需求):布线器提前收工,报告一片绿,但设计上板跑在真实频率时时序违例——故障表现为偶发数据错误、温度一高就死机,极难排查。这是「报告好看、板子翻车」。
- 过紧(约束周期小于物理可达):布线器陷入无止境的优化循环,实现时间从几分钟拉长到几小时,最后仍然满篇违例;更隐蔽的代价是「狼来了」效应——报告常年红色,真正新增的违例混在里面没人看。本篇 tight 档就是活例:-5.484ns 的窟窿物理上不可能补上,任何后续修改的真实影响都被这个常数噪音淹没。
- 合适的写法:按设计真实运行频率写周期,再留 10%-20% 余量(比如要跑 100MHz 就约束 110-120MHz,即 period 写 8.3-9.1ns)。余量的意义是给温度、电压波动和器件个体差异留缓冲,同时让布线器保留「再推一把」的优化空间。对本篇的 DUT,合理约束大约是 9.0-9.5ns——8.7ns 的路径留一点裕量,一次实现几分钟内收敛。
一句话概括这个判据:约束周期 = 真实频率换算值 × (1 - 10~20% 余量),既不是愿望也不是上限。想跑更快不是靠把约束写小逼工具,而是回去改 RTL——把本篇 DUT 的 2 轮组合混合拆成流水、每轮寄一拍,8.7ns 的路径自然变成两段 4.4ns,那时 200MHz 以上的约束才不再是「物理上够不着的目标」。
还有一个从本次数据里能直接读出的实用结论:布局后预估和布线后终值之间的差距,本身也是约束松紧的晴雨表。loose 档布局后 WNS 是 1.389ns,布线终值 1.239ns,布线只「损耗」了 0.15ns;tight 档布局后已经是 -5.490ns,布线终值 -5.484ns,布线器拼尽全力只捞回 0.006ns。宽松约束下布局布线几乎一次到位,收紧约束下每一轮优化都在和物理极限硬碰硬。看实现日志时如果发现布线轮次多、每轮改善微乎其微而 WNS 仍为负,先别怀疑工具——先回头核对约束周期是不是写得太狠,以及关键路径是不是该回 RTL 层动刀。
实验环境
- 机器/系统:i5-13500H 笔记本 / Windows 11
- 工具版本:Xilinx Vivado v2017.4(64-bit,SW Build 2086221),目标器件 xc7a35tcsg324-1
- 日期:2026-10-27
- 完整命令:
cmd /c run.bat(内部对 loose / tight 两档各执行一次vivado -mode batch -source run_pass.tcl,脚本流程为read_verilog pipe.v → read_xdc <mode>.xdc → synth_design → opt_design → place_design → route_design → report_timing_summary -file timing_<mode>.rpt → write_checkpoint routed_<mode>.dcp) - 原始记录:完整控制台实录与两份时序报告随实验代码一并收录于公开仓库对应目录
代码获取
完整 RTL、两档 XDC 约束与运行脚本已同步到公开仓库:geek-doc.cn/experiments/vivado-xdc-timing-compare,目录内含 pipe.v、loose.xdc、tight.xdc、run_pass.tcl 与 run.bat;装有 Vivado 2017.4 的机器上执行 cmd /c run.bat 即可复现本文两趟实现,时序报告生成在 timing_loose.rpt / timing_tight.rpt。
这一篇在知识体系里的位置
- 入门前置:XDC 约束入门:从引脚到时钟(XDC 是什么、基本语法)、XDC 引脚与时序约束实战(IO 约束完整写法);
- 原理承接:STA 静态时序分析(WNS/TNS 背后的建立/保持检查原理);
- 进阶深化:XDC 时序约束命令大全(generated clock、clock_groups、IO delay 完整命令集)、时序收敛方法论(违例路径逐条分析与修复套路);
- 本篇的独特位置:用同一 RTL 两档约束的对照实验,把「约束周期决定时序收敛」从一句话变成 +1.239ns 与 -5.484ns 两个真实数字,是进入命令大全之前必须先建立的直觉。
一句话总结
XDC 时序约束是 FPGA 时序收敛的唯一基准:同一份 RTL 在 Vivado 2017.4 下,create_clock 写 10ns 时 64 个端点全过、WNS +1.239ns,写 2ns 时 64 个端点全红、WNS -5.484ns 且连时钟脉宽都违例——布线器是目标驱动的优化器,约束写多紧它就往多紧推,推不动就如实报告;工程上的正确写法是按真实频率留 10%-20% 余量,过松报告好看板子翻车,过紧实现时间爆炸且违例噪音淹没一切。