SystemVerilog 队列与关联数组方法:排序查找、聚合统计与存储器选型
更新时间:2026-09-28。本篇是验证地基的容器篇:如果你已经读过 SystemVerilog 打包与非打包数组,知道定宽数组和动态数组怎么声明,下一步绕不开的两个问题就是——长度不停变化的 FIFO 缓冲用什么存?稀疏地址空间的数据用什么查?答案就是队列(queue)与关联数组(associative array)。它们是 SystemVerilog 记分板用队列实现 和 存储器模型 的底层积木。
本文要回答的问题
- 队列怎么声明、怎么入队出队、中间还能不能插入删除?
- 定位符
$和队列切片到底怎么用,为什么会越界报错? - 关联数组的索引可以是什么类型?怎么遍历、怎么判断键是否存在?
sort/rsort/shuffle/find/max/sum这些内建数组方法在验证里解决什么实际问题?- 队列、动态数组、关联数组三种容器分别适合什么场景,怎么选?
一、队列:会自己伸缩的 FIFO
队列声明用 [$],元素类型在前,不需要 new、不需要指定大小,它会随插入自动增长:
int q[$];              // 空队列
bit [7:0] byte_q[$];   // 字节队列,常用于报文缓冲
transaction exp_q[$];  // 类句柄队列,记分板期望队列
最常用的四个操作是两对入队/出队:
q.push_back(10);       // 尾部插入
q.push_front(5);       // 头部插入
int a = q.pop_front(); // 头部弹出 → 5
int b = q.pop_back();  // 尾部弹出 → 10
push_back + pop_front 组合就是标准 FIFO——monitor 抓到一笔事务 push 进期望队列,scoreboard 在收到 DUT 输出时 pop 出来比对,顺序天然对齐。push_front 则用来实现"紧急插队",比如 error injection 场景里把一笔高优先级事务塞到最前面。
队列还能在中间操作,这是它和纯 FIFO 的区别:
q = {1, 2, 3, 4, 5};
q.insert(2, 99);   // 索引 2 处插入 → {1,2,99,3,4,5}
q.delete(0);       // 删除索引 0 → {2,99,3,4,5}
q.delete();        // 无参数 = 清空整个队列
int n = q.size();  // 当前元素个数
二、定位符 $ 与队列切片
$ 代表队列最后一个元素的索引,类似 Python 的 -1(但语义是"末尾"不是"倒数")。q[$] 是队尾元素,q[$-1] 是倒数第二个。
切片(slice)一次取一段,常用于抓头抓尾做比对:
int q[$] = {10, 20, 30, 40, 50};
int head[$] = q[0:2];     // {10,20,30} 前三个
int tail[$] = q[$-1:$];   // {40,50} 后两个
q = q[1:$];               // 丢掉队首,等价于 pop_front 但不返回值
两个高频坑:
- 切片区间超界(比如队列只有 3 个元素却写
q[0:5])是运行时错误,仿真器会直接报 out-of-bounds,不像定宽数组那样静默读 X。 q[$]用在空队列上同样是越界。任何 pop 或切片前养成习惯:if (q.size() > 0)或while (q.size() != 0)先判断。
下图把队列的核心操作画成一条流水线——头部出、尾部进是主路径,insert/delete 是旁路:
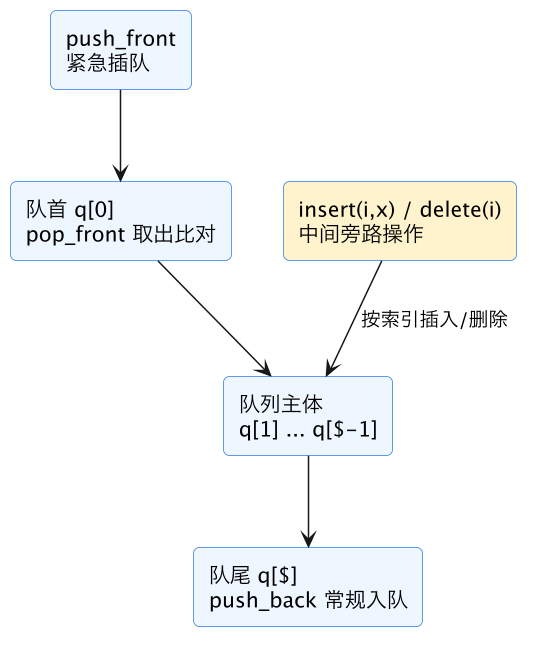
图中蓝色主体是数据流向:正常事务从队尾进、从队首出,构成 FIFO;黄色卡片标注的是旁路能力——队列允许按索引在中间动手脚,这是它比 mailbox 灵活的地方(mailbox 只能阻塞收发,见 SystemVerilog 事件旗语信箱),但也意味着误用 delete(i) 会打乱比对顺序。
三、关联数组:稀疏存储的哈希表
关联数组用"键"索引,键可以不是连续整数,内存只为实际出现的键分配。声明语法是 [索引类型]:
int mem [bit [31:0]];      // 以 32 位地址为键的稀疏存储器
int cnt [string];          // 以字符串为键的计数器
longint unsigned hist [int unsigned];第二条在覆盖率统计里很常见:按错误类型字符串计数,cnt["CRC_ERR"]++ 一行搞定,不用先映射到枚举编号。
关联数组的看家方法是遍历与存在性判断:
mem[32'h1000] = 8'hAA;
mem[32'h8000] = 8'h55;

if (mem.exists(32'h1000))
  $display("hit: %h", mem[32'h1000]);

// 遍历:first/last 定位边界,next/prev 迭代
bit [31:0] addr;
if (mem.first(addr)) begin
  do begin
    $display("addr=%h data=%h", addr, mem[addr]);
  end while (mem.next(addr));
end
exists 必须显式调用——直接读一个不存在的键不会报错,而是返回该类型的默认值(int 返回 0),这是关联数组最阴的坑:scoreboard 里一次"期望 0、实际也是 0"的假对,可能掩盖地址映射写错的事实。其它常用方法:
| 方法 | 作用 | 典型场景 |
|---|---|---|
exists(k) | 键是否存在 | 比对前确认地址已写 |
first(k)/last(k) | 取最小/最大键,返回是否非空 | 遍历起点、地址范围检查 |
next(k)/prev(k) | 迭代到相邻键 | 顺序打印全表 |
delete(k) | 删指定键;无参清空 | 测试结束清场 |
num() | 键的个数 | 统计稀疏表占用 |
注意关联数组的 num() 不叫 size(),和队列不一样,混着写编译就报错。
遍历也可以用 foreach:对关联数组 foreach (mem[addr]) 会按索引类型排序后的顺序逐个走,比 first/next 写法短,适合一次性打印或转存。要注意关联数组的遍历顺序在 LRM 里规定为索引类型升序(整数键按数值、字符串键按字典序),不要假设是插入顺序——如果业务上需要"先写先处理",那应该改用队列,或者队列记顺序、关联数组记数据,两个容器配合使用。这种"队列管时序、哈希管查找"的组合在乱序总线 scoreboard 里几乎是标准结构。
关联数组的索引还能是多维的:int page [bit[31:0]] [int],第一层地址、第二层 bank 号。不过多维之后 first/next 只作用于第一维,可读性下降,实际工程里更常见的做法是把复合键拼成一个拼接键(如 {bank, addr})做单维索引,遍历逻辑简单得多。
四、内建数组方法:排序、查找、聚合
队列、动态数组、定宽数组都共享一组内建方法(关联数组因为键无序,不支持排序类)。它们分三类,下面这张图先给全景:
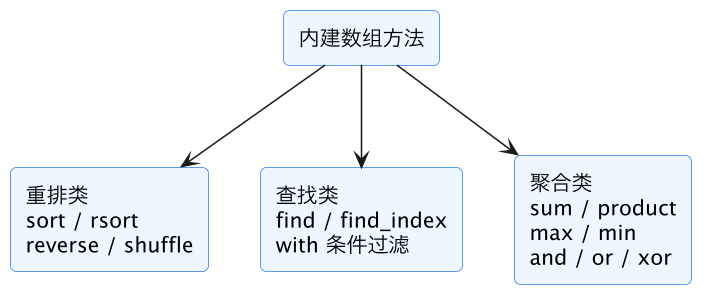
三类方法的分工:重排类改变元素顺序本身(返回新数组),查找类按 with 条件过滤出子集,聚合类把整个数组压成一个标量。验证里最高频的几个用法:
int q[$] = {7, 3, 9, 1, 5};

// 排序与乱序
q.sort();      // {1,3,5,7,9} 升序
q.rsort();     // {9,7,5,3,1} 降序
q.reverse();   // 反转当前顺序
q.shuffle();   // 随机打乱 —— 造随机激励顺序的利器

// 查找:找出所有大于 4 的元素
int big[$] = q.find(x) with (x > 4);        // {5,7,9}
int idx[$] = q.find_index(x) with (x == 9); // 命中的索引

// 聚合:一行算出统计量
int total = q.sum();                 // 求和
int peak  = q.max() with ($);        // 或直接 q.max 找最大
bit all_one = q.and() with ($);      // 全体按位与
with 子句里的 x 是迭代变量名(自取),$ 代表当前元素本身。三个验证实战例子:
- 随机执行顺序:回归时把待跑用例编号放进队列
tc_q.shuffle(),每次种子不同执行顺序就不同,能暴露用例间的隐性依赖(前一个用例没清干净状态)。 - 延迟统计:性能验证把每笔事务延迟 push 进队列,跑完
lat_q.sum() / lat_q.size()得平均延迟,lat_q.max()得最大延迟,不用写循环。 - 乱序响应重排:AXI 这类允许乱序返回的总线,scoreboard 用
find_index(x) with (x.id == rsp.id)按 ID 把响应从期望队列里捞出来删,等价于一次带条件的定点删除。
下图用一条"激励→统计"的数据流串起这些方法在记分板里的位置:
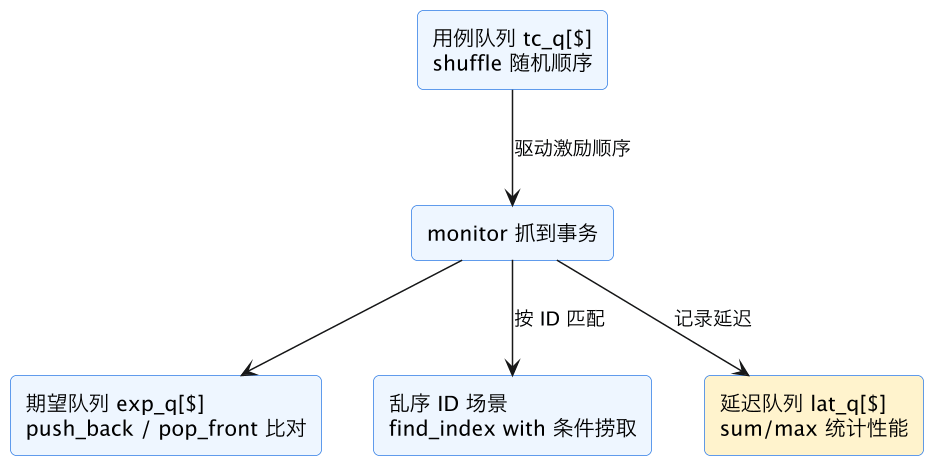
蓝色部分是一次比对的三种容器用法:有序场景走期望队列的 FIFO 比对,乱序场景用 find_index with 按 ID 捞取,黄色卡片是旁路的性能统计队列——数据只进不出地攒着,跑完一次性聚合。左下角的用例队列则展示了 shuffle 在激励侧的角色。
五、三种动态容器怎么选
队列、动态数组、关联数组经常被混用,但它们的开销模型和 API 完全不同。动态数组(int arr[],需 new[N] 定长)本篇没展开,细节见 randc 与动态数组随机化。三者对照如下:
| 维度 | 队列 q[$] | 动态数组 arr[] | 关联数组 aa[key] |
|---|---|---|---|
| 大小 | 自动伸缩 | new 后固定,可再 new | 按键自动分配 |
| 索引 | 0..$-1 连续 | 0..N-1 连续 | 任意类型、稀疏 |
| 头尾增删 | O(1),内建方法 | 不支持,需重建 | 无头尾概念 |
| 随机访问 | 支持但慢(链表实现) | 快(连续内存) | 哈希查找 |
| 内存占用 | 每个元素额外指针开销 | 最省 | 最大(哈希表) |
| 典型用途 | FIFO 缓冲、记分板期望队列 | 大块规则数据、波形缓存 | 稀疏存储器、按名查表 |
一句话选型口诀:进进出出用队列,定长快取用动态数组,稀疏按键查用关联数组。记分板期望队列几乎一律用 transaction q[$];建模 4GB 地址空间但只被碰几百个地址的场景,动态数组根本开不出来,必须关联数组——这也是 存储器模型的 backdoor 比对 的标准做法。
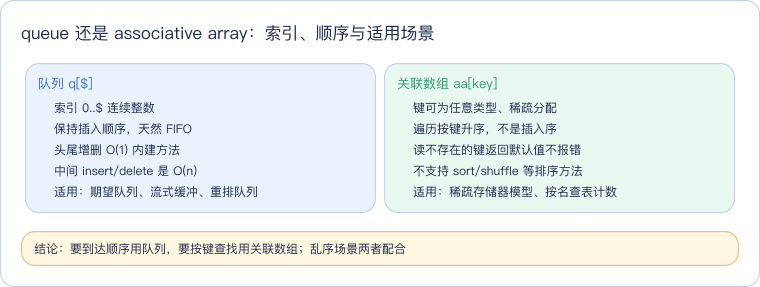
上表把三种容器摆在一起信息量大,日常真正纠结的其实是队列和关联数组二选一,把这两栏单独抽出来对比更聚焦:核心分歧就两条——索引是不是连续整数、顺序是不是插入序。两条都要(既要按键捞取又要保持到达顺序)时,就是前文说的「队列记顺序、关联数组记数据」组合结构。
性能上还有一个容易忽视的点:在百万级元素的大队列上频繁 insert/delete(i) 中间操作,复杂度是 O(n),仿真速度会肉眼可见地掉。如果发现 scoreboard 成为仿真瓶颈,先检查是不是在热路径里做了中间删除——改成"标记无效、批量清理"通常能救回来。
再补一个选型时的常见纠结:既然队列也能按下标随机访问,为什么还需要动态数组?答案是内存与速度。队列在多数仿真器里是链表实现,每个元素额外带前后指针,存 100 万个 32 位整数实际占用可能是动态数组的三到五倍;而且 q[500000] 这种中段访问要顺着指针走,动态数组则是 O(1) 的基址加偏移。所以"数据量已知、写一次读多次"的场景(比如先把整个向量文件读进来再循环驱动)应该用动态数组,队列留给真正的流式缓冲。反过来,如果中途长度会变、要频繁头尾增删,就别用动态数组反复 new 拷贝硬撑——每次重建都是整段内存复制,比队列的指针操作贵得多。
六、常见坑清单
- 空队列 pop:
pop_front对空队列返回类型默认值并报警告(有的仿真器静默),比对逻辑会把"没数据"当成"数据为 0"放行。pop 前必查size()。 - 关联数组读到不存在的键:返回默认值不报错,配合"期望恰好是 0"就是假对。写之前
exists或读之前exists。 num()与size()混用:关联数组用num(),队列和动态数组用size()。- 对关联数组调用 sort:关联数组键无序概念,
sort/shuffle编译报错;要排序先拷到队列。 - 切片越界:
q[0:5]而队列只有 3 个元素,运行时直接报错终止,比 C 的越界读严格,但要先想清楚区间。 - 类句柄队列浅拷贝:
exp_q.push_back(tr)存的是句柄,之后对tr的修改会污染队列里的"期望"。入队前先tr2 = new tr或调clone(),深拷贝语义见 SystemVerilog 对象深拷贝浅拷贝。
这一篇在知识体系里的位置
本篇是 SV 数据容器线的实操篇,向上承接 SystemVerilog 打包与非打包数组 的类型基础,向下支撑三个直接应用:记分板用队列做期望比对(FIFO 与 find_index 的主战场)、存储器 backdoor 比对(关联数组稀疏建模)、随机化约束中的动态数组(容器与 randomize 的配合)。容器选型清楚了,UVM 环境里 monitor→scoreboard 的数据通路设计就有了底。
总结
SystemVerilog 队列是会自动伸缩的 FIFO(push/pop + 定位符 $ + 切片),关联数组是按键稀疏分配的哈希表(exists/first/next 遍历),配合 sort/shuffle/find/sum/max 等内建数组方法,可以一行完成排序、条件查找和聚合统计;选型口诀是"进进出出用队列、定长快取用动态数组、稀疏按键查用关联数组",而两个最大的坑是空队列 pop 静默出 0、关联数组读不存在的键不报错。