CUDA 归约 reduction:从朴素累加到 warp shuffle 的六版优化史
更新时间:2026-09-25。本文是「集成电路大类 · 芯片设计」进阶层(intermediate) 的一篇。求 N 个数之和,听起来是教科书第一章的小练习,可它恰恰是 CUDA 优化史上最著名的一道题:从一个慢吞吞的朴素 kernel 出发,经过六次迭代,带宽利用率从个位数百分比抬到逼近显存峰值。每一次改动都精确对应一个硬件事实——warp 锁步、访存合并、共享内存、分支发散。warp 为什么锁步、发散为什么腰斩利用率,先读 SIMT 分支发散:warp 遇到 if/else 为什么利用率腰斩;线程层次 grid/block/warp 的含义见 CUDA 线程层次:grid、block 与 warp;显存带宽的硬件背景见 GPU 内存层级与带宽:从寄存器到 HBM。
本文要回答的问题
- N 个数求和,串行累加是 O(N),搬上 GPU 后并行度从哪里来?为什么 log N 轮就能折完?
- 树形归约的朴素写法里,
tid % 2 == 0为什么让 warp 一半的 lane 空转? - 经典六版 reduction kernel 各自改了什么,提速从哪一版开始上量级?
- 每个 block 算出一个部分和之后,block 之间的结果怎么合并?
atomicAdd和二次 kernel 怎么选? - 归约是访存密集型 kernel,该盯哪个指标?典型带宽利用率和加速比是多少?
一、问题的形状:串行累加 O(N),并行折半 O(log N)
先看最朴素的求和:一个循环、一个累加变量、一个线程从头加到尾。N 个元素要做 N−1 次加法,步数随 N 线性增长,复杂度 O(N)。把它丢给 GPU 是巨大的浪费——一个线程在干活,SM 上几千个 lane 全程围观,GPU 相对 CPU 的算力和带宽优势一个都用不上。
加法有两个性质救了场:结合律与交换律。a+b+c+d 不必按顺序加,可以先两两配对 (a+b)+(c+d),两个配对互不依赖、同时进行;上一轮的结果再两两配对,每轮元素减半,直到只剩一个总和。N 个元素需要的轮数是 log2(N):8 个元素 3 轮,1024 个元素 10 轮,100 万个元素也只要约 20 轮。总加法次数仍是 N−1,总工作量没有减少,但步数(span,也称关键路径)从 O(N) 压到 O(log N)——这就是并行归约(parallel reduction),因其过程像把一排数据逐层对折,也叫树形归约或折半归约。
要注意树形归约并没有违反什么物理定律,它做的是「用资源换步数」:第 1 轮需要 N/2 个并行工作者,第 2 轮 N/4 个……前几轮的并行需求最大。GPU 恰好有海量线程,且对「线程越到后面越闲」这种模式不敏感——闲下来的 warp 不占发射资源,调度器直接切走。同一个思路在 SIMT 分支发散里是拖累,在归约里却是算法的自然形状。
二、树形折叠:每一轮邻居相加,同步进入下一轮
下图是 8 个元素的完整折叠过程。读图抓一个点:每一轮只做一件事——每个活动元素加上自己固定步长的邻居,然后半数元素「退役」;轮与轮之间必须有一道屏障同步,保证这一轮全部加完、结果都写回之后,下一轮才开始读。

把这张图翻译成 block 内的执行模型:block 的线程先从全局显存各读一个元素到寄存器(或共享内存),然后在共享内存上做折叠,每轮结束调一次 __syncthreads();最后由 0 号线程把 block 的部分和写回全局。输入数据在显存里应当连续摆放,使一个 warp 的 32 次装载合并成少量内存事务,访存合并的细节见 GPU 内存合并访问:coalescing。
这里顺手建立两个并行算法的度量概念,后文会反复用到。一是总工作量(work):所有线程执行的操作总数,树形归约是 N−1 次加法,和串行一样;二是步数(depth / span):关键路径上的操作轮数,树形归约是 O(log N)。一个朴素的问题是:既然第 1 轮有 N/2 个加法可并行,为什么不追求一步完成?因为那样需要 N/2 个加法器和 N/2 对输入连线,硬件规模随 N 线性膨胀,N=10 亿时不可想象。折半树是一种折中:log N 轮、每轮规模减半,用得住的硬件换可接受的时间。实际线程数 P 小于 N/2 时(GPU 也不可能无限),每轮的加法分多波执行,完成时间约为 O(N/P + log N)——这条 Brent 型估算解释了为什么 N 极大时前几轮的访存合并、带宽利用决定大局,而后几轮的优化主要在省同步与开销。
算法骨架确定后,真正的问题才刚开始:「哪些 lane 活动」怎么表达。同一张折叠图,可以写出性能相差几十倍的代码。
三、六版 kernel:每一次迭代对应一个硬件事实
NVIDIA 的 Mark Harris 在 2007 年前后把树形归约反复改写,留下了 CUDA 优化教学中最著名的一组对照实验。下面按演进顺序复盘六版(为突出要点,代码只保留归约循环,sdata 是 block 内共享内存数组)。
第 1 版:相邻配对,取模判活——warp 大分化。
for (int s = 1; s < blockDim.x; s *= 2) {
    if (tid % (2 * s) == 0)
        sdata[tid] += sdata[tid + s];
    __syncthreads();
}
第一轮只有偶数号线程活动,活动 lane 在 warp 内严格交错:0 干活、1 等待、2 干活、3 等待……条件结果在 warp 内五五对开,每一轮都触发最严重的发散,发射槽按 32 个 lane 计费,有用功却只有一半。
第 2 版:连续索引,活动 lane 挤在一起——去掉分化。
for (int s = 1; s < blockDim.x; s *= 2) {
    int index = 2 * s * tid;
    if (index < blockDim.x)
        sdata[index] += sdata[index + s];
    __syncthreads();
}
把「取模判活」改写成「按步长重排索引」,活动线程变成连续的前若干个:第一轮前 N/2 个、第二轮前 N/4 个。每个 warp 要么全员活动、要么整 warp 不活动,warp 内不再交错发散。
第 3 版:连续寻址的树形折半——消除共享内存 bank conflict。
for (int s = blockDim.x / 2; s > 0; s >>= 1) {
    if (tid < s)
        sdata[tid] += sdata[tid + s];
    __syncthreads();
}
第 2 版虽然不发散,但第一轮里同一个 warp 的线程访问的地址间隔为 2,共享内存的多 bank 机制被浪费(bank conflict 的原理见 GPU 内存层级与带宽)。这版反转循环方向:活动元素始终是数组前半段,步长逐轮减半。访问连续、无 bank conflict,地址计算也更简单。这一版是后续所有优化的标准底座。

第 4 版:载入时先加一次——全局流量直接减半。 前 3 版每个线程从全局显存只读一个元素。改成每个线程读两个(或多个)元素,先在寄存器里相加再写入共享内存,block 的共享内存用量和后续折叠轮数都减半,更关键的是全局显存事务量减半——归约是访存密集型 kernel,这一刀直接砍在瓶颈上。
第 5 版:循环展开,最后一个 warp 特化。 当折叠进行到只剩 32 个元素,它们全部落在同一个 warp 内,而 warp 是锁步执行的:lane 之间天然同步,不再需要 __syncthreads()。用 #pragma unroll 或手写把最后五轮完全展开、去掉屏障,省去同步指令和循环开销。再配合模板参数把 block 大小编译期常量化,把展开推广到全轮次。
第 6 版:warp shuffle 收尾,彻底不碰共享内存。 Kepler 架构引入束内洗牌指令后,最后 32 个元素的折叠连共享内存都不用:
for (int offset = 16; offset > 0; offset >>= 1)
    val += __shfl_down_sync(0xffffffff, val, offset);
if (tid == 0) sdata[warpId] = val;
__shfl_down_sync 让每个 lane 直接读到同 warp 内指定邻居的寄存器,五层蝶式相加全部在寄存器之间完成:没有共享内存读写、没有 bank conflict、没有屏障,32 个 lane 全程活动。现代工程代码(如 CUB 库)的归约收尾都是这个形态。
| 版本 | 关键改动 | warp 分化 | 访存特征(瓶颈视角) | 有效带宽(约) | 相对第 1 版提速(约) |
|---|---|---|---|---|---|
| 第 1 版 | 取模判活,相邻配对 | 每轮交错发散 | 每线程读 1 个全局元素 | 约 2 GB/s(约 2% 峰值) | 1 倍(基线) |
| 第 2 版 | 连续索引 | 基本消除 | 同上,指令效率改善 | 约 3–4 GB/s | 约 1.5–2 倍 |
| 第 3 版 | 步长减半、连续寻址 | 无 | 无共享内存 bank conflict | 约 10+ GB/s | 约 4–6 倍 |
| 第 4 版 | 载入即加 | 无 | 全局流量减半 | 约 25–35 GB/s | 约 10 倍以上 |
| 第 5 版 | 循环展开、末 warp 无同步 | 无 | 同步/循环开销大减 | 约 45–55 GB/s | 约 20 倍 |
| 第 6 版 | warp shuffle 末 32 元素 | 无 | 收尾零共享内存流量 | 约 60+ GB/s(约 70% 峰值) | 约 30 倍 |
表中带宽与提速是 G80/8800 GT 时代(显存峰值约 86 GB/s)的历史口径,数字为约数,随编译器和驱动浮动,但演进规律至今不变:先治分化,再治访存,最后治开销。每版单独看都不惊天动地,叠起来是数量级的差距。
把「改造前」与「改造后」两个端点单独抽出来对照,差距的形状会更清楚:
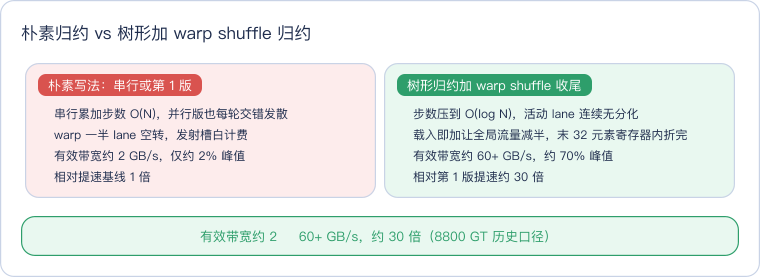
这张卡只强调一件事:左右两侧的算法思想是同一张折半树,差别全在「每一步是否贴着硬件约束写」。约 30 倍里没有一项来自更聪明的数学,全部来自消除分化、合并访存、砍掉同步与共享内存流量——这正是第三节六版迭代顺序的价值所在。
四、block 之间:部分和怎么并成一个总和
一个 block 最多上千线程,而 N 可能是几十亿,所以一次启动会有几十、几千个 block,每个 block 产出一个部分和。这一步的合并有三条主流路线。

原子加法。 block 末尾 atomicAdd(&total, partial)。block 数不多时(比如几十到几百个),竞争很轻,代码最省;block 数成千上万时,原子竞争序列化会成为可见的瓶颈,可让每个 block 先合并多份数据再原子写。
二次 kernel(两阶段归约)。 第一阶段把每 block 部分和写成一个小数组,主机端检查其长度,再启动第二个 kernel 对它归约;部分和仍然多时可再迭代。代价是一次额外的 kernel 启动和一轮全局读写,换回来的是无竞争、顺序可控。block 数特别多或需要严格归约顺序时,这是稳妥选择。
网格级归约(最后 block 技巧)。 用全局计数器标记最后一个完成的 block,由它等待其余部分和到齐后直接在同一个 kernel 内做第二轮归约。CUDA 9 的协作组(cooperative groups)提供了网格级同步原语后,这种写法有了正式支撑,省一次启动,但对调度和占用率有额外约束。
三条路线的选择可以量化:部分和数量记为 B(即 block 数)。B 在几十量级时,原子方案的冲突次数也就几十次,相对整个 kernel 的毫秒级耗时可以忽略;B 达到数万时,最坏情况下多个 block 同时原子写同一地址,每次原子读-改-写在显存侧串行推进,累加延迟可能到几十微秒量级,这时二次 kernel 只需一次连续读取加一轮折叠,明显更优。折中做法是让 block 内部多攒几轮再原子提交,把 B 压下来,兼顾单 kernel 的简洁。还要提醒一点:整型原子加法从早期硬件就支持,浮点 atomicAdd 的 double 版本到计算能力 6.0 才普及,老设备上需要用比较并交换(CAS)指令自己拼,性能和正确性都要小心。
五、性能数字:归约是典型的访存密集型 kernel
判断归约快不快,不看算力看带宽。归约每个元素大约只做一次加法,运算强度(每字节访存对应的浮点操作数)极低,在 roofline 图上牢牢落在带宽墙一侧:有效带宽占显存峰值的百分比,就是这个 kernel 的得分。N 很大、kernel 跑足够久时,现代实现的典型成绩是峰值带宽的 80%–95%。以数据中心卡为例,A100 级别 HBM 显存的归约有效带宽常见于约 1.4–1.8 TB/s(峰值约 2 TB/s 口径),与其对比,第 1 版风格的代码往往只能吃到几个百分点——这正是六版优化的现实意义。
历史数字同样说明问题:8800 GT 上六版迭代把约 2 GB/s 抬到 60 GB/s 以上,约 30 倍。注意这里的加速比全部相对「同样跑在 GPU 上的烂 kernel」,不是相对 CPU;对比 CPU 多核向量化实现时,GPU 的优势通常在数倍到十几倍,且随 N 增大、随启动开销被摊薄才显现。
为什么理论上归约读一遍、写极少数据,却仍可能吃不满带宽?拆开看有三类损耗:第一轮到最后一轮活动 warp 数指数衰减,后几轮整个网格只剩零星 warp,显存事务不满载;共享内存折叠和屏障虽然不碰显存,却占着发射槽;末尾 block 合并阶段还有一轮小数组的读和原子写。N 越大,首轮的满带宽流式读取占比越高,总效率越接近 80%–95% 的上限;N 偏小时这些固定损耗占比抬升,曲线明显下滑。第 4 版「载入即加」要求每个线程处理多个元素,第 6 版又把收尾的共享内存流量清零,本质上都是在砍这三类固定损耗。
小 N 是另一回事。一次 kernel 启动本身有数微秒开销,N 只有几千时,树形归约的 20 轮折叠可能比一次启动还便宜,总时间被启动 dominates,此时应让每个 block(甚至每个线程)处理多份数据,减少 block 数;N 小到几千以内,直接 CPU 计算再拷回去都可能更划算。工程上用 CUB 的 DeviceReduce 这类成熟模板时,它内部已经按这些规则选择策略,自己写只有在需求特殊(自定义算子、特殊数据布局)时才值得。
六、动手前先过这份清单
- 同步不能省也不能错放:每轮折叠后必须
__syncthreads(),且同步必须被 block 内全部线程无条件到达;放进只有部分线程进入的分支里是未定义行为。只有同一个 warp 内的末 32 元素折叠可以靠锁步省同步。 - bank conflict 要复查:跨步访问共享内存时用 profiler 确认 bank conflict 计数;第 3 版的连续寻址正是为了消灭它。
- 非 2 的幂要补齐:block 大小取 2 的幂,否则折叠逻辑要额外处理尾元素;边界数据越界保护也别漏。
- 浮点结果不满足结合律:树形相加改变了累加顺序,浮点结果与串行求和有末位差异,数据量级悬殊时差异可能放大;需要确定性结果时固定归约树形态或用补偿求和。
- shuffle 掩码与编译目标:
__shfl_down_sync的掩码要覆盖实际参与线程,编译架构低于 Kepler(计算能力 3.0)时不可用。 - 先测量再优化:profiler 看有效带宽、divergent branch 计数、bank conflict、原子吞吐;哪项出血治哪项,顺序照搬第三节的演进史即可。
- 归约不止求和:求最大值、最小值、逻辑与或、方差等「可结合的二元运算」都能套用同一骨架,区别只在算子和初值;但均值这类需要两个统计量的场景,常把「和 + 计数」打包归约,一次遍历同时折完,避免读两遍数据。
这一篇在知识体系里的位置
本篇属于芯片设计进阶层,回答「一个最基础的并行算子如何把 SIMT 的硬件约束逐个兑现成性能」。前置概念:GPU 为什么走众核吞吐路线见 GPU 与 CPU:为什么 GPU 走向了众核吞吐,warp 锁步与发散的完整分析见 SIMT 分支发散,grid/block/warp 线程层次见 CUDA 线程层次:grid、block 与 warp。横向配套:访存合并见 GPU 内存合并访问,共享内存、bank conflict 与 HBM 带宽见 GPU 内存层级与带宽,warp 调度器全景见 GPU 架构深入:SIMT、warp 调度与内存层级。再往后,扫描(prefix scan)、直方图与原子操作优化、roofline 建模是这条 GPU 并行算法线的后续专题。
总结
一句话总结:CUDA 归约(reduction)利用加法结合律把 N 个数求和从单线程串行 O(N) 变成每轮邻居相加、log N 轮折完的树形归约,工作量不变、关键路径对数压缩;经典六版 kernel 的优化史就是一部硬件约束兑现史——取模判活造成 warp 交错发散,连续索引和步长减半消除分化与 bank conflict,载入即加把全局访存减半,循环展开与末 warp 特化去掉同步开销,最后用 __shfl_down_sync 在寄存器间完成末 32 元素折叠,历史上把有效带宽从约 2 GB/s 抬到 60 GB/s 以上、约 30 倍提速;block 间的部分和按规模选择 atomicAdd、二次 kernel 或协作组网格同步;归约是访存密集型 kernel,现代实现的得分口径是有效带宽占显存峰值的 80%–95%,小 N 则被启动开销主导——先 profiler 测量、按「先治分化、再治访存、最后治开销」的顺序动手即可。