SV 日志解析:用 SystemVerilog 字符串处理把仿真日志反推成协议事件并自动触发断言
更新时间:2026-10-04。几乎每个验证平台都在哗哗地打日志,但绝大多数日志的命运是被 grep 两眼然后删掉——它们只是给人看的「痕迹」,不是给机器用的「数据」。换个视角:如果日志格式是受控的、每行都遵循固定语法,那么同一仿真进程里完全可以用 SystemVerilog 内建的字符串方法(
len、substr、atoi、sscanf这一族)把日志重新读回来,解析成结构化的协议事件流,再驱动自动比对、覆盖率采样甚至断言触发。这样日志就从「调试耗材」升级成「验证输入」。站内的 $sformatf 与格式化日志 讲了怎么把日志打得规整,UVM report verbosity 控制 讲了怎么控制日志的量与级,SV 字符串与文件 IO 讲了 string 类型和文件读写的基础件。这一篇把三者拧成一股绳:规整的日志 + 受控的级别 + 字符串解析能力 = 一条从日志到断言的自动化闭环。
本文要回答的问题
- 为什么要把仿真日志解析回结构化事件,它解决了什么「人肉看日志」解决不了的问题?
- 什么样的日志格式才是「可解析」的,格式设计有哪些必须提前立下的约定?
- SystemVerilog 字符串方法怎么组装成一个逐行解析器,核心代码长什么样?
- 解析出的事件流怎么驱动自动比对、覆盖率采样和断言触发?
- 这套闭环在仿真性能、维护成本上有哪些坑,纪律怎么定?
一、为什么要把日志读回来:日志是现成的全量事务流
先看一个真实的调试场景:某 AXI 主控在回归里偶发数据比对失败,scoreboard 报 mismatch 但没有上下文。工程师打开 200MB 的仿真日志,grep 到报错时间点,再前后翻几百行拼凑出「发起了一笔 burst、中间插了一次复位、恢复后重发」的故事线——整个过程四十分钟,而日志里其实什么都有,只是以纯文本的形式散着。
这个痛点的本质在于:验证环境里其实有两条事务流,一条走 UVM TLM 端口进了 scoreboard,一条走 $display 进了日志文件。TLM 那条流结构完整但可能被 scoreboard 的过滤逻辑裁掉、被 phase 边界切断;日志那条流是全量的、带时间戳的、人类可读的,但机器不可读。当 scoreboard 本身有 bug(漏收、乱序、丢包)时,你需要一条独立于 checker 的「第二视角」来交叉验证——日志解析恰好提供这条视角,因为日志和 checker 的消费路径完全不同,出同源错误的概率低得多。
更进一步,解析出的事件流还能干三件「人肉日志」干不了的事:一是自动比对,把日志事件和 scoreboard 收到的 TLM 事务逐条对账,谁多谁少一眼看穿;二是离线重放,回归结束后用脚本或另一个仿真进程读日志重建事件流,跑不同的检查策略而不用重新仿真;三是断言触发,当日志事件序列满足某个模式(比如「复位后三拍内出现写请求」)时主动拉高一个标志,作为 SVA 断言的前件触发源。日志从「被动记录」变成「主动驱动」,验证的杠杆率完全不同。
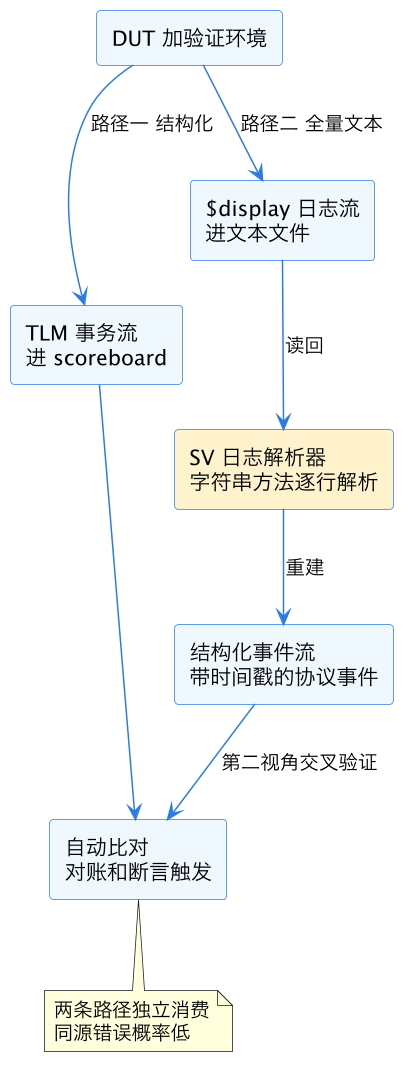
上图是整套思路的骨架:同一份激励在环境里产生两条消费路径,TLM 路径是主检查链路,日志路径经过解析器重建出结构化事件流,作为独立的第二视角与主链路对账。注意解析器跑在同一个仿真进程里(也可以跑在离线进程里),它消费的只是文本,不依赖任何 UVM 组件——这正是它作为交叉验证手段的价值所在。
二、可解析日志的格式约定:先立法再执法
日志解析的一切可行性都建立在「格式受控」上。如果各模块自由发挥——有的打十六进制有的打十进制、字段顺序随心、分隔符忽空忽逗——解析器还没写完就先疯掉了。所以第一件工程动作不是写解析器,而是立格式约定,并且让约定机器可校验。
一套可解析的事务日志格式,最低限度要满足四条。第一,每行一个事件,事件内部不跨行,跨行的只有续行标记(比如以 + 开头的续行),解析器按行切分即可。第二,固定前缀做路由:每行以一个带命名空间的事件标签开头,如 [AXI_WR]、[AXI_RD]、[RST],解析器用标签分发到不同的解析分支,不需要对每个模块的日志都写一套。第三,字段用 key=value 对,字段顺序无关、缺省可识别,比「按列对齐的裸值」抗变更能力强一个数量级——加字段不破坏旧解析器。第四,时间戳和 ID 必有:time=12345ns id=0x3f 这样的字段是事件排序与关联的锚点,缺了它们事件流就退化成一堆孤立的字符串。
| 格式决策 | 反例(不可解析) | 正例(可解析) | 理由 |
|---|---|---|---|
| 字段组织 | AXI write 0x1000 4 beat | [AXI_WR] time=120ns addr=0x1000 len=4 | key=value 顺序无关、可缺省 |
| 数据格式 | 时而 16 时而 0x10 | 统一 0x 前缀十六进制 | atoi 与 atohex 不混用 |
| 多行事件 | burst 数据裸换行 | 续行以 + data= 前缀 | 解析器可续行合并 |
| 级别控制 | 调试与事务混杂 | 事务行固定 UVM_MEDIUM 以上 | 靠 verbosity 一键关闭开销 |
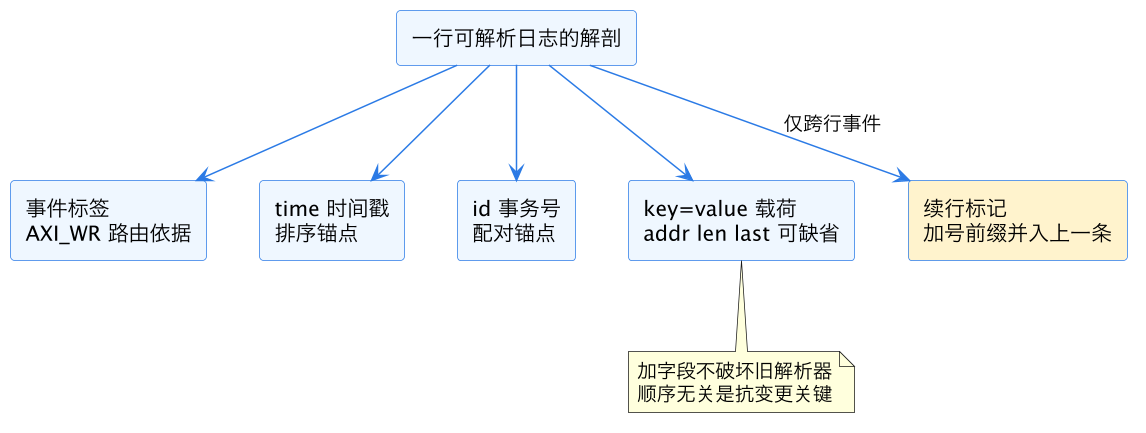
上图把一行可解析日志拆成五个部件:标签负责路由、时间戳负责排序、ID 负责与 TLM 事务配对、key=value 载荷承载协议字段、续行标记处理跨行事件。这五件缺一,下游消费就会瘸一条腿——没有 ID 就无法对账,没有时间戳就无法排序,没有标签路由就退化成全文模式匹配。
格式约定落地时最稳的做法是:所有事务日志只许通过一个宏或一个函数打。比如定义 LOG_AXI_WR(addr, len) 宏,内部用 $sformatf 拼成标准格式再 $display——$sformatf 的格式串集中在宏里,格式就只剩一份事实来源,谁也改不歪。这正是 $sformatf 与格式化日志 里强调的「格式集中化」思想,到了解析场景它从「好习惯」升级成「硬前提」。而级别的约定(事务行固定在哪个 verbosity 之上)直接对接 UVM report verbosity 控制:回归跑性能仿真时把 verbosity 压下去,事务日志整体消失,解析器自然空转,不产生额外开销。
三、逐行解析器的实现:字符串方法的组合拳
有了受控格式,解析器就是一层「字符串方法 + 状态机」的薄壳。SystemVerilog 的 string 类型内建方法足够用:len() 取长度、substr(i, j) 切子串、getc(n) 取单字符、atoi() / atohex() 转数值、icompare() 比较,配合 $sscanf 做模式化抽取,逐字段解析一行 key=value 日志大概二十行代码。
// 日志行示例:
// [AXI_WR] time=120ns id=0x3f addr=0x1000 len=4 last=1
class log_event;
  string tag;
  time   t;
  bit [31:0] addr;
  int unsigned len;
  bit last;
endclass

function automatic log_event parse_line(string line);
  string tag, kvs[$];        // 标签与键值分段
  string tok;
  int p;
  log_event ev = new();
  // 第一步:抽标签 [AXI_WR]
  if (line.len() < 3 || line.getc(0) != "[") return null;
  p = 1;
  while (p < line.len() && line.getc(p) != "]") p++;
  ev.tag = line.substr(1, p - 1);
  // 第二步:按空格切剩余部分,逐段 $sscanf key=value
  //   time=120ns 用 $sscanf(tok, "time=%dns", t)
  //   addr=0x1000 用 $sscanf(tok, "addr=0x%h", a)
  //   (完整切分代码略,思路:找空格边界循环 substr)
  return ev;
endfunction解析器的整体结构建议做成三段式:行级路由 → 字段级抽取 → 事件级组装。行级路由只认标签,用 case 把 [AXI_WR] 分发给 AXI 写解析函数、[RST] 分发给复位事件函数,遇到不认识的标签打一条 debug 日志丢弃(绝不能 fatal——日志里混入别的模块的行是常态)。字段级抽取用 $sscanf 的模式串,它比手工 substr 切割紧凑得多,且模式不匹配时返回 0 可直接当错误信号。事件级组装处理跨行:比如 burst 数据行以 + data= 开头时,把它并入上一个未完成事件的数据数组,直到 last=1 出现才把事件投递出去。字符串与文件逐行读取的基础件($fopen、$fgets、string 方法族)在 SV 字符串与文件 IO 里有完整清单,这里只强调一个选型:同进程在线解析用 $fgets 边打边读会读到自己的输出,工程上更稳的是离线解析——仿真结束后用脚本或第二个仿真进程读日志文件,在线解析只适合日志和解析器分属不同文件句柄的场景。
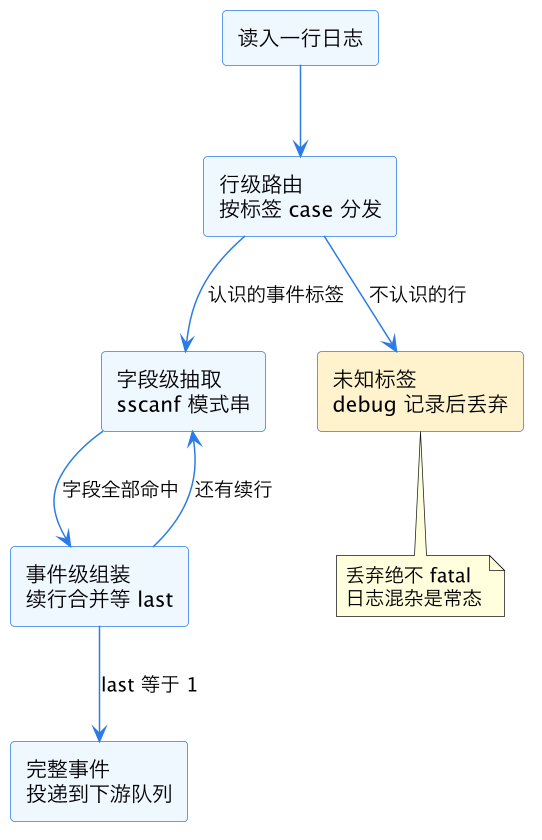
这张图把三段式流水画清楚了:路由只认标签、抽取靠模式串、组装管跨行。有两个纪律值得点出来。其一,未知标签一律丢弃而不是报错——日志文件里永远会混进你不拥有的行(别的 VIP、DUT 内部 $display、仿真器 banner),解析器必须「宽进」。其二,续行合并要有超时保护:如果一个事件等到仿真结束都没等到 last=1,说明日志被打断(比如仿真异常终止),此时应该把半成品事件标记为 incomplete 单独统计,而不是静默丢进下游污染比对结果。
四、事件流的三种消费:比对、覆盖率、断言触发
解析器吐出的事件队列是原料,真正的价值在下游三种消费方式。
第一种,与 scoreboard 对账。做法直观:解析事件和 TLM 事务各进一个队列,按 ID 配对后逐字段比对,数量、顺序、字段值三个维度出报告。它对「scoreboard 自身有 bug」这一类最隐蔽的问题几乎是唯一有效的探测手段——checker 没法检查自己,但日志可以检查 checker。某项目用这个方法抓到过一个经典事故:scoreboard 的 out-of-order 配对逻辑在 ID 回绕时丢事务,概率约千分之一,回归跑了几个月没人发现,直到日志对账报出「日志有、TLM 无」的系统性差额。
第二种,事件驱动覆盖率采样。covergroup 的采样点不一定非要挂在 monitor 上——把解析出的事件字段直接喂给 sample(),等于给「日志视角的行为分布」单独建了一份覆盖率。这份覆盖率和 TLM 路径采的覆盖率理论上应该一致,两者的 diff 本身就是一条健康指标:TLM 覆盖到了而日志覆盖没有,说明日志级别配置漏了某些事件;反过来则说明 monitor 丢事务。
第三种,断言触发源。这是把日志「读回」升级为「驱动」的关键一步。解析器在识别到特定事件模式时拉高一个标志信号,SVA 断言拿这个标志做前件。典型场景:验证「复位解除后第一个写事务必须落在配置寄存器区」——复位事件和写事件都先在日志里成对出现,解析器检测到「RST deassert」后把 expect_cfg_write 拉高,等 [AXI_WR] 事件到来时检查 addr 区间,不合规就 $error,合规就拉低标志。这比在 RTL 信号上写时序断言灵活得多,因为事件模式可以任意复杂(涉及多个模块、跨长时间的序列),而断言本体保持极简。断言写法的功底参照 SVA 断言实践,日志触发只是给前件提供了一个新的信号来源。
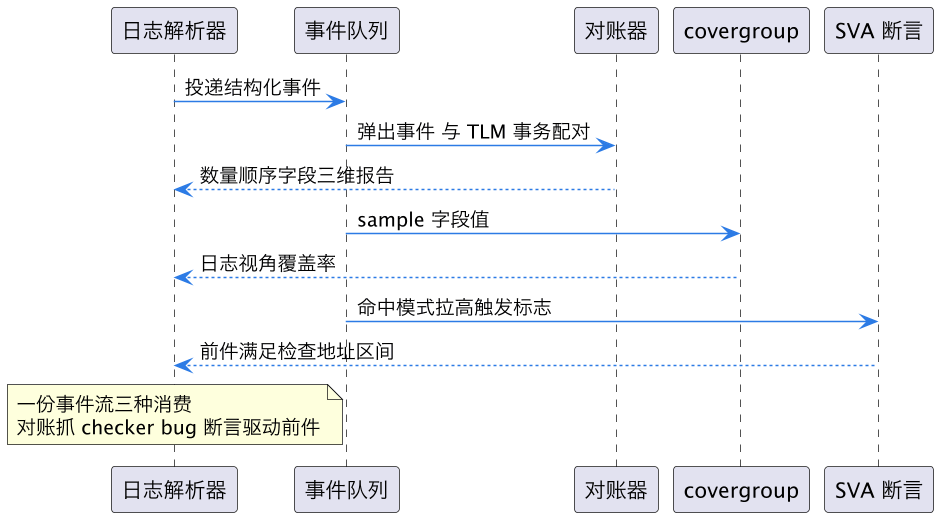
这个时序展示了事件队列扇出到三个消费者的结构:对账器做交叉验证,covergroup 做分布体检,断言做主动检查。三者在同一个仿真里并行跑、互不阻塞,任一发现异常都直接定位到具体事件行——因为每个事件都带着原始日志的行号和时间戳,从报告跳回原文只是一次 grep 的事。
五、性能、维护与边界:这套玩法的代价清单
讲完收益必须讲代价,否则就是卖假药。SV 日志解析闭环有三本账要算清楚。
第一本账是仿真性能。字符串处理在仿真器里是慢路径——一次 $sscanf 的开销大约是一次数值运算的几十倍,高频日志(每秒数万行)在线解析会把仿真拖慢 10% 到 30%。对策有三:事务日志只保留在必要的测试上,靠 verbosity 在性能回归里整体关闭;解析器只做离线后处理,把开销移出仿真关键路径;非解析不可的在线场景,把解析挪到独立的 SystemVerilog 进程或用 DPI-C 实现热路径(C 的字符串处理比 SV 快一个量级)。第二本账是格式漂移。日志格式约定写在文档里没人看,三个月后某个新模块用「顺手格式」打日志,解析器静默丢弃,事件流出现系统性缺口——这是最危险的失效模式,因为不报任何错。治理办法是让解析器输出丢弃行统计(按标签聚合的 drop count),回归报告里把「未知标签丢弃数非零」列为必须清零项,格式漂移就无所遁形。第三本账是适用边界:日志解析擅长的是「协议事件级」的重建,不擅长位级、拍级的精确时序——时间戳精度受 $display 时机影响,和真实信号沿可能差一个 delta cycle 甚至一个时钟拍。需要拍级精确的检查必须回到 clocking block 与 testbench 同步 的机制上,日志事件只能做「行为级」裁判,不能做「时序级」裁判。认清这个边界,才不会把工具用错地方。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下验证方法学线的一篇 S 层文,主关键词 SV 日志解析。向上承接三篇基础件:$sformatf 与格式化日志 提供格式集中化的生产端,UVM report verbosity 控制 提供日志量的开关,SV 字符串与文件 IO 提供解析的字符串方法工具箱——本篇把三者组装成「日志 → 事件 → 检查」的完整闭环。横向与 SVA 断言实践(日志事件充当断言前件触发源)、clocking block 与 testbench 同步(拍级精确检查的边界分工)、验证环境调试方法学(第二视角交叉验证的思想源头)互为补充。向下,「日志对账抓 checker 自身 bug」的思路可直接迁移到 回归管理方法学 的回归健康度监控,丢弃行统计进回归报告就是那里「必须清零项」清单的一个新成员。
总结
SV 日志解析的本质是把仿真日志从「给人看的痕迹」升级为「给机器用的事务流」:先立可解析的格式约定(每行一个事件、标签路由、key=value 字段、必带时间戳和 ID,格式串集中在宏里唯一维护),再用 SystemVerilog 字符串方法族(substr、sscanf、atohex)搭一个「行级路由 → 字段抽取 → 事件组装」的三段式解析器,把日志重建为带时间戳的结构化事件流,然后一份事件流三种消费——与 scoreboard 对账抓 checker 自身的 bug、喂 covergroup 建第二份覆盖率、命中模式时拉高标志给 SVA 断言做前件;代价上要管住三本账:高频解析靠 verbosity 和离线化压住仿真开销,格式漂移靠「未知标签丢弃数必须清零」的回归纪律堵死,拍级精度的检查认清边界交还给 clocking block——日志打得好,它就是验证环境里那条不要钱的第二 checker。