Medusa EAGLE 投机解码:自投机两条路线的多头草稿与特征级草稿模型全解
更新时间:2026-10-01。在 投机解码推理加速 里我们讲过投机解码的基本范式:用小模型起草、大模型并行验证,把自回归的串行解码折叠成一次前向验多个 token。那一篇留了一个问题——草稿从哪来?独立小模型有分布漂移和部署双份权重的麻烦,于是社区走向「自投机」:让大模型自己长起草能力。Medusa 和 EAGLE 就是这条线上的两个代表,也是本文的主角。Medusa EAGLE 投机解码的对比,本质是「在原模型上加头」与「在特征层训练草稿模型」两条路线的取舍。
本文要回答的问题
- Medusa 的多头结构长什么样,多个解码头怎么做到一次前向猜出多步 token?
- Medusa 头的训练数据从哪来,冻结主干和全量微调两种训法差在哪?
- EAGLE 为什么改在特征层(hidden states)起草,它解决了 Medusa 的什么痛点?
- 树状注意力(tree attention)怎么把多个候选路径塞进一次验证前向?
- 接受率、平均接受长度、实际加速比怎么算,两条路线在不同任务上各是多少?
一、从独立草稿模型到自投机:为什么要把起草能力长进大模型
先回忆投机解码的核心不等式:只有当「草稿 token 足够便宜」且「接受率足够高」时,投机才赚钱。独立小模型方案(比如用 1B 模型给 70B 模型起草)有两个结构性问题。
第一,分布对齐难。草稿模型的输出分布和目标模型越不一致,验证时拒绝率越高。两个独立训练的模型分词器要一致、词表分布要接近,实践中常常要专门蒸馏对齐,即便如此接受率也常在 60%-75% 徘徊。
第二,部署双份权重。推理系统要同时加载两套模型、管两套 KV Cache(KV Cache 的机制见 KV Cache 推理显存),调度和显存规划都复杂化。
自投机(self-speculative)的思路是:目标模型自己的中间表征里已经包含了「下一个词大概率是什么」的信息,为什么不直接利用它?Medusa 利用的是最后一层 hidden state 加几个并行头,EAGLE 利用的是特征层序列加一个轻量自回归头。两者都不需要第二个完整模型,起草开销降到原来的百分之几,部署时只需要在原推理流程里多挂一个小模块。
这张图是整个自投机家族的地图:左边是被替代的独立草稿方案,右边分出两条路线。注意一个共性——起草模块都寄生在目标模型的前向里,共享主干计算,这是接受率和部署便利双赢的根源。
二、Medusa:在最后隐藏层上插一排并行头
Medusa 的结构直白得可爱:原模型最后一层输出的 hidden state h_t,本来只喂给一个 LM head 预测第 t+1 个 token;Medusa 额外加 K 个头,第 k 个头专门预测第 t+1+k 个 token。每个头就是一个一两层的残差 MLP 加一个词表大小的线性投影。
一次前向之后,K 个头各自吐出一个分布,取 top-k 候选就能拼出一棵候选树:头 0 给第 1 步的 top-3,头 1 给第 2 步的 top-2……笛卡尔积展开成多条候选路径,交给目标模型用树状注意力一次验证。

注意 Medusa 头的预测是并行且相互独立的:头 2 预测 t+3 时,并不知道头 1 实际猜了哪个 token 当 t+2。这带来一个理论短板——条件信息缺失,位置越靠后的头预测越不准。Medusa 论文里的头准确率衰减很明显:头 0 的 top-1 准确率可能 70%+,头 3、头 4 掉到 20%-40%。所以 Medusa 候选树通常前宽后窄,深层位置只取 top-1 或 top-2,避免候选数爆炸而验证算力白费。
候选树的具体形状也有讲究。Medusa 官方给了一组手工调过的稀疏树配置:不是每层都取满 top-k,而是按各头的实际准确率分配候选预算,例如头 0 取 top-8、头 1 取 top-4、头 2 之后只取 top-1,整棵树约 60 个节点。这背后的账很直观——验证一次前向的成本随节点数近似线性涨,但深位置候选的命中率本来就低,把预算堆在那里是亏本买卖。实际部署时可以用一小段业务语料跑一遍准确率统计,再反推树形,比照搬论文配置通常能多挤出 5%-10% 的接受长度。
训练上 Medusa 给两种模式。Medusa-1 冻结主干,只训新增的头,用主干在同一语料上跑出的 hidden states 做监督信号,优点是不动原模型权重、随插随拔,一张卡几小时就能训完一个 7B 模型的全套头;Medusa-2 连主干一起微调(配 LoRA 或全量),接受率更高但要保住原模型能力不退化,训练配方更讲究,通常是主干学习率压低一个量级、头的损失加权放大。训练数据的 trick 是 self-distillation:没有额外语料时,让原模型自己生成一批文本,再用这批文本训头,保证头的目标分布就是目标模型自己的分布——这一步对接受率的贡献经常被低估,尤其在代码、数学这类领域文本上,通用语料训出来的头和 self-distillation 训出来的头,接受率能差出十个百分点。
三、EAGLE:把起草挪到特征层,自回归补回条件信息
EAGLE 观察到 Medusa 短板的根源:token 层并行预测丢掉了条件依赖。它的解法是把草稿做成一个特征层的自回归小模型——输入是「目标模型中间层的特征序列」加上「右移一位的 token 嵌入」,一个单层(EAGLE-1)或少数层的 Transformer decoder,自回归地逐个起草。
为什么用特征而不是 token?两个理由。其一,特征比 token 平滑:token 是离散的、one-hot 式的突变,特征空间连续,起草模型学的是「给定上文特征,预测下一步特征」,比直接预测离散 token 容易收敛,训练更稳。其二,特征里信息更全:目标模型的 hidden state 已经编码了它对后续 token 的「预期」,草稿模型等于站在目标模型的肩膀上起草,分布天然贴近。
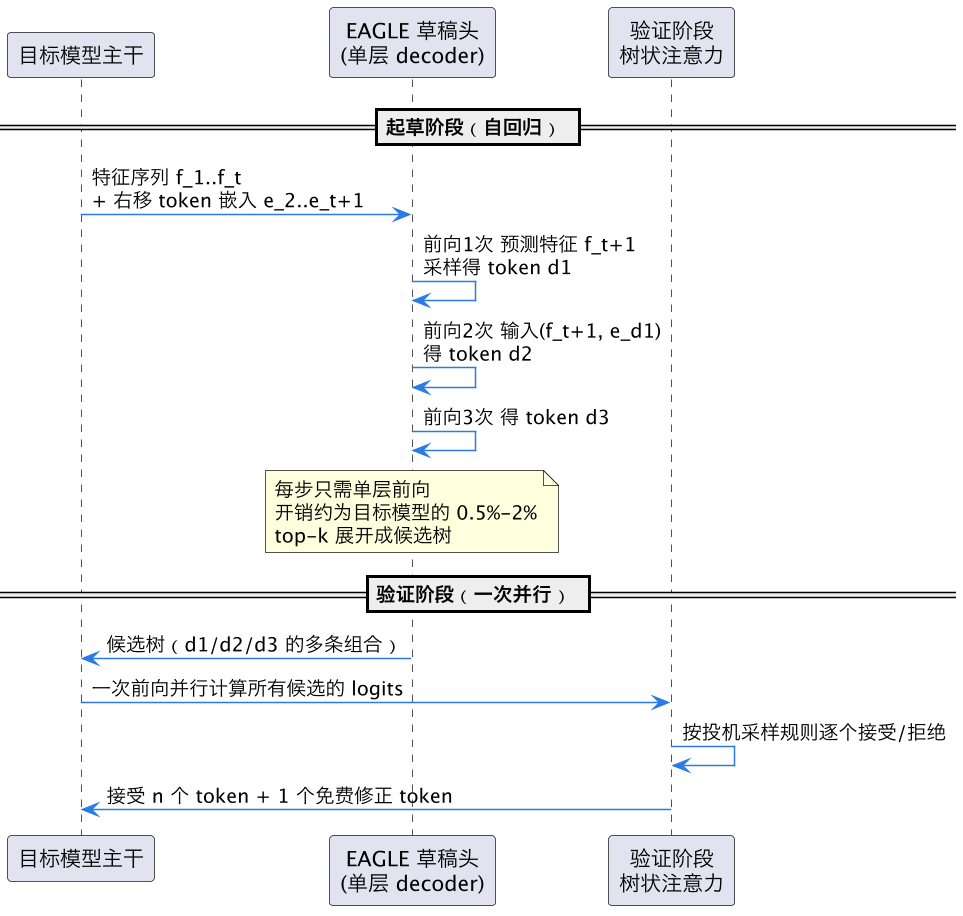
这张时序图把 EAGLE 的一轮循环画完整了:起草阶段是草稿头的小步快跑(每步成本极低),验证阶段回到目标模型的一次并行大前向。「+1 个免费修正 token」是投机采样的固有红利——即使草稿全错,验证时目标模型也会产出自己的下一个 token,一轮至少前进 1 步,所以投机解码在正确性上与原模型严格等价(采用典型接受-拒绝采样时输出分布不变)。
EAGLE 的训练目标也相应变成双损失:特征回归损失(预测的特征逼近目标模型真实特征,L1/smooth L1)加 token 分类损失(用预测特征过原 LM head 后的交叉熵)。训练数据同样走 self-distillation,冻结目标模型主干,只训草稿头,7B 模型的草稿头在单卡上训练一天以内可收敛。EAGLE-2 在此基础上加了动态候选树:根据草稿头自己的置信度在线决定树的形状,置信度高的分支多展开、低的早剪,同样验证预算下平均接受长度再提一截。EAGLE-3 则去掉了「特征必须逼近目标特征」的约束,改用多层特征融合加 training-time test(训练时模拟多步起草的误差累积),进一步放开接受率上限。三代演进的主线很清晰:从「结构补条件」到「预算自适应」再到「训练目标松绑」,每一代都在同一框架内把接受率往上推。
四、树状注意力:多条候选路径的一次并行验证
两条路线最后都汇到同一个基础设施上:树状注意力(tree attention)。候选不是一条链而是一棵树,验证时要让树上每个节点只 attend 到它自己的祖先路径——普通 causal mask 做不到,需要自定义注意力掩码,把树的拓扑编进 mask 里;位置编码也要按「节点在树上的深度」而不是「在展平序列里的下标」来赋。

工程上要抓住两个数字。一是树的节点数:30-60 个节点是甜区,再大验证前向的计算量就追上收益(解码阶段每步是访存受限,几十 token 的并行前向几乎不加时延,但几百上千就开始吃吞吐)。二是接受路径的提取:验证后要按投机采样规则从根往下走,遇到第一个被拒的节点就停,把该路径上已接受的 token 和修正 token 一起提交,然后 KV Cache 里没被接受的分支要整段丢弃——这也是为什么自投机共享 KV Cache 时内存管理要额外小心(相关背景见 KV Cache 推理显存)。
还有一个容易被忽略的实现细节:草稿阶段的每一步其实也要维护草稿自己的 KV。Medusa 的头只挂在最后一层,不维护注意力状态,所以免了这件事;EAGLE 的草稿头是带注意力的 decoder 层,起草几步就要为它自己留几步的小 KV,好在草稿头层数少、隐藏维也可以压缩,这份额外状态通常不到主干 KV Cache 的 1%,可以忽略。真正要小心的边界情形是长上下文末尾:当剩余 KV 容量不足以容纳「候选树全量节点」时,推理框架要能动态把树剪小,否则一次投机就可能触发不必要的 KV 逐出,反而拉慢整体吞吐。
五、接受率与加速比:两条路线的实测账
把两条路线放一起对比,先给定义:接受率是草稿 token 被验证通过的比例;更有用的是平均接受长度 τ(一轮循环平均前进几个 token,含免费修正 token),它和端到端加速比近似成正比,因为每轮的成本约等于「一次目标模型前向 + 草稿开销」。
| 维度 | Medusa(多头) | EAGLE(特征级草稿) |
|---|---|---|
| 起草结构 | 最后 hidden state + K 个并行头 | 特征序列 + 单层自回归 decoder |
| 条件信息 | 头间独立,深位置缺条件 | 自回归,每步看到已起草内容 |
| 起草开销 | 一次前向(极低) | K 次小前向(仍 <2%) |
| 训练信号 | token 交叉熵(可选蒸馏) | 特征回归 + token 交叉熵 |
| 主干是否微调 | Medusa-1 冻结,Medusa-2 微调 | 冻结 |
| 平均接受长度(70B 级、温度0) | 约 2.5-3.0 | 约 3.2-4.0(EAGLE-2 更高) |
| 端到端加速比(单请求解码) | 约 1.9-2.4x | 约 2.5-3.5x |
| 集成成本 | 低,改 LM head 即可 | 中,需特征抽取与双输入路径 |
几个读表要点。第一,加速比都对单请求/小批量、访存受限的解码场景成立;大批量下 GPU 已经算力打满,验证的额外计算会反噬吞吐,这时该调小候选树甚至关掉投机。第二,温度升高时接受率普遍下降,两条路线都掉,EAGLE 凭借条件建模掉得稍缓。第三,任务类型影响很大:代码补全、模板化问答这类高可预测文本,τ 能再上浮 30%-50%;开放式创作类文本则回落。第四,表里数字是论文与主流框架公开基准的常见区间,具体到你自己的模型和业务语料,先用几百条真实请求跑一次接受长度统计再谈收益承诺,比直接引用论文数字稳妥得多。
选型判据可以压成一句话:要最快落地、改动最小,选 Medusa;要最高接受率和加速上限、愿意多接一条特征通路,选 EAGLE。 生产系统里两者也不互斥,Medusa 的头可以当作 EAGLE 草稿的补充候选来源,vLLM、TensorRT-LLM 等框架都已内置两者的推理路径。另外别忘了自投机和量化是正交手段——把目标模型做到 INT4 KV Cache(见 KV Cache INT4 量化)之后,解码访存压力下降,投机解码的相对收益会略微收窄,但叠加后的绝对时延仍是两者各自单独做不到的水平。
还有一类容易混淆的方案值得点一句:注意力头数削减(GQA/MQA,见 GQA MQA 注意力显存节省)省的是 KV Cache 的访存量,和投机解码省的是「前向次数」,二者乘性叠加,调优时分开算账别混为一谈。
这一篇在知识体系里的位置
本篇是 投机解码推理加速 的下半篇:那一篇立范式(起草-验证-接受采样),这一篇填草稿模型的两条自投机实现路线。横向关联上,接受率高低依赖目标模型的表征质量,验证开销依赖注意力与 KV Cache 成本,这两条支线分别通往 GQA MQA 注意力显存节省 与 KV Cache 推理显存;往显存压缩方向再深一步是 KV Cache INT4 量化。实践中 EAGLE 与 Medusa 已被 vLLM、SGLang、TensorRT-LLM 收编为标准推理路径,读框架源码时本篇的结构图可以直接对上号。
总结
Medusa EAGLE 投机解码代表了自投机解码的两条路线:Medusa 在目标模型最后隐藏层插一排并行头、一次前向猜多步,胜在改动小、落地快;EAGLE 在特征层训练一个轻量自回归草稿头、用特征加 token 双输入补回条件依赖,胜在接受率与加速比上限更高——两者共享树状注意力验证基础设施,单请求解码场景下分别带来约 2 倍与 2.5-3.5 倍加速,选型就看你要「最小侵入」还是「最高上限」。