UVM验证计划Verification-Plan模板:五个槽位照填就能开工
本篇是 芯片验证 版图里的一份可填模板,面向刚接手第一个模块的验证新手。站内已有一篇 验证计划模板:从 Spec 到覆盖率收口,那篇讲「Spec→功能点→覆盖率→断言→用例」的追踪链怎么建;本篇不重复那条链,只解决一个更朴素的问题:第一次独立带一个小模块的 UVM 验证,验证计划文档第一版怎么落笔。模板按 UVM 项目的实际消费方式分成五个槽位,每个槽位给填写要点和一段 AXI-Lite 外设的填写示范,复制改字即可用。
新手写验证计划最常见的失败模式是:把 Spec 抄一遍当作「特性点」,把「随机跑一百万次」当作「回归策略」,评审时每个字段都有字、执行时每条都对不上号。这份模板的每个槽位都带「填什么、不填什么」的硬约束,专治这种空转。
本文要回答的问题
- 一份 UVM 验证计划最少需要哪五个槽位,各自回答谁的问题?
- 特性点拆到什么粒度,定向用例、随机用例、覆盖率组三种手段怎么分工?
- 通过标准怎么写才不至于收口时扯皮?
- 拿到模板后照着填的顺序是什么,每个槽位最常见的填错姿势是什么?
一、模板的五个槽位与使用场景
这份模板面向的场景是:模块级(block-level)UVM 验证,DUT 是一个带标准总线接口的中小模块,验证环境用 UVM 搭建,回归跑在 CI 或调度器上。如果你做的是 SoC 级验证或纯 Formal 收敛,槽位结构要调整,参考 验证签核标准方法论 里对分级验证的划分。
五个槽位的分工对应验证执行的五个决策时刻:
- 特性点清单:回答「要验什么」,是后续一切条目的锚;
- 测试用例映射:回答「谁来验」,每个特性点挂定向用例、随机用例或覆盖率组;
- 覆盖率模型:回答「怎么知道验够了」,列出 covergroup 与目标值;
- 通过标准:回答「什么时候算完」,把收口条件写成可判定的布尔表达式;
- 回归策略:回答「平时怎么跑」,回归频率、种子数、失败处理流程。
三种验证手段的分工是新手最容易混淆的地方,下面这张对比卡把三者的职责边界摆清楚——填映射槽位时,每个特性点必须先想清楚归哪一类:
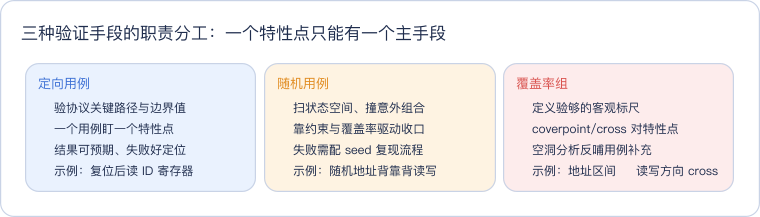
读这张卡记住一句话:一个特性点有且只有一个主验证手段,其余两种是辅助。全挂定向说明你没想清楚随机价值,全挂随机说明你没想清楚边界——评审时这是第一个被挑战的点。
拿到模板后的前两个小时建议这样花:第一小时只干一件事——把 Spec 通读一遍,把所有「shall / 必须 / 应当」的句子划线,这些句子就是特性点的候选原料;第二小时把划线句子逐条改写成「一句话行为描述」,能写清的留下,写不清的标记出来去找设计工程师问明白。这两个小时不碰任何 UVM 代码,也不写用例名——先把「要验什么」锁死,后面四个槽位才有稳定的锚。很多新手反过来,上来就搭环境写用例,计划最后补,结果用例成了既成事实、计划沦为用例列表的复读机。
二、完整模板全文(可复制)
下面就是模板本体,Markdown 格式,直接整块复制进项目仓库的 doc/vplan.md 再逐槽改写:
# <模块名> UVM 验证计划

- 版本 / 作者 / 日期 / 关联 Spec:<版本号与链接>

## 1. 特性点清单

| ID | 特性点 | 来源(Spec 章节) | 主验证手段 | 优先级 |
|----|--------|-------------------|-----------|--------|
| F1 | <一句话特性描述> | <Spec 3.1> | 定向 / 随机 / 覆盖率组 | P0 |

## 2. 测试用例映射

| 特性点 ID | 用例名(UVM test 类名) | 类型 | 关键约束/激励 | 期望结果 |
|-----------|------------------------|------|---------------|----------|
| F1 | <xxx_smoke_test> | 定向 | <固定激励> | scoreboard 比对通过 |

## 3. 覆盖率模型

| covergroup | coverpoint / cross | 对应特性点 | goal | weight |
|------------|--------------------|-----------|------|--------|
| <cg_axi_addr> | <cp_addr_range> | F2 | 100% | 1 |

## 4. 通过标准

- [ ] 所有 P0 特性点用例连续 N 次回归 100% pass
- [ ] 功能覆盖率 >= <98>%,代码覆盖率 >= <95>%(豁免项附审批链接)
- [ ] 覆盖率空洞逐条有结论(已补用例 / 合理不可达并豁免)
- [ ] 无未解释的 UVM_ERROR / UVM_FATAL

## 5. 回归策略

- 触发:每日定时 + RTL 合入前强制
- 规模:smoke <N1> 个用例 10 分钟内;nightly 全量 <N2> seed
- 失败处理:24h 内 triage,flaky 用例隔离并单独立项
五个槽位的编号顺序就是填写顺序:先把特性点列全,再逐条决定手段、再补覆盖率组,最后定通过标准和回归节奏。倒着写(先写回归策略再回头找特性点)几乎必然导致映射表大面积返工。
三、逐槽位填写要点与常见填错姿势
特性点清单。粒度标准是「一句话能说清行为 + 一个用例或一个 coverpoint 能验掉」。太粗(「验证寄存器读写功能」)会让映射表无从下手;太细(「验证地址 0x00 的第 0 位写 1」)会让清单膨胀到维护不动。常见错误是把 Spec 的章节标题直接抄进来——章节标题是文档结构,不是可验证行为。
测试用例映射。UVM test 类名要在文档阶段就定下来并和代码仓库一致,不然回归报告和计划对不上号。「关键约束」一栏写随机用例的约束意图(如「地址约束在 0x00–0x3F,写读比 3:1」),不要写实现细节。特性点到用例允许一对多,但必须在表里显式列出每一行,禁止「等」字。
覆盖率模型。每个 coverpoint 必须能反查到特性点 ID,反查不到的就是装饰性覆盖率,评审时删掉。goal 写 100% 是常态,写不到 100% 的要在通过标准里预设豁免流程。covergroup 的设计细节(bins 怎么切、cross 怎么定义)展开见 testplan 与覆盖率映射,本文只管它在计划里的落位。
通过标准。每条都写成可判定的形式:「覆盖率 >= 98%」可以判定,「充分验证」不可以。「连续 N 次回归」里的 N 按模块稳定性取 3–7,写 1 等于没写。豁免项必须要求附审批链接,否则豁免栏会成为垃圾场。
回归策略。smoke 与 nightly 分层是硬性要求——smoke 给合入门禁用,nightly 给覆盖率收口用,两层混跑会让合入等待时间失控。flaky 用例的处置要写进计划(隔离 + 立项),不然它们会每晚随机失败、把回归报告的可信度磨光。回归频率与资源量的权衡见 回归管理方法论。
四、填写示范:AXI-Lite 外设模块摘录
以一个带 8 个 32 位寄存器、支持单拍读写的 AXI-Lite 外设为例,五个槽位各摘一段填好的样子:
## 1. 特性点清单(摘录)

| ID | 特性点 | 来源 | 主验证手段 | 优先级 |
|----|--------|------|-----------|--------|
| F1 | 复位后 CTRL/STATUS/ID 寄存器读出默认值 | Spec 4.2 | 定向 | P0 |
| F2 | 任意地址单拍写后立即读回,数据一致 | Spec 4.3 | 随机 | P0 |
| F3 | 对保留地址访问返回 SLVERR | Spec 4.5 | 定向 | P1 |
| F4 | AWVALID 与 WVALID 任意到达顺序下事务正确完成 | Spec 3.2 | 随机 | P1 |

## 2. 测试用例映射(摘录)

| 特性点 | 用例名 | 类型 | 关键约束 | 期望结果 |
|--------|--------|------|----------|----------|
| F1 | axil_reset_value_test | 定向 | 复位后逐寄存器读 | 与 Spec 默认值逐位一致 |
| F2 | axil_rw_b2b_test | 随机 | addr∈[0x00,0x1F],b2b 间隔 0-3 拍 | scoreboard 读回比对全过 |

## 3. 覆盖率模型(摘录)

| covergroup | coverpoint / cross | 特性点 | goal |
|------------|--------------------|--------|------|
| cg_axil_addr | cp_addr(8 个有效地址 bin + 保留 bin) | F1/F2 | 100% |
| cg_axil_hs | cross: AW 先到 / W 先到 / 同拍 | F4 | 100% |

## 4. 通过标准(摘录)

- P0 用例连续 5 次 nightly 回归 100% pass
- 功能覆盖率 100%(模板示例模块规模小,不预设豁免)

## 5. 回归策略(摘录)

- smoke:axil_reset_value_test + 3 个定向用例,< 8 分钟,合入门禁
- nightly:全量 8 用例 × 200 seed;flaky 隔离进 quarantine 列表
注意 F4 的写法:这个特性点的行为(握手信号到达顺序)用定向用例很难穷举,所以主手段给随机,再用一个 cross 覆盖率把「三种顺序都出现过」变成可判定目标——这就是「手段分工 + 覆盖率兜底」的典型搭配。
五、使用注意事项
- 模板第一版不求全,求「每条可追溯」。宁可先填 10 条干净的特性点,也不要 50 条抄 Spec 的凑数条目。
- 优先级列不许全填 P0。全 P0 等于没有优先级,回归资源紧张时无法裁剪。经验比例是 P0 占六成、P1 三成、P2 一成,P2 允许在收口压力大时经评审后裁剪。
- 计划是活文档:每次覆盖率空洞分析、每次评审结论都要回填进对应槽位,版本号跟着 Spec 走。Spec 升版后第一件事是 diff 出变更条目,逐条评估对特性点清单的影响,而不是等回归失败才发现计划过期。覆盖率收口的持续推进方法见 功能覆盖率收口计划。
- 通过标准一旦写入计划并被评审接受,收口阶段不许临时降低;要降就重走评审,这是这份模板存在的意义。
- 表格字段可按项目增删(比如加「负责人」「预估工时」列),但五个槽位本身不建议删——删掉任何一个,评审时都会以另一种形式被问回来:删了通过标准,收口时扯皮;删了回归策略,nightly 失败无人认领。
这一篇在知识体系里的位置
本篇是芯片设计入门系列的模板篇,与 验证计划模板:从 Spec 到覆盖率收口 互补:那篇管追踪链方法论,本篇管第一版落笔的可填表单。上游依赖 UVM 环境搭建的知识,见 UVM 测试平台架构;下游衔接 testplan 与覆盖率映射 与 回归管理方法论,五槽位填满后回归怎么跑、覆盖率怎么收,在那两篇里继续展开。
总结
这份 UVM 验证计划模板把计划拆成五个槽位:特性点清单定锚、测试用例映射分工、覆盖率模型定量、通过标准收口、回归策略保节奏。填写时守住三条纪律——一个特性点一个主验证手段、每条通过标准可判定、用例名与代码仓库一致——再照着 AXI-Lite 示范逐槽改写,新手也能在半天内交出一份评审不返工的验证计划第一版。