FPGA 专家 26:设备驱动与 OS——让主机把 FPGA 当成一台设备用起来
本文是
fpga/专家层第 29 篇。PCIe/TLP/BAR 硬件侧见 专家 07,DMA 架构见 专家 08,云端多租户见 专家 30。
一、主机视角:FPGA 就是"寄存器 + 缓冲 + 门铃 + 中断"
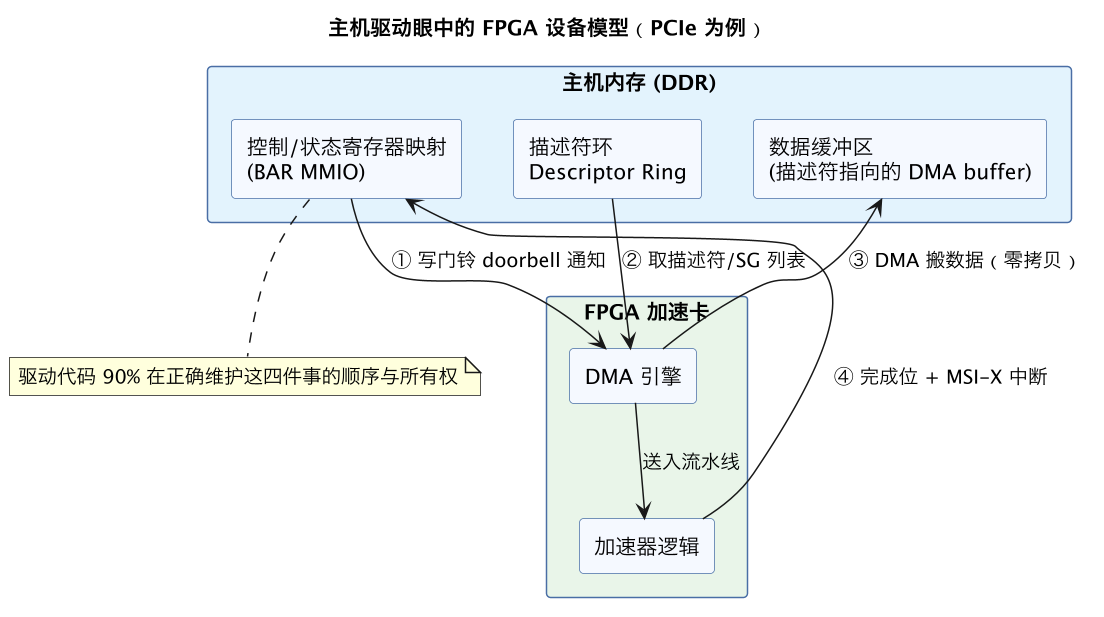
用户进程  ──写命令──► 描述符环(共享内存) ──doorbell(MMIO写)──► FPGA 引擎
   ▲                              ▲                                │
   │ mmap BAR / 用户态轮询         │ pin+map(物理/IOVA)             │ DMA
   └──完成轮询/MSI-X◄──────────────┴──────────────── 主机 DDR ◄─────┘
四个必须解决的问题:地址怎么翻译(虚→物理/IOVA)、数据怎么同步(缓存一致性)、谁通知谁(doorbell/MSI-X)、怎么并发保护(屏障与队列)。
二、驱动方案光谱
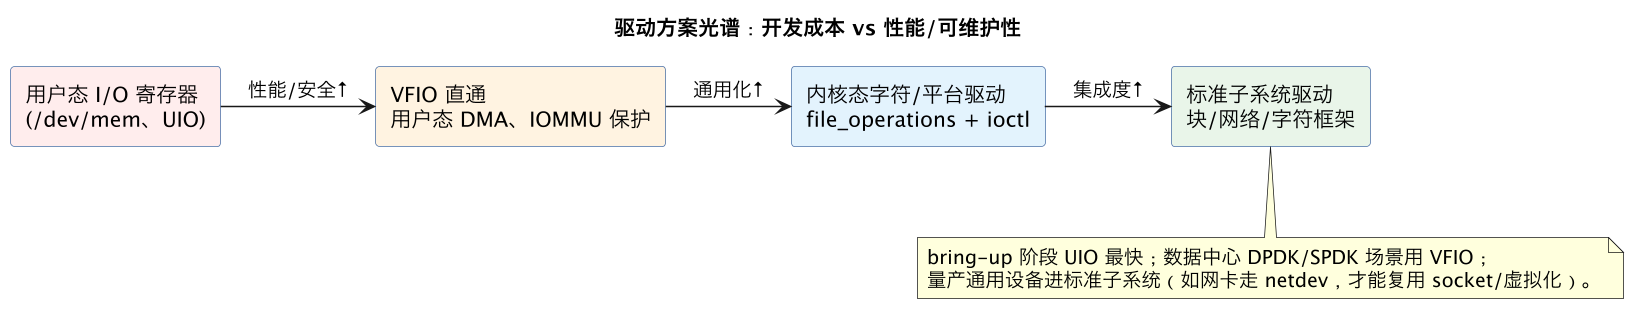
| 方案 | 内核代码量 | 性能/延迟 | 隔离安全 | 适用 |
|---|---|---|---|---|
| /dev/mem 裸 mmap | 0 | 高 | 无,危险 | 实验室原型 |
| UIO | 极小模块 | 高(可轮询) | 弱 | 自研设备、快速开发 |
| VFIO | 0 自研(框架) | 高、用户态 | IOMMU 隔离 | DPDK/SPDK、云直通 |
| 完整字符/平台驱动 | 大 | 看实现 | 完整、标准 | 正式产品 |
三、DMA 两类映射
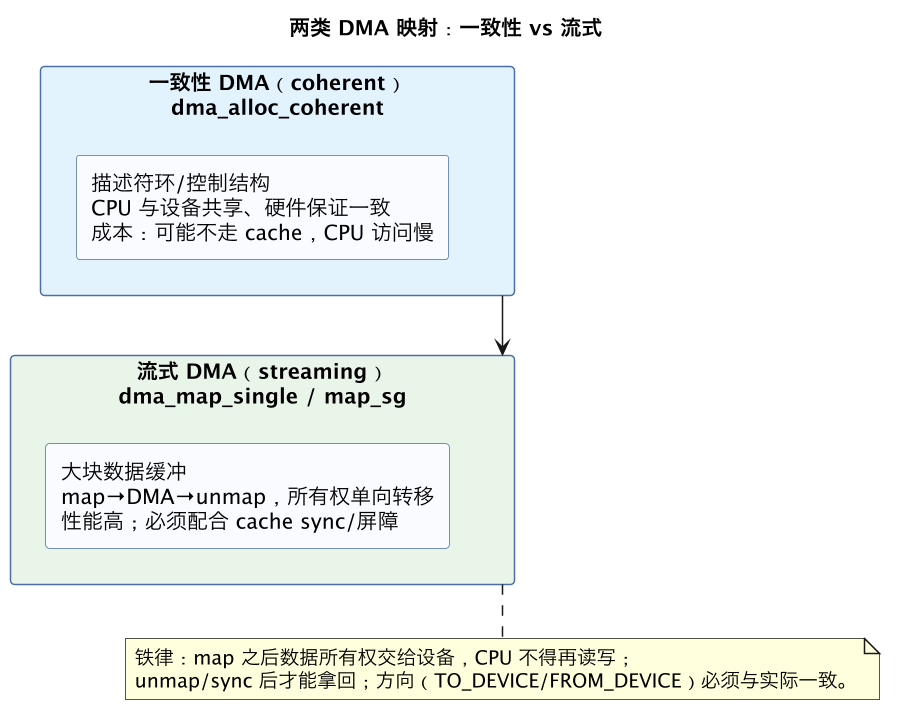
- 一致性
dma_alloc_coherent:非缓存/强序,CPU 与设备立即可见,放描述符环、控制结构。 - 流式
dma_map_single/_sg:按需 pin + 同步,放大数据缓冲;设备访问前后用dma_sync_single_for_device/CPU管缓存所有权。 - IOMMU 把分散物理页映射成设备可见的连续 IOVA,并提供越权访问保护。
四、描述符环的软件纪律
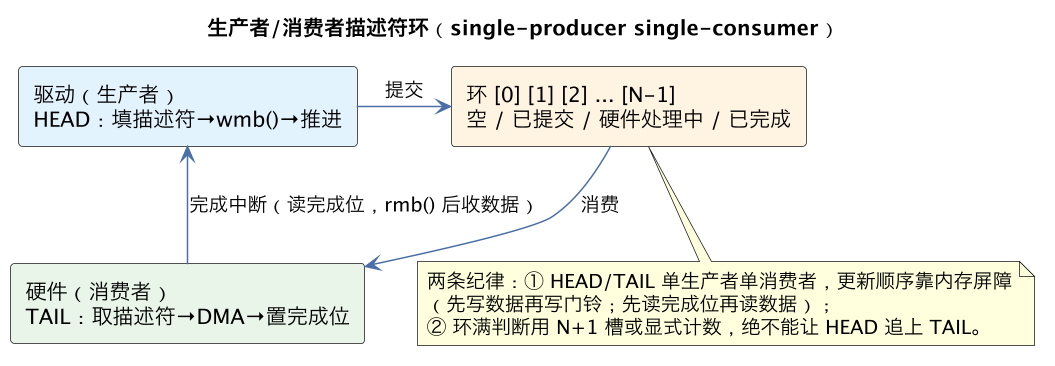
ring[widx].buf = dma_addr;
ring[widx].len = len;
wmb(); // 数据与描述符必须先于门铃可见
ring->widx = widx + 1;
wmb();
writel(DOORBELL, ®s->db); // MMIO 通知硬件- 完成侧:读硬件消费者指针前后配对屏障;中断(MSI-X)与轮询二选一或混合。
- 高频低延迟:用户态 + busy poll + 大页 + 绑核 + isolcpus;省 CPU 用中断/NAPI 混合。
五、常见坑清单
缓存未同步导致"数据偶发是旧的";32/64 位描述符截断;字节序;DMA 跑向未 pin 的页;复位后描述符环状态不一致;MSI-X 未开退回 INTx;VFIO 没开 IOMMU/VT-d;大页未预留导致 mmap 失败。
六、驱动栈的分层解剖:从应用到寄存器的每一层在干什么
要把 FPGA 驱动写对,先要能在脑子里把主机软件栈“切片”。以 Linux 上一块 PCIe FPGA 加速卡为例,一次“应用把数据交给硬件算、再取回结果”的调用,会自上而下穿过若干层:用户态应用调用一套用户态库(SDK/runtime,封装好的 open/ioctl/共享内存 API);进入内核后是字符设备驱动或更专门的平台/PCI 驱动,它负责设备发现、寄存器映射(把 BAR 空间 ioremap 成内核可访问地址)、中断注册、DMA 内存的分配与同步;再往下是 DMA 引擎驱动(可能复用内核 dmaengine 框架,也可能是 FPGA 自研 DMA IP 的专用驱动)、中断控制器、PCIe 子系统和根复合体;物理上则是 TLP 包穿过 PCIe 链路到达 FPGA。每一层都可能丢东西、缓存东西、重排东西,理解数据和控制流究竟在哪一层被如何处理,是定位“软件说发了、硬件没收到”这类跨域 bug 的前提。
控制路径与数据路径在驱动里必须分开设计,这与 FPGA 内部“控制面/数据面分离”是同一个原则的软件映射。控制路径走寄存器:驱动把命令、地址、长度写进 FPGA 的控制寄存器(通常经 MMIO,即内存映射 IO),这类访问每次几十到上百纳秒、强烈有序、不可缓存,量小但要求精确。数据路径走 DMA:硬件在驱动授权下直接读写主存里的数据缓冲区,吞吐极高,但要求缓冲区物理连续或经 IOMMU/SMMU 得到设备可寻址的地址、要求 Cache 一致性被正确处理、要求生命周期严格受控(内存绝不能在硬件还在 DMA 时被释放)。把大量数据用 MMIO 寄存器逐字节拷贝,是新手驱动最常见的性能灾难;反过来,用 DMA 去传递只有几十字节的命令,又会因为描述符设置和缓存同步的开销得不偿失。
驱动里最精巧、也最容易出错的构件是内存映射与寄存器访问的抽象。硬件寄存器在内核里不是普通内存:它可能 side-effectful(读一个 FIFO 数据寄存器会弹出一个元素、写一个中断清除寄存器才有清中断效果)、可能要求严格的访问顺序(先配长度再写启动位,顺序反了硬件会用旧值动作)、可能跨 CPU 架构有不同的内存类型语义。因此寄存器读写必须经过封装好的访问函数(Linux 的 readl/writel、ioread32/iowrite32),它们插入正确的内存屏障、保证访问宽度和顺序,而绝不能为了“快”把寄存器区当普通指针解引用、更不能让编译器把对同一寄存器的多次访问合并优化掉。一份好的 FPGA IP 驱动,寄存器偏移、位域、复位值、访问副作用都用宏或结构体集中描述,与硬件寄存器手册一一对应,这样硬件改位域时驱动的改动点清晰可审计。
DMA 地址是三套地址,必须时刻分清:用户虚拟地址(进程私有的、可换页的指针)、内核虚拟/物理地址、以及总线地址(设备经 IOMMU 或直接看到的地址)。驱动要做的,是把用户传来的缓冲区“钉住”(pin/lock,防止它被换出或移动)、为设备建立 DMA 映射(dma_map_single 一类接口)、得到能写进 FPGA 描述符的总线地址,等硬件完成后再解除映射。在 64 位系统上还要处理设备地址位宽:很多 FPGA DMA IP 早期只支持 32 位地址,而主机内存普遍在 4GB 以上,必须用 DMA 掩码告诉内核,或借助 IOMMU 转换,否则会出现“小内存机器正常、大内存机器偶发坏数”的诡异故障。对这套地址生命周期缺乏敬畏,是 DMA 类疑难杂症(坏数、踩踏、随机 panic)最大的根源。
把这几层看透之后,一个重要的工程判断会浮现:驱动代码的复杂度应当尽量下沉到可复用的库和框架,用户态 API 保持稳定。硬件每改一版 RTL,寄存器/DMA 细节会变,但应用团队不希望每次都改业务代码。成熟团队会把“发现设备、映射、DMA、中断、同步”封装成一层稳定的内核驱动加一层薄薄的用户态 runtime,对应用只暴露“打开设备、提交工作、等待完成、查询状态”几个语义稳定的调用。这样 RTL 迭代时改动被限制在驱动内部,应用和测试可以持续复用,硬件团队也能独立演进——驱动在这个意义上不是“让硬件能跑的附属品”,而是隔离硬件变动、保护软件投资的正式接口层。
七、用户态/内核态边界与零拷贝:性能是怎么一层层漏掉的
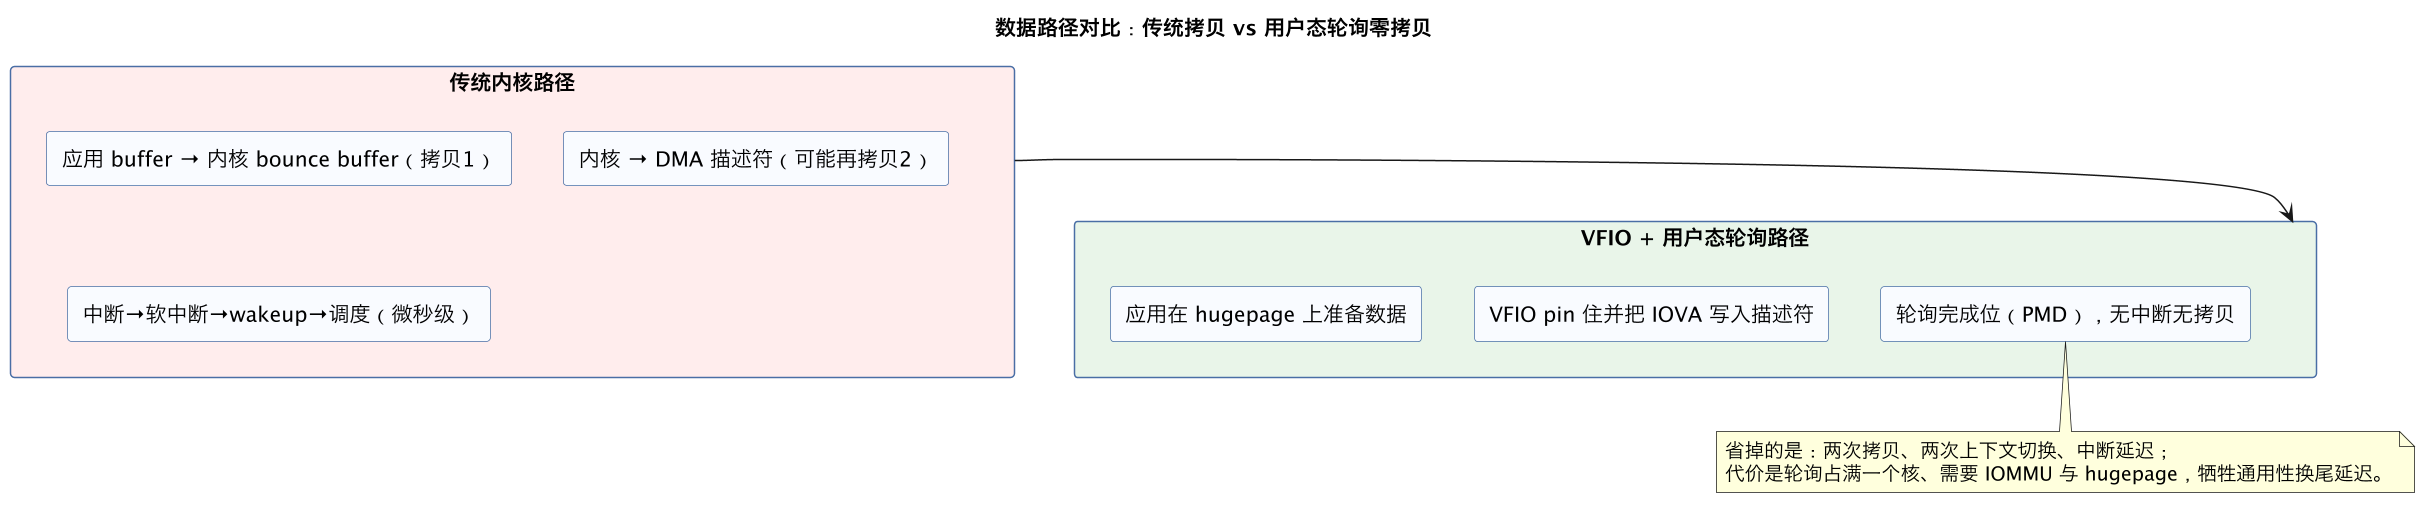
高性能 FPGA 加速(网络、存储、金融)对主机软件栈的核心诉求是低延迟和高吞吐,而操作系统内核边界恰恰是开销最集中的地方。一次传统的 write/read 系统调用,要经历用户态陷入内核、拷贝数据、调度、再返回用户态,每次上下文切换几十到上千纳秒,且会让本可流水线化的数据被同步点打断。理解开销从哪里漏,才能有的放矢地堵。
第一道大漏是数据拷贝。朴素路径里,一份网络报文可能被拷贝多次:网卡 DMA 到内核缓冲、协议栈处理、再拷贝到用户态缓冲;反过来用户数据也可能先拷到内核、再由 DMA 引擎取走。每次拷贝都吃内存带宽和 CPU 周期,在百 G 级流量下完全不可接受。零拷贝(zero-copy) 的思路是让硬件和用户态共享同一批物理页:驱动把用户缓冲区 pin 住并映射给设备,DMA 直接在用户内存上读写,省掉内核中转拷贝。代价是缓冲区管理变复杂(要处理页面不连续、生命周期、地址转换),且把内存安全的责任部分交给了应用,因此通常只对大块、长生命周期、性能关键的缓冲开放,并配合严格的所有权约定。
第二道漏是系统调用与上下文切换。即使数据零拷贝,每包都 ioctl 进内核仍是巨大开销。高性能方案普遍采用 用户态直接访问硬件(kernel bypass):把设备的控制寄存器/门铃和一部分队列映射到用户态,应用通过轮询用户态可见的完成队列(poll mode driver,DPDK 是代表)直接收发描述符,完全绕开内核中断和系统调用。这样延迟可以压到亚微秒且抖动极小,但代价是放弃内核调度的便利、需要独占一个或多个 CPU 核专门轮询(自旋耗能)、安全边界下移到用户态框架。是否值得,取决于业务是否真的处在“每微秒都要争”的区间——很多通用场景用标准内核驱动加中断聚合反而更省资源、更好维护。
第三道漏是中断与轮询的调度策略错配。高速通路用每描述符一次中断会把 CPU 淹没在中断上下文里(中断风暴),吞吐反而下降;纯轮询延迟最低但空载也烧满一个核。成熟驱动按负载自适应:低速率用中断省电省核,速率升高切换到中断聚合(一批完成或超时才中断),极高负载干脆进入轮询模式(如 NAPI 的思路)。FPGA 侧通常也提供中断节制/聚合寄存器(coalescing),由驱动按吞吐/延迟目标配置。中断、聚合、轮询不是三选一的信仰,而是一条随流量连续调节的旋钮,好的驱动会暴露这套参数并给出按场景的推荐值。
第四道漏是Cache 一致性同步和内存屏障的误用。在一致性强的 x86 平台上,DMA 与 CPU 之间往往硬件保持 Cache 一致,但在 ARM、RISC-V 或不带一致性的 FPGA SoC 上,驱动必须显式地在 DMA 前后做缓存同步,同步范围错误(太大浪费、太小漏数据)直接造成性能或正确性问题。内存屏障同理:屏障不足会乱序出错,屏障过多会把性能拖垮,应当只在“配置寄存器→敲门铃”“读取完成位→取数据”这些真正需要顺序的点插入,而不是全局乱加。很多“在我机器上快、换平台就慢/出错”的驱动,病根都在这一层对架构差异的想当然。
第五道漏是队列深度与流水线没有喂满。硬件 DMA 和加速器通常能接受一串排队的描述符、在内部并行/流水处理,但若驱动一次只提交一个描述符就死等完成,硬件会反复“饿肚子—干完—等下一个”,吞吐远低于线速。正确做法是维护足够深的描述符环(ring),让飞行中的请求数(queue depth/outstanding)足以盖住“提交—处理—回写”的往返延迟,使硬件始终有活干;同时用背压(队列满时应用阻塞)防止无限堆积。延迟和吞吐在这里是两个独立目标:低延迟要少排队、请求尽快穿透;高吞吐要深排队、喂满管线。驱动要允许应用按业务选择偏延迟还是偏吞吐,而不是写死一个队列深度。
收尾的判断标准是:任何一层引入的抽象,都要能用一次明确的收益(拷贝数减少、切换减少、队列填满)来证明。性能驱动不是把所有技巧堆满,而是先用 perf/时间戳计数器把一次端到端操作的耗时拆解到各层(拷贝多少、切换多少、等中断多少、DMA 多少),找到占比最大的那一档漏点精准封堵,再复测,避免在只占 2% 的环节上投入 80% 的复杂度。
八、并发、同步与生命周期:驱动里最难证明正确的部分
驱动代码与普通应用最大的区别,是它天然运行在高度并发、且一旦出错就可能整机崩溃或损坏数据的环境里。同一块 FPGA 设备可能被多个进程同时打开,多个 CPU 核可能同时调用驱动、同时触发中断,硬件可能在软件正在拆除资源时仍在做 DMA。正确性的核心是对“共享状态”和“异步事件”的严格管理,而这部分恰恰无法靠“多测几次碰巧没出问题”来保证。
第一组问题是并发访问设备与共享数据结构。多个线程/进程同时往同一个描述符环提交工作,若没有保护,环的头尾指针会竞争错乱、描述符被重复使用或跳过。需要用锁(自旋锁用于极短的、不能睡眠的临界区,互斥锁用于可能阻塞的操作)或无锁环形队列(单生产者单消费者环可以做到无锁,靠内存序保证)来串行化入队/出队。但锁也不能乱加:在持锁期间等待硬件完成、或在原子上下文里调用可能睡眠的函数,会造成死锁或内核告警。设计上要尽量缩小临界区——只在修改环指针和元数据时持锁,把耗时的内存拷贝和 DMA 设置放到锁外。
第二组问题是中断与进程上下文之间的竞态。典型的同步模式是:进程提交工作后在一个等待队列上睡眠,硬件完成中断到来时,中断处理程序(上半部)只做最少工作(确认中断、把完成描述符摘下来),再唤醒等待队列或调度下半部(tasklet/workqueue/threaded irq)做耗时处理。这里到处是竞态窗口:进程刚要睡、中断恰好到来;多个完成事件合并成一次唤醒;虚假唤醒(spurious wakeup)。必须用标准的“检查条件—若未完成则可中断等待—被唤醒后重新检查”循环,而不是睡死等一次唤醒。还要处理设备在等待中被复位/关闭的情况,等待必须能被信号或拆除流程打断,否则进程会永远挂在内核里。
第三组,也是最危险的一组,是DMA 缓冲区与硬件的生命周期。规则极其刚性:一块内存一旦被映射给硬件做 DMA,在硬件明确报完成之前,软件绝不能释放它、不能解除映射、不能让它所在的进程退出(否则物理页被回收另作他用,硬件会把数据写进无辜的内存——这就是经典的“DMA 野指针踩踏”,症状是随机、难以复现的数据损坏甚至全盘崩溃)。因此缓冲区的所有权状态机要清晰:空闲→已提交给硬件(软件不可碰)→硬件完成(经同步后软件可回收)。关闭设备或进程异常退出(release/remove/异常路径)时,驱动必须先停住硬件、排空或等待所有在途 DMA、解除全部映射,然后才能释放资源。这条拆除路径最容易被忽略(因为正常流程很少走到),却是生产环境中文件描述符泄漏、设备 reset、热拔插时出大事故的地方。
第四组是寄存器访问与硬件状态机的跨域同步。软件对硬件的“命令—状态”交互本质是两个异步状态机用共享寄存器通信,必须假设硬件任何时候都可能正忙、可能报错、可能不按软件预期响应。每一次“写启动位→轮询完成位”都要有超时(无超时的轮询在硬件挂死时会永久锁死内核);每一个状态位都要按硬件手册规定的方式读取和清除(很多状态位写 1 清零,读不清除,写错语义会漏掉事件);中断使能位、软复位位、错误状态位的初始化顺序要在“冷启动、热复位、错误恢复”三种情形下都成立。把这些交互集中成几个有明确前置/后置条件的辅助函数(如 hw_reset()、wait_idle_timeout()),比在驱动各处散落裸轮询可靠得多。
第五组是可重入、错误处理与资源回收的纪律。内核代码里每一次内存分配、映射、注册都可能失败,驱动必须在任意一步失败时,把此前已申请的资源按相反顺序干净释放(goto 错误处理标签是内核惯例),否则长时间运行会泄漏 DMA 内存、中断号、设备号。设备移除(PCI 热拔、驱动卸载)路径要与正在进行的 IO 正确互斥,保证“不会有任何代码在设备资源释放后还去敲寄存器”。这类代码写起来繁琐、平时难触发,但它决定了一块加速卡能不能在服务器里连续运行三年、经历无数次 reset 和固件升级而不留下隐患。
衡量这部分质量的,不是功能跑通时的表现,而是压力和异常下的行为:满队列并发压测数小时不乱序不丢包;在高负载时反复 kill 应用、reset 设备、卸载重载驱动不泄漏不死锁;拔掉线缆、掐断供电、灌入非法描述符都能返回明确错误而不是 panic。把这些“破坏日”做成固定的压力测试场景(见 专家 39),驱动的并发正确性才算是被验证过,而不是“我这边试了试没问题”。
九、从裸机到生产驱动:方案光谱与团队能力匹配
同一个“主机要驱动 FPGA”的需求,可以用复杂度相差上千倍的方案实现,选错档位会造成两种相反的失败:小团队为并不复杂的设备硬套完整内核框架,陷入维护泥潭;或者产品级设备长期停留在裸机轮询的原型代码上,撑不住多用户、高性能和长期运维。关键是按设备的使用场景、性能目标、部署环境和团队能力,选择光谱上合适的位置,并预留向上演进的路径。
光谱最简单的一端是裸机/寄存器直驱:在单片机或无操作系统环境里,直接把控制寄存器映射成指针,轮询状态位,无中断、无 DMA 或用最简单的 DMA。这种方案代码量小、行为完全可见、延迟确定,适合 bring-up 早期、极简单的控制设备、或安全关键且要求确定性的嵌入式场景。它的边界也很清楚:不支持多用户、没有任何资源隔离、性能靠轮询烧 CPU、无法复用操作系统的网络/存储栈。很多硬件团队的第一版“能跑”演示都在这一档,问题是常有人把这一档代码直接带进了量产服务器场景。
第二档是轻量字符设备 + ioctl + 中断:在 Linux 下写一个字符设备,应用通过 open/read/write/ioctl 与驱动交互,控制走寄存器、数据可用 DMA,中断通知完成。这是大多数 FPGA 控制类/中等吞吐设备的“甜点区”——能进 Linux 的设备模型、支持多进程 open(内部串行化)、有标准的权限管理(/dev 节点权限)、可用标准工具和脚本运维,复杂度也可控。它不追求 kernel bypass 的极致延迟,但对绝大多数仪器、采集卡、控制设备、中速加速器完全够用,且团队学习成本合理。
第三档是融入内核框架的标准驱动:网络类设备接入 net_device/ndo、存储类接入 block/SCSI、DMA 接入 dmaengine、内存/加速器接入合适的子系统,让 FPGA 设备表现成一个标准网卡、块设备或 DMA 通道,直接复用内核协议栈和上层生态。优点是与系统集成度最高、可被标准工具管理、不需要自定义用户态 API;代价是要吃透对应子系统的约定和回调模型、调试更绕。判断标准很直接:如果你的 FPGA 在逻辑上就是“一块特殊网卡/特殊 SSD”,那就把它做成标准网卡/块设备,而不是发明一套私有 ioctl 让应用重新实现 TCP 栈。复用内核栈几乎总是长期更优,只有当内核栈的开销或模型确实挡不住性能目标时才另起炉灶。
第四档是高性能 kernel bypass 框架:DPDK(网络)、SPDK(存储)、自研用户态轮询驱动,把队列和门铃映射到用户态,绑核轮询、零拷贝、用户态 DMA。这一档换来亚微秒延迟和接近线速的吞吐,是高频交易、超大规模网络/存储卸载的必选项;但代价是需要专门的 CPU 核、用户态框架的运维复杂度、与内核生态的割裂、以及对内存安全和隔离更重的责任。它不是“更高级的默认选择”,而是只有在量化分析证明内核路径确实是瓶颈、且团队有能力长期维护用户态栈时才应采用。
跨档演进时,有几条降低返工的设计原则。其一,无论哪一档,寄存器定义、DMA 描述符格式、命令协议都以“硬件无关的描述层”集中定义,使上层策略与下层寄存器细节解耦,这样从裸机迁移到 Linux、从 ioctl 迁移到标准子系统时,协议层和测试可以复用。其二,用户态 API 从第一天就保持语义稳定、最小化(提交/完成/查询/复位),底层档位变化不影响应用。其三,尽早定义“软件可见的设备行为契约”:完成顺序、错误如何上报、复位后哪些状态丢失、内存一致性要求,让驱动各档位都实现同一契约,测试可以在契约层面统一编写。
最后要诚实评估团队能力与维护成本:内核驱动要求开发者理解并发、内存模型、子系统约定并接受上游社区的代码标准(若要合入主线);用户态高性能栈则要求对 PCIe、缓存、轮询调度有深入理解。把方案复杂度压到“团队能在产品整个生命周期内独立调试和维护”的水平,比在原型阶段追求最先进架构更重要。一个朴素但正确、可观测、可压测的中档驱动,长期价值远超一个没人敢改的炫技驱动。
十、常见坑对照表与 bring-up 现场指南
下表汇总主机侧驱动 FPGA 时最高频的坑,按“现象—根因—正解”组织,可直接用于评审与 bring-up 现场排查。
寄存器写了没反应:根因多为地址/偏移错(设备树或 BAR 偏移与硬件不一致)、访问宽度不对(硬件是 32 位寄存器却用了 8/16 位访问)、访问被编译器/缓存优化重排。正解是核对硬件地址映射与设备树、严格用 readl/writel、在“配置→启动”之间加必要屏障,bring-up 第一步先做一组寄存器写读回与版本号读取(呼应 20 比特流烧录与四方版本一致 manifest/门禁 的版本寄存器思想)确认通路。
DMA 偶发坏数据:典型根因有缓冲区未 pin 住被换页/移动、给硬件的是虚拟地址而非总线地址、32 位设备地址掩码在大内存机器上越界、缓存未同步、字节序或尾部位宽处理错。正解是走标准 DMA API(map/unmap)、正确设置 dma_mask、在非一致平台显式同步、并先用小而确定的图案做端到端 DMA 环回(已知数据发出去收回来逐字节比对)再上真实业务。
性能远低于预期:按漏点逐项查——是不是在用 MMIO 搬大数据(应改 DMA)、每包一次中断(应聚合/轮询)、队列深度为 1 没喂满流水线、上下文切换/拷贝过多(考虑零拷贝/kernel bypass)、屏障加太多。正解是先测量分层耗时再针对性优化,别凭直觉。
高负载下随机死锁/panic:多为生命周期和竞态问题——硬件仍在 DMA 时缓冲被释放、持锁等待硬件、中断与等待唤醒竞争、无超时轮询撞上硬件挂死。正解是严格的缓冲所有权状态机、锁内不睡眠不等硬件、标准等待循环带超时、所有硬件交互都有超时和错误分支。
复位/拔板/重载驱动后资源泄漏或挂死:拆除路径未排空在途 DMA、未释放中断/映射/设备号、等待中的进程没被唤醒。正解是实现完整的 remove/error 路径,先停硬件、排空 DMA、唤醒并拒绝新请求、再逆序释放,并把“满载时反复 reset/卸载”做成压测。
跨平台行为不一致(x86 正常、ARM/RISC-V 出错或变慢):内存序和缓存一致性差异、对端序想当然、对齐要求不同。正解是用标准 IO 访问器和 DMA API、显式屏障与同步,不依赖某一架构的强一致默认。
bring-up 现场推荐顺序:①电源/链路先通——lspci 能看到设备、Vendor/Device ID 正确、BAR 分配正常;②只读寄存器——版本/状态寄存器读值合理,证明映射和访问宽度;③写读回——挑可读写且无副作用的 scratch 寄存器验证写通路与顺序;④单次寄存器命令——触发一个最小的、可观测的硬件动作(点亮 LED、回环一个字符);⑤单描述符 DMA 环回——已知图案端到端比对,先小后大;⑥中断——从轮询完成切换到中断完成,验证中断到来与清除语义;⑦描述符环与多请求队列,验证顺序与背压;⑧并发/异常压测——多进程、满载、reset、拔板、非法输入;⑨性能调优——测量分层、按漏点加 DMA/聚合/零拷贝;⑩长期稳定性与运维——版本可读、错误可计数、日志可定位、固件/比特流可升级可追溯。严格按这个阶梯推进,每一级稳定了再上一级,能避免“功能、性能、稳定性问题搅在一起无从下手”的典型困境。
总结
主机侧 FPGA = BAR 寄存器 + DMA 缓冲 + 门铃 + 中断:原型用 UIO、产品/云用 VFIO+IOMMU、标准产品写平台驱动;数据用 coherent/流式 DMA 映射,命令走共享描述符环,低延迟靠用户态轮询+大页+绑核,同步纪律靠内存屏障。