AHB 突发传输:HBURST 的 INCR 递增、WRAP 回卷与 1KB 边界规则
更新时间:2026-09-25。本文是「集成电路大类 · 芯片设计 · 片上总线」序列的一篇中篇。在 AHB-Lite 流水线与 HREADY 一篇里我们已经知道,AHB 靠地址相与数据相错一拍获得每拍一笔的吞吐;但如果 DMA 搬运一块 cache line 或一帧数据,每一拍都重新发一笔独立访问,仲裁和译码的开销仍然存在。AHB 突发传输(burst)解决的就是这个问题:主机声明一次意图,之后地址由协议自动逐拍推进。高速侧对应机制可对照 AXI4 的 ARBURST/AWBURST。
本文要回答的问题
- HBURST 三个比特的八种编码分别是什么,定长与不定长怎么区分?
- INCR 的地址如何逐拍递增,不定长 INCR 靠什么结束?
- WRAP4/8/16 的回卷边界怎么算,为什么 cache line 填充偏爱 WRAP?
- 为什么 burst 不得跨越 1KB 边界,谁来负责拆分?
- HTRANS 的 SEQ 与 BUSY 在 burst 中如何使用,BUSY 拍地址是什么值?
一、突发传输是什么:一次声明,多拍流水
burst 是一组在时间上连续、地址上有规律的传输。主机只在第一拍给出起始地址(HADDR)和突发类型(HBURST),后续各拍的地址按 HSIZE(每拍字节数,2^HSIZE)和 HBURST 自动推进,不再需要重新仲裁与译码。对总线来说,这带来三个直接好处:仲裁器一次授权覆盖整组传输;从机知道后面还有几拍,可以提前打开灵敏放大器或预取;数据相在无等待态时每拍收/发一拍数据,总线带宽被吃满。

图里的关键是「意图一次给全」:HBURST 与 HSIZE 在整个 burst 期间必须保持不变,从机据此预知总拍数和地址轨迹。如果中途改变 HBURST,或在 SEQ 拍之间插入 NONSEQ,从机的地址推进就会失步——这在协议上等同于提前终止当前 burst。
还要先交代 HSIZE 的两个隐含约束。其一,每拍地址必须与传输大小自然对齐:4 字节拍的 HADDR 低两比特为 0,半字拍最低比特为 0;AHB 不支持非对齐传输,非对齐访问要由软件或主机拆开。其二,HSIZE 决定的是每拍的有效字节数,而不是总线物理位宽——32 位总线上可以跑字节拍,此时 HWDATA 上有效字节的位置由地址低两比特选择,从机借助 HADDR 低位而不是额外的字节使能信号来判断。burst 地址推进量同样取自 HSIZE,因此 HSIZE 是整组 burst 地址轨迹的真正「步长发生器」。
对写 burst 还有一个数据供数细节:HWDATA 比 HADDR 晚一拍,主机内部必须有一小块缓冲把写数据按拍对齐。读 burst 则反过来,主机收到 HRDATA 时要记得它对应的是上一拍的地址,回写目的缓冲(比如 DMA 的 FIFO)的写指针也要延迟一拍。很多 burst 实现的数据错乱 bug 不在地址推进,而在这一级地址与数据的拍差没对齐。
二、HBURST 编码:八种突发类型
HBURST 是三个比特,编码全部八种类型,规约定义如下:
| HBURST | 编码 | 拍数 | 地址行为 | 典型用途 |
|---|---|---|---|---|
| SINGLE | 000 | 1 | 单拍,无后续 | 寄存器访问 |
| INCR | 001 | 不定 | 连续递增,长度由主机决定 | DMA 长度运行时才知 |
| WRAP4 | 010 | 4 | 块内递增,到边界回卷 | cache line 填充 |
| INCR4 | 011 | 4 | 连续递增 4 拍 | 定长 DMA |
| WRAP8 | 100 | 8 | 块内递增,到边界回卷 | 较宽 cache line |
| INCR8 | 101 | 8 | 连续递增 8 拍 | 定长 DMA |
| WRAP16 | 110 | 16 | 块内递增,到边界回卷 | 宽突发内存 |
| INCR16 | 111 | 16 | 连续递增 16 拍 | 大块顺序搬运 |
规律很清楚:数字后缀 4/8/16 是定长 burst 的拍数,INCRx 与 WRAPx 的区别只在地址是否回卷;不带数字的 INCR 是唯一的不定长类型。主机在 burst 第一拍必须把 HTRANS 置为 NONSEQ,后续各拍置 SEQ——NONSEQ 就是在告诉从机「新的地址轨迹从这里开始」,SEQ 则表示「沿当前轨迹推进一拍」。SINGLE 传输的 HTRANS 也是 NONSEQ。
三、INCR:连续递增与不定长的终止
INCR 类 burst 的地址推进最简单:每拍地址 = 上一拍地址 + 2^HSIZE。以 HSIZE=2(每拍 4 字节)为例,INCR4 从 0x20 开始,四拍地址依次为 0x20、0x24、0x28、0x2C,一拍不差。定长的 INCR4/8/16 拍数固定,从机可以自行倒数,最后一拍之后主机若还要传,必须重新以 NONSEQ 开启一组新 burst。
不定长 INCR 特殊在它的长度不在总线上声明:主机可以一直用 SEQ 把地址递增下去,直到某一拍把 HTRANS 换成 IDLE(结束)或 NONSEQ(另起一组)。对从机而言,「HTRANS 不再是 SEQ」就是 INCR 的终止信号。这给了 DMA 一类主机很大的灵活性——描述符里的数据长度运行时才知道时,用定长类型反而要拆碎,用 INCR 则一口气传完。代价是从机无法预知总拍数,不能做依赖总长度的预分配。
看一个字节拍的例子可以避免步长错觉:HSIZE=0(每拍 1 字节)时,INCR8 从 0x10 起,八拍地址是 0x10 到 0x17,每拍只加 1,共 8 字节,而不是字拍直觉里的 0x10、0x14、0x18……同理,HSIZE=1(半字)时步长是 2。RTL 里推荐的写法是把步长写成 8'(1 << HSIZE),让综合器去展开,而不是在 case 语句里写死。另外,定长 burst 的最后一拍有个合法细节:最后一个 SEQ 之后,下一拍允许直接出现 NONSEQ(两组背靠背,中间不插 IDLE),这正是高吞吐 DMA 连续搬运时的常态,从机必须能在同一拍完成上一组收尾并接受新组起点。
下面是 INCR4 的逐拍波形(无等待态),HADDR 相对 HWDATA/HRDATA 提前一拍,这正是 AHB 地址/数据两级流水的体现:
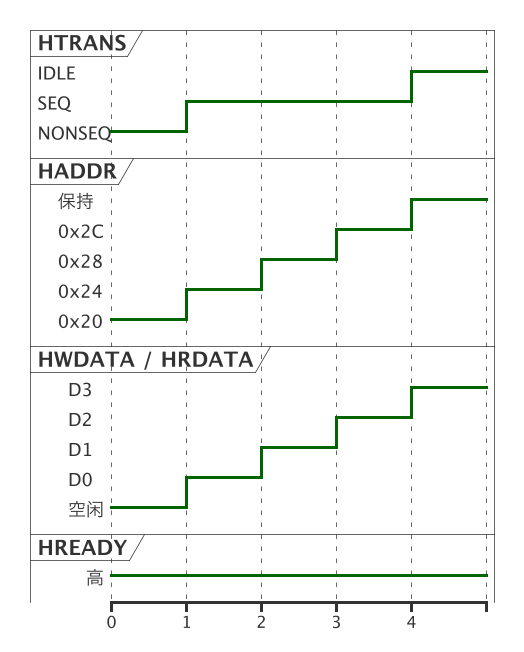
顺着波形读:第 0 拍是第一笔的地址相,第 1 拍 D0 在数据相上出现的同时,第二笔地址 0x24 已经在地址相上了,地址与数据重叠推进;到第 4 拍最后一个数据 D3 完成时,HTRANS 已变成 IDLE,整组 INCR4 共占五个周期但传了四拍数据。若从机在某拍拉低 HREADY,数据相被拉长,地址相也同步停住,HTRANS 与 HADDR 全部保持,恢复后从断点继续——地址推进只在 HREADY 为高时发生。
四、WRAP:回卷边界的计算
WRAP(回卷)burst 的地址在一个对齐块内部递增,到达块上边界后不是继续往前走,而是回卷到块的起始地址。两个量决定一切:
- 每拍字节数 = 2^HSIZE;
- 块大小 = 拍数(4/8/16)× 每拍字节数,块边界按块大小对齐。
以 HSIZE=2(4 字节)、WRAP4 为例,块大小是 16 字节,地址低 4 比特在块内。若起始地址为 0x34,四拍地址依次为 0x34、0x38、0x3C、0x30——第四拍没有去 0x40,而是回到了所在 16 字节块的起点 0x30。换句话说,WRAP 的地址序列就是「起始地址沿递增方向绕对齐块一圈」,起始地址本身可以不对齐,这正是它与 INCR 唯一的区别。

换个起始地址再验一次:同样 WRAP4、4 字节拍,若从 0x2C 起,序列是 0x2C、0x30、0x34、0x38——回卷点提前到第一拍之后出现,因为 0x2C 所在块的起点是 0x20,跨过 0x2F 即回卷。可见回卷不总在最后一拍发生,它只取决于起始地址在块内的位置,RTL 实现不能假设回卷点固定在末尾。
为什么需要这种看似古怪的顺序?答案是 cache。处理器的 cache line 通常是 4、8 或 16 个字,且按 line 大小对齐;当 cache miss 时,CPU 往往最急需的是「触发 miss 的那个字」,而不是 line 的第一个字。WRAP burst 允许主机先传关键字(critical word first),从关键地址开始向高地址传,绕到块首补齐剩余部分。CPU 拿到关键字即可恢复执行,剩余字随后流入 cache,这就是关键字优先(critical-word-first)填充。内存控制器也能利用 WRAP 保证整组访问落在同一行内,不触发额外的行激活。
五、1KB 边界:burst 不得跨越
AHB 规约有一条硬规则:任何 burst 都不得跨越 1KB 地址边界。 所谓跨越,是指同一组 burst 的地址轨迹(含 WRAP 回卷前的递增路径)落到两个不同的 1KB 区间。例如 HSIZE=2、INCR16 从 0x3F0 开始:总跨度 64 字节,最后一拍地址会到 0x42C,越过 0x400 这个 1KB 边界——这组 burst 是非法的。
根源在译码结构:AHB 从机的最小译码空间约定为 1KB,地址高比特译码选择从机、低 10 比特在从机内寻址。如果一组 burst 跨过 1KB 边界,后半段实际属于另一个从机的地址区,但 HSEL 在 burst 开始时已经锁定,SEQ 拍不会重新译码,于是会出现「选中的从机收到不属于它的地址」的错乱。规则因此把责任交给主机:发起 burst 前检查剩余空间,可能越界就拆成两组,中间用一次 NONSEQ 衔接。注意 WRAP 天然安全——它的全部地址都落在一个对齐块内,块大小最大为 16×每拍字节,远小于 1KB。

工程上的判据很简单:起始地址的低 10 比特 + 总字节数 不得超过 1024;超过就在 (0x400 - 当前地址低 10 位) 处截断。沿用前面的例子,0x3F0 起、64 字节的 INCR16,低 10 比特是 0x3F0,加 64 得 1072,超过 1024,于是第一组最多传 4 拍到 0x3FC,再从 0x400 以 NONSEQ 起第二组 INCR4 补齐。DMA 引擎的地址生成逻辑里一般有一个专门的边界比较器,命中时强制插入 NONSEQ。不定长 INCR 更要小心:长度未知意味着每一拍都可能是越界点,比较器必须逐拍检查「下一地址的高位是否与当前从机一致」,而不能只在 burst 发起时检查一次。
自己写 RTL 时这条规则没有硬件会替你兜底——从机不会报错,它只会收到错误地址,问题以「偶发数据 corruption」的形式在系统测试阶段才暴露,定位成本极高。多主系统里还要补一条:1KB 拆分产生的两组 burst 之间如果被仲裁器切走主人,协议上完全合法,主机重新获得授权后照常以 NONSEQ 续传即可;不要为了让两组「连续」而把整段传输锁起来,那样会把 1KB 规则和 HMASTLOCK 锁定传输 搅在一起,反而牺牲实时性。
六、SEQ 与 BUSY:burst 中途的节流
burst 进行到一半,主机偶尔会有一拍供不上数据(比如内部 FIFO 暂时为空),这时用 HTRANS=BUSY 而不是结束传输。BUSY 的语义是:「burst 还在继续,但本拍请跳过,不要推进。」它的使用有严格约束:
- BUSY 只能出现在 burst 中途,第一拍和最后一拍之后都不能用;
- BUSY 拍 HADDR 必须驱动为下一拍将要访问的地址并保持,HBURST/HSIZE/HWRITE 等控制不变;
- BUSY 期间数据相不发生,从机对该地址不采样;
- BUSY 结束后主机用 SEQ 继续,地址从 BUSY 拍所呈现的地址接着走;对定长 burst,拍数计数不把 BUSY 计入。
注意 BUSY 是主机侧的节流,而从机拉低 HREADY 是反压,两者方向相反、可叠加:BUSY 拍里从机照样可以拉 HREADY,主机必须继续保持地址。另外 BUSY 不改变 WRAP 的回卷轨迹——BUSY 拍呈现的「下一地址」与没有 BUSY 时该位置上的地址完全一致,回卷计算不受影响。
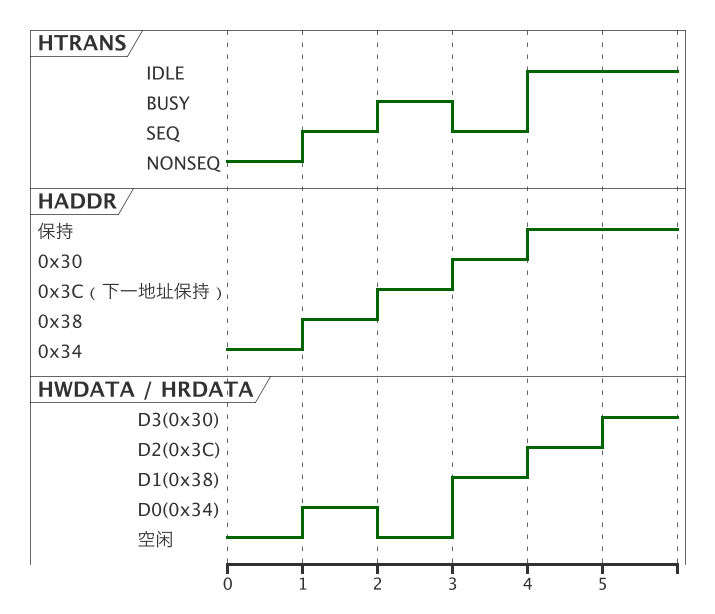
这是一个 WRAP4 中间插了一拍 BUSY 的波形:BUSY 拍 HADDR 稳定呈现 0x3C,数据相空缺;恢复后第一拍传 0x3C 的数据,地址则推进到回卷点 0x30,最终四拍数据一个不少,只是整组 burst 被拉长了一个周期。
七、常见的坑与验证要点
- SEQ 拍地址推进错位:推进量必须是 2^HSIZE 而非固定 4 字节;HSIZE=0 时每拍只加 1。RTL 里建议用移位而非硬编码加法。
- WRAP 掩模算错:回卷掩模 = 块大小减 1,块大小是拍数乘每拍字节,不是拍数乘 4。HSIZE 变化后仍正确才算过。
- 1KB 边界只检查起点:要检查的是整组轨迹,INCR16 从边界附近开始最容易被忽略;不定长 INCR 也可能在中途越过,主机需在每拍比较。
- BUSY 拍地址给错:给成当前地址或悬空 X 都会让从机失步;必须保持下一地址,且 BUSY 不能出现在 burst 首尾。
- 中途改 HBURST/HSIZE:这些信号必须在整组 burst 内恒定,变化即等于结束旧组、需要 NONSEQ 重新开始。
- ERROR 后继续 SEQ:burst 中从机报两拍 ERROR 后,主机应终止该 burst,不能假装没看见继续推进。
- 把 BUSY 计入定长计数:INCR4 必须凑满四个数据拍,BUSY 只延长时间、不消耗名额。
验证这类时序,SVA 是最顺手的工具,建议至少覆盖这些性质:NONSEQ 之后若 HBURST 非 SINGLE,后续 HTRANS 在 IDLE/NONSEQ 前必须为 SEQ 或 BUSY;SEQ 拍地址相对上一有效拍按 2^HSIZE 推进,越过块边界时按 WRAP 回卷;任意 burst 的地址轨迹不得跨越 1KB 边界;BUSY 期间地址与控制保持稳定。方法与环境搭建可参考 SVA bind 与覆盖收集 和 AMBA/AXI UVM 环境,仲裁联动则结合 round-robin 公平性 一起测。
这一篇在知识体系里的位置
AHB 两拍流水线与 HREADY/HRESP 基础见 AHB-Lite 流水线与拆分;多主环境下 burst 的并行与仲裁见 AHB-Lite 多层总线矩阵;burst 与锁定的组合见 AHB Locked 锁定传输;高速侧的定长/回卷突发见 AXI4 完整协议;为什么 WRAP 服务于 cache 可结合 存储器推断与 SRAM 理解。
总结
AHB 突发传输用三比特 HBURST 编码 SINGLE、不定长 INCR、定长 INCR4/8/16 与回卷 WRAP4/8/16:INCR 让地址每拍按 2^HSIZE 递增,不定长 INCR 靠 HTRANS 离开 SEQ 结束;WRAP 在按「拍数乘每拍字节」对齐的块内递增、到边界回卷到块首,天然支持 cache line 的关键字优先填充;任何 burst 的地址轨迹都不得跨越 1KB 边界,主机必须自行检查并在边界前以 NONSEQ 拆成两组;HTRANS 在首拍用 NONSEQ、其后用 SEQ,主机供不上数时可在中途插 BUSY 并保持下一地址,BUSY 只延长时间不消耗拍数——地址推进算错、回卷掩模漏乘 HSIZE、1KB 只查起点和 BUSY 地址给错,是 RTL 实现与 SVA 验证中最常见的四类 bug。