FPGA 进阶 27:FIR 滤波器与 FFT 实现——结构、流水、资源估算与 IP 复用
本文是
fpga/进阶层第 31 篇。定点 DSP 最经典的两个落地就是 FIR 滤波器和 FFT。这篇讲实现结构、速度-资源权衡,以及为什么 FFT 工程上几乎都用 IP。乘加硬件靠 DSP48、位宽溢出靠定点那篇。
本文要回答的问题
- FIR 的直接型/转置型/时分复用怎么权衡?
- FIR 位宽怎么定、怎么映射 DSP48?对称系数怎么省乘法器?
- FFT 蝶形/旋转因子/位反转是什么?streaming 和 burst 差在哪?
- 为什么 FFT 基本用 IP?工程师要配什么?
- DSP/BRAM 资源怎么估算?
一、FIR:抽头延迟线 + 乘累加
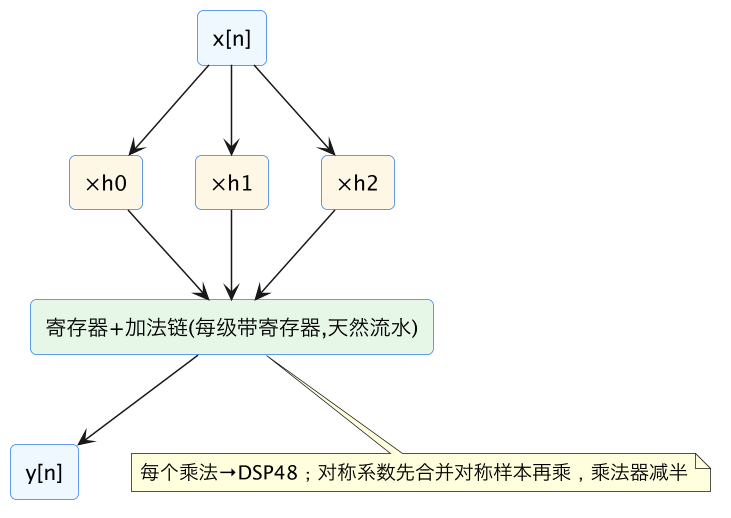
FIR 输出 y[n] = Σ h[k]·x[n-k]:移位寄存器存历史样本(抽头延迟线),每个样本乘系数后累加。
| 结构 | DSP/资源 | 吞吐 | 适用 |
|---|---|---|---|
| 全并行直接型 | N 个乘法器、加法树 | 1 样本/周期,最快 | 高采样率、资源够 |
| 转置型 | N 个乘法器、加法带寄存器 | 1 样本/周期、fmax 高 | FPGA 常用,流水好 |
| 串行/时分复用 | 1~少量 DSP 多周期算 | 1 样本/复用周期 | 采样率低、资源紧 |
| 对称系数 FIR | 乘法器减半 | 同并行 | 线性相位 FIR |
位宽:16bit 样本 × 16bit 系数 = 32bit 乘积,N 个累加再加 ⌈log2N⌉ 保护位;中间保宽、最后截位/舍位 + 饱和(见定点 DSP)。乘加尽量推断成 DSP48 有符号乘加级联,别用 LUT 拼。也可直接用 Xilinx FIR Compiler IP(选系数、结构、并行度,自动量化/流水/映射)。
二、FFT:蝶形分治 + 旋转因子
直接 DFT 是 O(N²);FFT 用蝶形运算分治降到 O(N log N):
- 基-2 蝶形:每级把两个复数按旋转因子组合,共 log2(N) 级;
- 旋转因子 twiddle factor:N/2 组复数系数
e^(-j2πk/N),存 ROM/BRAM 或用 CORDIC 实时算; - 位反转(bit-reverse)重排:输入或输出要按位反转序排列;
- 缩放防溢出:定点每级蝶形可能翻倍,需调度右移;**块浮点(block float)**一帧共用一个指数,兼顾动态范围和硬件简单。
实现结构(Xilinx FFT IP):
| 结构 | 吞吐 | 资源 | 适用 |
|---|---|---|---|
| Streaming(流水线流式) | 高、数据连续流入 | DSP/BRAM 多 | 实时连续信号流 |
| Burst(突发分块) | 低、一帧帧算 | 省资源 | 间歇数据、资源紧 |
| 定点 / 块浮点 | — | 块浮点动态范围更好 | 按需选 |
接口是 AXI4-Stream(数据 + 配置 + tlast 帧边界),配缩放调度、帧同步,前后接窗函数/取模/FIFO。
三、为什么 FFT 基本用 IP
蝶形 + 旋转因子 + 位反转 + 多级调度手写极易错、验证量大;Xilinx FFT IP 把这些做好,工程师的工作变成:选结构/位宽/长度、配 AXI-Stream 帧与缩放、对接前后级、用浮点参考模型做比特级比对。FIR 结构简单可手写也可用 FIR Compiler;FFT 几乎一律用 IP。
四、资源估算
- FIR:全并行 ≈ 抽头数 N 个 DSP48(对称系数减半);时分复用 DSP ≈ N / 复用周期数;
- FFT:DSP/BRAM 随变换长度 N、结构(streaming 多/burst 少)、位宽、块浮点变化——旋转因子和重排缓存主要吃 BRAM;早期查 IP 手册 resource 表插值,精确数以综合后 utilization 报告为准。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 乘法用 LUT 拼 | 资源爆、频率低 | 推断 DSP48 有符号乘加 |
| 累加不加保护位 | 溢出回绕 | 加 log2N 位、输出饱和 |
| FIR 全并行但采样率很低 | 白浪费 DSP | 时分复用 |
| 对称 FIR 没合并样本 | 乘法器多用一倍 | 对称样本先加再乘 |
| 手写 FFT 蝶形/位反转 | 易错、验证量大 | 用 Xilinx FFT IP |
| FFT 不做缩放调度 | 中间级溢出 | 定点右移/块浮点 |
| AXI-Stream 没给 tlast | IP 帧边界错 | 正确给 tlast/帧同步 |
| 拍脑袋估资源 | 选型偏差 | 配好 IP 看 utilization 报告 |
相关与延伸
前置/配套:定点 DSP 设计(Q 格式/溢出/截位)、DSP48 与算术(乘加级联)、流水线与资源优化、BRAM 存储(旋转因子 ROM/重排缓存)、AXI4-Stream(FFT IP 接口)。 视频图像流水线见 #32;HLS 实现 DSP 见 #36/#37。
一句话总结
FIR 输出 y[n]=Σh[k]·x[n-k],是抽头延迟线+乘累加:全并行直接型最快最费、转置型把寄存器插在加法路径天然流水 fmax 高(FPGA 常用)、时分复用省 DSP 但吞吐按复用比例降,对称系数 FIR 先合并对称样本再乘可省一半乘法器;乘加映射 DSP48 级联,乘积 2N 位、累加加 log2N 保护位、最后截位+饱和,或直接用 FIR Compiler IP。FFT 用蝶形分治把 O(N²) 降到 O(N log N),涉及旋转因子(ROM/CORDIC,吃 BRAM)、位反转重排、多级缩放防溢出(定点/块浮点)——结构分 streaming(高吞吐费资源)和 burst(省资源分块算),接口走 AXI4-Stream;因蝶形/排序复杂,工程上几乎都用 Xilinx FFT IP,工程师负责配结构/位宽/缩放/帧并用参考模型比对。资源估算:FIR≈N 个 DSP(复用则除复用周期),FFT 按 N/结构查 IP 手册、以综合 utilization 为准。