金属层 ECO:冻结硅片上的 metal-only 改版、spare cell 预置与逻辑映射全流程
流片后或掩模已投产后发现致命 bug,是全流程里最贵的时刻之一。pre-mask 阶段还可以靠增量综合随便改逻辑(见 网表交付、门级仿真与 ECO),而一旦进入 post-mask,唯一经济的手段就是金属层 ECO(metal-only ECO)——只重连金属,不动已经做在硅上的晶体管。这篇文章把「凭什么能改、改之前要埋什么、改动怎么落到备用门上、改完怎么签收」四个环节讲透;它在 ECO 传播链中的位置(哪些数据作废、要重签什么)见 X3 ECO 变更传播,组织级收口见 E5 签核闭环与 ECO。
本文要回答的问题
- 金属层 ECO 和普通功能 ECO 的本质差别是什么?为什么它只能改「连线」不能改「器件」?
- spare cell(备用门)在 floorplan 阶段怎么埋、埋多少、埋哪些种类?
- 一个 RTL 级的逻辑修改,是怎样被映射成对几颗备用门的重连的?
- metal-only ECO 的完整工具流程与签收场(LEC、STA、DRC/LVS)长什么样?
- 容量怎么估算,哪些改动 metal-only 根本做不了?
一、金属层 ECO 为什么存在:改动成本的分层
一颗先进工艺的 SoC,全套掩模(mask)几十张,NRE(一次性工程费用)动辄数百万美元。掩模分层两类:base layer(基区层)——有源区、阱、多晶、接触孔,决定了硅上存在哪些晶体管;metal layer(金属层)——M1 到顶层金属加各层通孔,决定这些晶体管怎么互连。改一张 base 掩模,意味着所有叠在它上面的金属层全部作废重做;改几张上层金属掩模,只要重做那几层。这正是 metal-only ECO 的全部意义:在 base 冻结的前提下,用已有的晶体管资源,通过重新连线实现有限的逻辑修改。
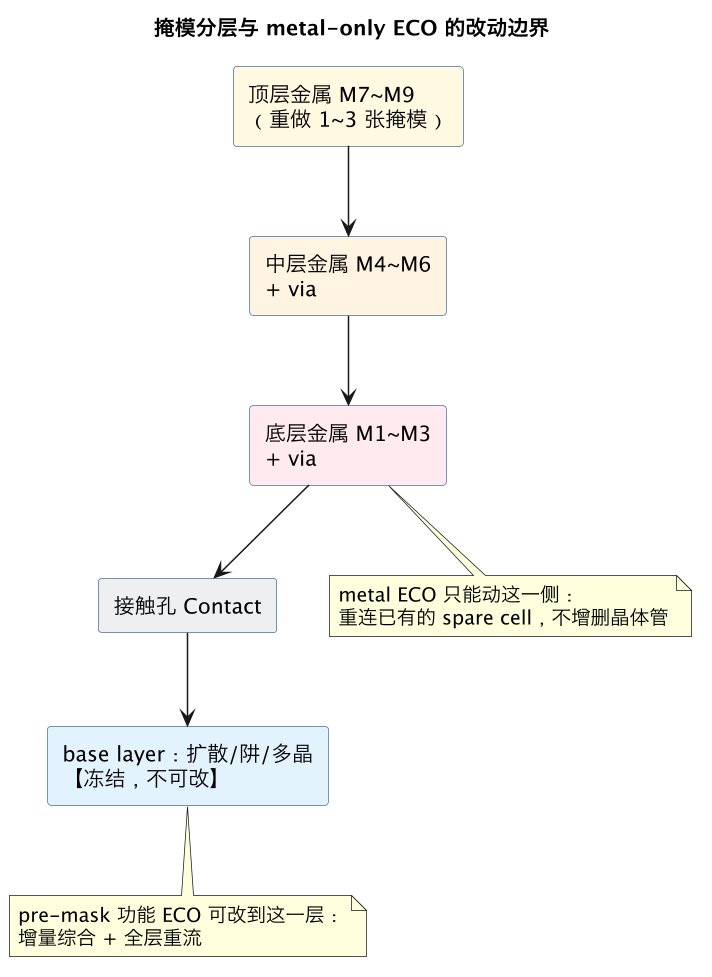
这张图里最关键的是那条无形分界线:contact 以下的一切——晶体管的数量、尺寸、位置——在 base 冻结后就是物理事实。所以 metal-only ECO 的能力上限,在流片之前的 floorplan 阶段就被决定了:你当时埋了多少备用晶体管,日后就有多大的修改余地。用一句行话概括:metal ECO 的弹性不是改出来的,是预埋出来的。
和 pre-mask 功能 ECO 的对比,一张表看清楚:
| 维度 | pre-mask 功能 ECO | post-mask 金属层 ECO |
|---|---|---|
| 可动层级 | 全部层(含 base) | 仅金属/via(通常只动中上层) |
| 可增删晶体管 | 可以 | 不行,只能用已有 spare cell |
| 逻辑改动规模 | 理论上不限 | 受 spare 数量/种类/位置严格限制 |
| 掩模重做 | 全套 | 几张金属掩模,成本差 1~2 个数量级 |
| 周期 | 数周(重综合+重布局布线) | 数天(局部重布线) |
| 工具手段 | 增量综合 + LEC | 网表手工/自动 ECO + ECO route + LEC |
| 典型场景 | 功能修改、RTL bug 修复 | 流片后致命 bug、少量配置/胶合逻辑修改 |
二、spare cell 的预置:在 floorplan 期埋下「后悔药」
spare cell(备用单元,也叫 eco cell、gate array filler)是散布在设计里、输入默认绑到固定电平、输出悬空、当前不参与任何功能的标准单元。它们唯一的作用,就是在 metal ECO 时被征用:把绑定改接、连入真实信号,变成逻辑的一部分。
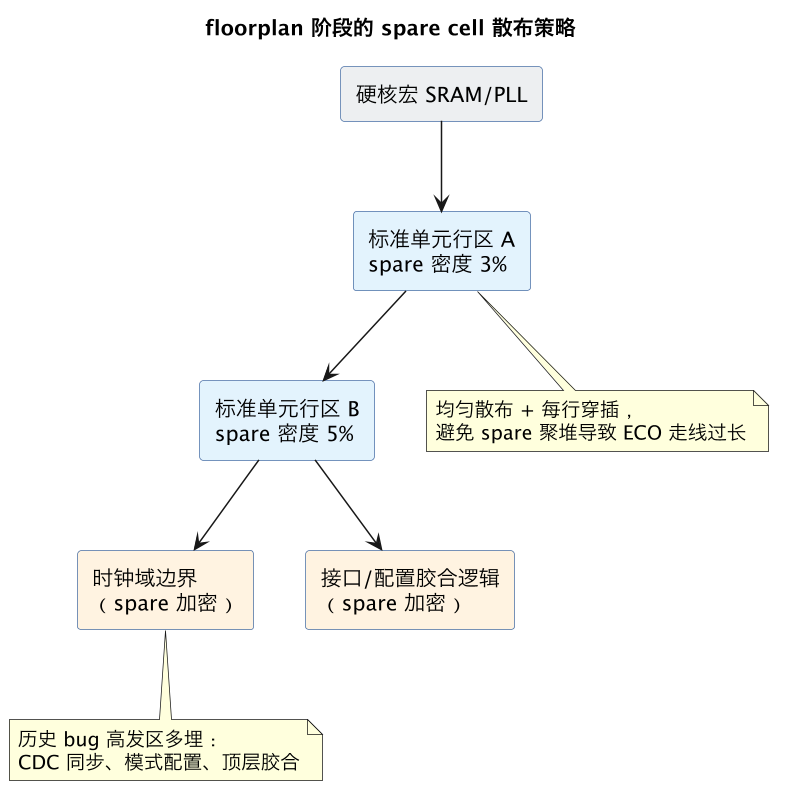
预置方式本身有两条路线,先对比再讲要点:
| 路线 | 做法 | 优点 | 缺点 | 适用 |
|---|---|---|---|---|
| 零散 spare cell | 在每行标准单元间穿插插入备用门 | 面积效率高、离改动点近 | 单点可用类型受限,映射靠运气成分大 | 主流 SoC 默认做法 |
| 门海(gate array)区 | 划一块专用区域铺满基础晶体管阵列,层叠定制金属即成任意门 | 映射自由度高,几乎任意小逻辑都能实现 | 面积效率低、性能差、功耗高 | 高端芯片的关键控制模块旁 |
| 可配置 spare 模块 | 预埋一小片带 MUX 互联的可配置逻辑(类微型 FPGA) | 灵活度最高 | 设计与验证成本大,少见 | 原型风险极高的首硅 |
多数项目用「零散 spare 为主 + 关键模块旁加一小块门海」的混合方案。预置策略的四个要点:
- 数量:行业经验值是标准单元总量的 2%~5%。埋少了改不动,埋多了浪费面积还抬功耗(spare cell 有漏电流)。先进工艺下还会用「可编程 spare 阵列」——一片门海(gate array)区,比零散 spare 的映射成功率高,但面积效率低。
- 种类配比:不能只埋 NAND。经验配比大致是反相器/与非/或非占大头(约六成),复合门(AOI/OAI)约两成,spare DFF(备用触发器)一到两成,再配少量 MUX 和 buffer。其中 spare DFF 最稀缺也最关键——时序逻辑修改(加一级流水、修状态机)没有它根本做不了。
- 分布:均匀散布在每行、每个时钟域、每个电压域内部。ECO 时走线长度直接决定新时序是否可行,离改动点最近的可用 spare 才有价值。时钟门控单元、level shifter 跨域的 spare 也要按域预置。
- 默认绑定:输入绑到 tie-high/tie-low 单元,保证静态功耗可控且不误翻转;这些绑定本身在 ECO 时会被拆掉重接。
布局布线工具(Innovus/ICC2)都有 placeSpareCell/add_spare_cells 一类命令,在 placement 阶段插入并 legalize;CTS 之后还可以给 spare DFF 挂默认时钟,缩短 ECO 时的时钟树修补量。
三、spare cell 映射:从逻辑改动锥到几颗备用门
metal ECO 的核心技术问题是映射:RTL 改了一行,功能锥(cone of logic)变了,如何把这堆新逻辑塞进现成的 spare cell 里。流程分四步:
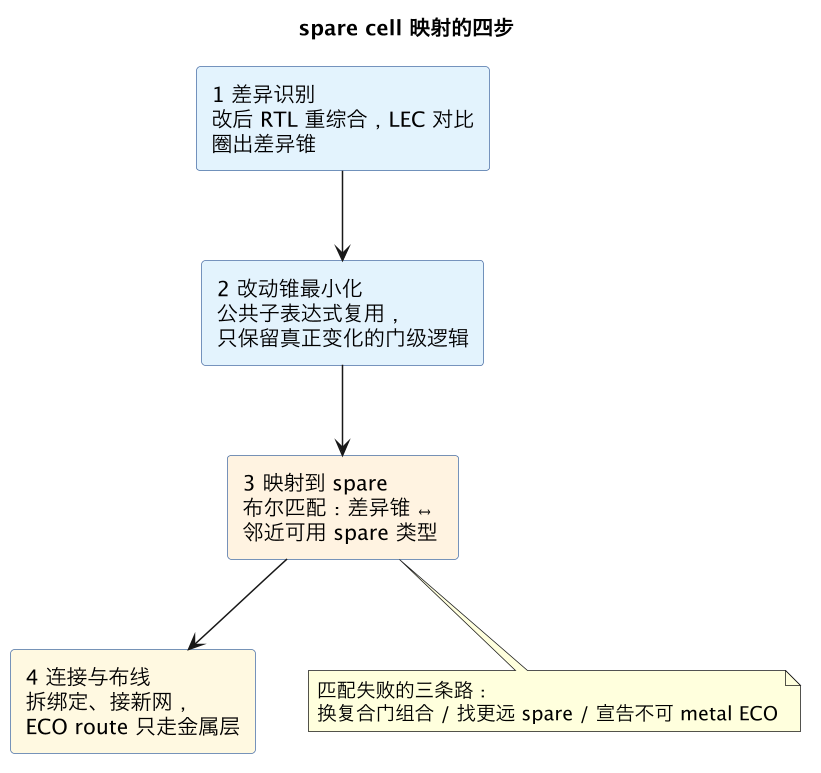
第一步差异识别:把修改后的 RTL 快速综合(用与冻结网表同一套库),和冻结网表做 LEC,工具自动圈出不等价的比较点,回溯出差异锥。这一步决定改动规模——差异锥里几十个门,metal ECO 大概率做得动;几百个门,就要认真评估了。
第二步改动锥最小化:差异锥里往往有大量逻辑和原网表功能等价,可以复用原有实现,只把真正新增/变化的部分切出来。Primetime ECO(pt_eco)、Conformal ECO 这类工具做的就是这件事:用形式化方法把改动压缩到最小门数。
第三步映射:把最小改动锥的布尔函数,匹配到改动点附近可用的 spare cell 类型上。一个两输入异或,可以是一颗 spare XOR,也可以是两颗 spare NAND 加一颗 NOR 拼出来。工具的映射引擎会做布尔分解与局部搜索;约束是 spare 的驱动能力要满足新负载,距离要满足新时序。这就是为什么预置时种类配比很重要——映射是「拿着零件清单修车」,清单里没有的零件,再好的算法也变不出来。
举一个最小的真实感例子:验证发现某个使能信号少了一个反相,正确逻辑应是 en = !(req & gnt)。如果附近恰好有一颗 spare NAND2 加一颗 spare INV,映射就直连完成;如果没有 INV,工具会退而求其次——用一颗 spare NAND2 把两输入并接当反相器用,或者用一颗 NOR2 把一输入绑低。再极端一点,附近只有 AOI22,工具也能通过把多余输入绑到常量、复用其内部的与非结构凑出目标函数。这个「拿着现有零件拼布尔式」的过程,正是映射引擎在每轮 ECO 里自动做、而工程师必须人工复核的地方——拼法可能引入意想不到的毛刺路径和额外延迟。
第四步连接:拆掉 spare 原来的 tie 绑定,把新网(net)接上去,用 ECO route 在指定金属层内完成走线,同时不许产生新 DRC 违例。工具通常限定只动 M3 及以上金属,避免触碰底层的 dense 布线区。ECO 脚本里常见的形态是:
# Innovus 侧:启用 spare 并重连
ecoChangeCell -inst spare_u_1023 -cell NAND2X1
disconnectNet -inst spare_u_1023 -pin A
connectNet -inst spare_u_1023 -pin A -net n_req_eco
ecoRoute -fix_drc -layers {3 4 5}这些命令的最终产物不是新网表从零布线,而是在冻结数据库上做增量手术:未动区域的placement和routing一字节不变,只有改动锥附近的金属被局部撕开重连。这也是为什么metal ECO能把周期压到几天——它复用了全部未受影响区域的既有物理实现与签收结果。
四、完整工具流程与签收
一轮 metal-only ECO 从 bug 确认到交出改版 GDS,标准动作如下:
- 冻结基线确认:锁定当前 GDS、网表、SPEF、SDC 版本(版本纪律见 F10 版本基线),ECO 一切数据都基于这份基线派生。
- RTL 修改 + 快速综合 + LEC 差异识别:得到最小改动锥(上节四步)。
- 网表 ECO:工具输出 ECO 网表(只含增量变化的 Verilog 或 ECO 脚本),人工 review——自动 ECO 的网表可读性差,关键改动必须人眼确认。
- 物理实现:在 P&R 数据库里执行 ECO place(把被征用的 spare 就地启用)+ ECO route(限定金属层局部重布),输出改动层的 GDS/OASIS。
- 签收四件套:
- LEC:ECO 后网表 vs 改后 RTL,必须全等价(这是功能的最后防线);
- STA:重提改动区域 SPEF,多角多模式(MMMC)重签时序,重点看新走线引入的 delay 和串扰(signoff STA);
- 物理验证:改动层重跑 DRC/LVS(Calibre),天线效应重查;
- 功耗/IR:新增开关活动可能改变局部 IR drop,必要时重跑向量无关分析。
整个传播链——一份 RTL 修改让哪些数据作废、要按什么顺序重签——就是 X3 ECO 变更传播 里 metal-only ECO 分支的内容。和 pre-mask ECO 相比,metal ECO 的物理验证范围小得多(只动几层),但验证一项都不能省:历史上不缺「ECO 改对了逻辑、改出了天线违例」的流片事故。
还有一条容易漏的验证是门级仿真回归:改动锥涉及的复位序列、DFT 移位、低功耗切换用例,要拿 ECO 后网表 + 重提 SDF 重跑精选子集(方法见 网表交付、门级仿真与 ECO 第三节)。metal ECO 的手工成分重,LEC 证明的是「网表与改后 RTL 等价」,但证明不了「改后 RTL 本身没有引入新的功能 bug」——仿真回归兜的是这后半句。最后,所有改版层的 GDS 与对应签收报告要打上新的 ECO 轮次标签归档,下一版全层重流时必须把这些 ECO 合并回主线数据库,否则同一颗芯片会分裂成两套物理真相。
五、容量估算与 metal-only 的边界
要不要启动 metal ECO,第一道算术题是容量:
| 检查项 | 估算方法 | 经验门槛 |
|---|---|---|
| 改动门数 | LEC 差异锥综合后门数 | ≤ 改动模块 spare 总量的 30% |
| 触发器需求 | 差异锥内 DFF 数量 | ≤ 邻近 spare DFF 数量(最硬约束) |
| 距离 | 改动点到可用 spare 的曼哈顿距离 | 新走线 delay 不影响时序余量 |
| 时钟 | spare DFF 的时钟域是否匹配 | 跨时钟域基本不可行 |
| 电压域 | spare 是否在同一电源域 | 跨域需 level shifter,多数放弃 |
实践里还有几个反复踩到的坑值得点名。其一,spare DFF 的时钟:如果预埋时没给 spare DFF 挂默认时钟,ECO 时要从最近的时钟树干上引一段新时钟线,这段线的 skew 没人保证,很容易造出 hold 违例——所以预置阶段挂时钟是花小钱省大麻烦。其二,串扰:ECO 新走线往往被迫贴着已有的密集信号走,si 窗口收紧,重签 STA 时必须开 signal integrity 而不是只看名义延迟。其三,多次 ECO 叠加:同一区域改过两轮之后,局部金属资源已经七零八落,第三轮几乎必然失败——所以 ECO 轮次要严格控制,改不动的尽早下决心全层重流。其四,spare 被优化掉:综合和 P&R 的优化 pass 默认会把「输入绑常量、输出悬空」的逻辑当冗余删掉,spare cell 必须显式 set_dont_touch / 标 eco 属性保护起来,否则到用的时候才发现埋的门早被工具清空了。
以下改动 metal-only ECO 基本做不了,不要硬上:
- 需要新增大量寄存器的数据通路修改(spare DFF 远远不够);
- 改 SRAM/模拟宏内部逻辑(宏是硬核,里面没有 spare);
- 改时钟树结构、加电源域、改 pad/IO——都涉及 base 层或封装;
- 差异锥上千门的大规模功能变更。
做不了怎么办?两条退路:全层重流(base 重流片,贵但彻底);或者软件/固件绕行——很多控制类 bug 最后是靠固件打补丁绕过去的,这也是为什么可编程性设计(寄存器旁路、功能开关)在架构期就要考虑。metal ECO 的真正定位是:为那类「几十到几百个门、不改寄存器规模」的致命缺陷,留一条数天周期、几十万级成本的救急通道。
这一篇在知识体系里的位置
本篇是 EDA signoff 线里「流片后改版」专题,承接上游与横向:
- 上游预埋:floorplan 与电源规划 决定了 spare cell 的密度与分布——本篇第二节是它的「售后说明」;
- 同线基础:网表交付、门级仿真与 ECO(C5)讲清 pre-mask/post-mask 两类 ECO 的分野,本篇是 post-mask 分支的纵深展开;
- 验证兜底:LEC、signoff STA、Calibre 物理验证、MMMC 寄生;
- 数据流视角:X3 ECO 变更传播、S5 signoff 收敛、E5 签核闭环。
总结
金属层 ECO 是 base 层冻结后只重连金属、不动晶体管的救急改版:它的能力上限在 floorplan 期就由 spare cell 的数量、种类配比(反相/与非/或非为主、复合门为辅、备用 DFF 最稀缺)和均匀散布策略决定;一轮改版走「改后 RTL 快速综合 + LEC 圈差异锥、改动锥最小化、布尔映射到邻近 spare、拆绑定做限定层 ECO 走线」四步,签收时 LEC 等价、多角 STA、改动层 DRC/LVS、IR 四项一项不能省;它只兜得住几十到几百门、不新增寄存器规模的致命缺陷,改 SRAM/时钟树/电源域或大规模功能变更都得全层重流或固件绕行——metal ECO 的弹性不是改出来的,是预埋出来的。